10. 모델 추론과 서빙: 실습 기록
10. 모델 추론과 서빙에서 정리한 내용을 책의 코드로 직접 실행한 기록이다. 개념과 요점은 본문에 두고, 여기에는 명령, 실제 출력과 화면만 모았다.
실습 순서
책의 순서를 따른다. 탐지 서비스를 BentoML로 띄워 Bento로 묶고, 추천 모델을 MLflow와 연결해 서빙한 뒤, MLflow만으로도 서빙해 본다. 마지막으로 KServe로 클러스터에 배포했다가 되돌린다. 아래 출력과 화면은 2026년 11월 8일에 이 순서대로 실행해 얻은 것이다.
    flowchart LR
    accTitle: 10장 실습 순서
    accDescr: 환경과 저자 코드를 준비한 뒤 BentoML 1.1 탐지 서비스를 저자 코드와 고친 코드로 실행하고 Bento로 빌드한다. 이어 9장 추천 모델을 MLflow 별칭으로 읽는 BentoML 1.4 서비스와 MLflow 단독 서빙을 확인한다. 마지막으로 KServe를 설치해 탐지 모델을 InferenceService로 배포하고 잘못된 릴리스를 되돌린 뒤 정리한다.
    A["A. 환경과 코드 준비"] --> B["B. BentoML 탐지 서비스"]
    B --> C["C. Bento 빌드"]
    A --> D["D. BentoML과 MLflow<br/>추천 서비스"]
    D --> E["E. MLflow만으로 서빙"]
    B --> F["F. KServe 배포와 롤백"]
    C --> G["G. 문제 해결과 정리"]
    E --> G
    F --> G
| 구간 | 끝났을 때 남는 것 |
|---|---|
| A. 환경과 코드 준비 | 저자 코드 두 저장소, 가상환경 두 개, MLflow의 8장과 9장 모델 확인 |
| B. BentoML 탐지 서비스 | ch10\yolo-fixed\의 가중치와 model_info.json, 저자 서비스와 고친 서비스의 응답 비교 |
| C. Bento 빌드 | Bento yolo_v8:<태그> 두 개, Bento 태그로 띄운 서비스의 지표 |
| D. BentoML과 MLflow 추천 서비스 | 등록 모델 ch10-recommender v1, v2와 prod 별칭, 고친 추천 서비스, Bento recommender_service:<태그> |
| E. MLflow만으로 서빙 | 등록 모델 ch10-recommender-pyfunc v1과 prod 별칭, /invocations 응답 |
| F. KServe 배포와 롤백 | kserve 네임스페이스의 컨트롤러, ch10-models 버킷, ch10-serving의 ch10-detector, 출시 기록 |
| G. 문제 해결과 정리 | 멈춘 서버와 지운 리소스, 남겨 둘 기록 |
B, C와 D, E는 서로 독립이고, F는 B-1의 가중치만 있으면 된다. 명령은 ml-platform-book-env 저장소 최상위 폴더의 PowerShell에서 실행한다고 가정한다. 이 장에서 만드는 파일은 ch10\, 저자 코드는 upstream\에 둔다. 서버를 띄우는 명령은 별도 터미널에서 실행하고 Ctrl+C로 멈춘다.
A. 환경과 코드 준비
8~9장이 레지스트리에 남긴 모델을 확인한다. 전체 그림의 ①, ④를 준비하는 단계다.
A-1. 클러스터와 모델 확인
4장 A-2, A-3과 같이 클러스터를 설치하고 두 번째 터미널에서 포트포워딩을 켜 둔다. MLflow(5000)와 S3 API(9000)를 쓴다.
python bookenv.py status
python bookenv.py forward
http://localhost:5000 의 Models에
ch08-id-card-detector(8장 G)와ch09-recommender(9장 E-2)가 있는지 본다. 이번 실습 시점의 상태는 아래와 같았다.등록 모델 버전 원천 태그와 별칭 ch08-id-card-detector1 runs:/74f605c4.../train_run/weightsrelease_decision: hold,manual_review: fail: blur, small, darkch09-recommender1, 2 run 615d3f32...,c1252d6c...staging→ 28장 모델의 원천은 MLflow 모델 형식이 아니라 가중치 폴더다. 레지스트리에 있어도
mlflow models serve로 바로 띄울 수는 없어서, 탐지 모델은 BentoML과 KServe로만 서빙한다.
A-2. 저자 코드
10장 코드는 8~9장 저장소의 serving 폴더에 있다. 9장에서 받은 저장소가 있어도, 9장에서 고친 파일과 섞이지 않게 새로 받는다.
git clone https://github.com/practical-mlops/object-detection-project.git upstream/ch10-object-detection
git -C upstream/ch10-object-detection checkout c6afb11
git clone https://github.com/practical-mlops/movie-recommender-project.git upstream/ch10-movie-recommender
git -C upstream/ch10-movie-recommender checkout 4e0a808
탐지 쪽 serving\에는 service.py, bentofile.yaml, requirements.txt(ultralytics 8.0.194)와 저자가 학습한 yolov8_custom.pt가, 추천 쪽 serving\에는 service.py, metrics.py, bentofile.yaml, requirements.txt가 있다.
A-3. 가상환경 두 개
두 서비스가 쓰는 BentoML API와 파이썬 버전이 다르므로 환경을 나눈다.
- 탐지 서비스용. BentoML 1.1 계열, 8장 실습과 같은 ultralytics와 torch를 쓴다.
uv venv .venv-ch10-yolo --python 3.10 uv pip install --python .venv-ch10-yolo "bentoml==1.1.10" "setuptools<70" "click==8.1.7" ` ultralytics==8.3.40 torch==2.5.1 torchvision==0.20.1 numpy==1.26.4 "opencv-python<4.12" ` mlflow-skinny==3.0.0 boto3 ` --extra-index-url https://download.pytorch.org/whl/cpu --index-strategy unsafe-best-matchsetuptools<70과click==8.1.7은 6장 A-4와 같은 이유다. 책의 1.1.6 대신 1.1.10을 쓰는 이유는 앞에서 설명했다. - 추천 서비스용. 9장 학습과 같은 Python 3.9, PyTorch 2.8.0을 쓴다.Windows용 PyPI torch 휠은 CPU 빌드라 별도 인덱스가 필요 없다. 실습 당시
uv venv .venv-ch10-rec --python 3.9 uv pip install --python .venv-ch10-rec bentoml==1.4.40 torch==2.8.0 mlflow==3.0.0 greenlet==3.1.1 boto3 pandas pyarrowdownload.pytorch.org는 초당 40KB 안팎으로 느렸고 PyPI는 초당 1MB 이상이었다. - 두 환경 모두 BentoML 저장소를 이 실습 전용으로 쓰도록 터미널마다 지정한다.
$env:BENTOML_HOME = "$PWD\ch10\bentoml-home"
$env:YOLO_CONFIG_DIR = "$PWD\ch10\yolo-config"
완료 기준: .\.venv-ch10-yolo\Scripts\bentoml.exe -v가 1.1.10, .\.venv-ch10-rec\Scripts\python.exe -c "import bentoml, torch; print(bentoml.__version__, torch.__version__)"가 1.4.40 2.8.0+cpu를 출력한다.
B. BentoML 탐지 서비스
책 10.310.4를 따라 전체 그림의 ①②를 만든다.
B-1. 레지스트리에서 가중치 가져오기
책은 yolov8_custom.pt를 서비스 폴더에 두라고만 한다. 어느 버전인지 남기지 않으면 나중에 어떤 모델이 응답했는지 추적할 수 없으니, 가중치와 함께 버전 정보 파일을 만든다.
ch10\fetch_detector.py를 만든다.import hashlib, json, os, sys os.environ.setdefault("MLFLOW_S3_ENDPOINT_URL", "http://127.0.0.1:9000") os.environ.setdefault("AWS_ACCESS_KEY_ID", "minio") os.environ.setdefault("AWS_SECRET_ACCESS_KEY", "minio123") import mlflow from mlflow import MlflowClient name, version, out_dir = sys.argv[1], sys.argv[2], sys.argv[3] mlflow.set_tracking_uri("http://127.0.0.1:5000") mv = MlflowClient().get_model_version(name, version) path = mlflow.artifacts.download_artifacts(f"models:/{name}/{version}/best.pt", dst_path=out_dir) target = os.path.join(out_dir, "yolov8_custom.pt") os.replace(path, target) sha = hashlib.sha256(open(target, "rb").read()).hexdigest() info = {"registered_model": name, "version": mv.version, "run_id": mv.run_id, "source": mv.source, "tags": mv.tags, "sha256": sha} json.dump(info, open(os.path.join(out_dir, "model_info.json"), "w"), indent=2) print(json.dumps(info, indent=2))- 실행한다.
New-Item -ItemType Directory -Force ch10\yolo-fixed | Out-Null
.\.venv-ch10-yolo\Scripts\python.exe ch10\fetch_detector.py ch08-id-card-detector 1 ch10\yolo-fixed
{ "registered_model": "ch08-id-card-detector", "version": "1", "run_id": "74f605c4bb544d50bf88abf3500c587b", "source": "runs:/74f605c4bb544d50bf88abf3500c587b/train_run/weights", "tags": {"kfp_val_map50_95": "0.919", "manual_review": "fail: blur, small, dark", "release_decision": "hold"}, "sha256": "d8c5a0d2bf8f7207f95166cfd41b8610d2038a0a698008c6c9682e7f029791a9" } - 시험 이미지를 준비한다. 8장 F-2에서 학습에 쓰지 않은 표본을 모아 둔
ch08\samples\의 합성 신분증 두 장을 옆으로 붙여 카드가 두 장인ch10\two_cards.jpg를 만들고, 카드가 없는neg01.jpg, 5000x4000 단색huge.png도 함께 쓴다..\.venv-ch10-yolo\Scripts\python.exe -c "from PIL import Image; a=Image.open('ch08/samples/clip02_f00.jpg'); b=Image.open('ch08/samples/clip00_f00.jpg'); c=Image.new('RGB',(a.width*2,a.height)); c.paste(a,(0,0)); c.paste(b,(a.width,0)); c.save('ch10/two_cards.jpg', quality=92); Image.new('RGB',(5000,4000),(90,140,120)).save('ch10/huge.png')"
B-2. 저자 서비스 그대로 실행
저자의
serving폴더를 복사하고 가중치만 B-1의 파일로 바꾼다.New-Item -ItemType Directory -Force ch10\yolo-serving | Out-Null Copy-Item upstream\ch10-object-detection\serving\* ch10\yolo-serving\ Copy-Item ch10\yolo-fixed\yolov8_custom.pt ch10\yolo-serving\ -Force cd ch10\yolo-serving ..\..\.venv-ch10-yolo\Scripts\bentoml.exe serve service.py:svc --port 301010초 정도 뒤
/readyz가 200이 된다. 로그에는Using lowercased runnable class name 'yolov8runnable' for runner.가 API 서버마다 찍힌다. 작업 관리자에서 보면 API 서버 프로세스 16개와 Runner 프로세스 1개가 떠 있다.http://127.0.0.1:3010 의 Swagger UI에서 POST /invocation → Try it out을 누르고, 형식을
image/jpeg로 고른 뒤two_cards.jpg를 올려 Execute한다. 카드가 두 장인데 박스가 하나만 온다.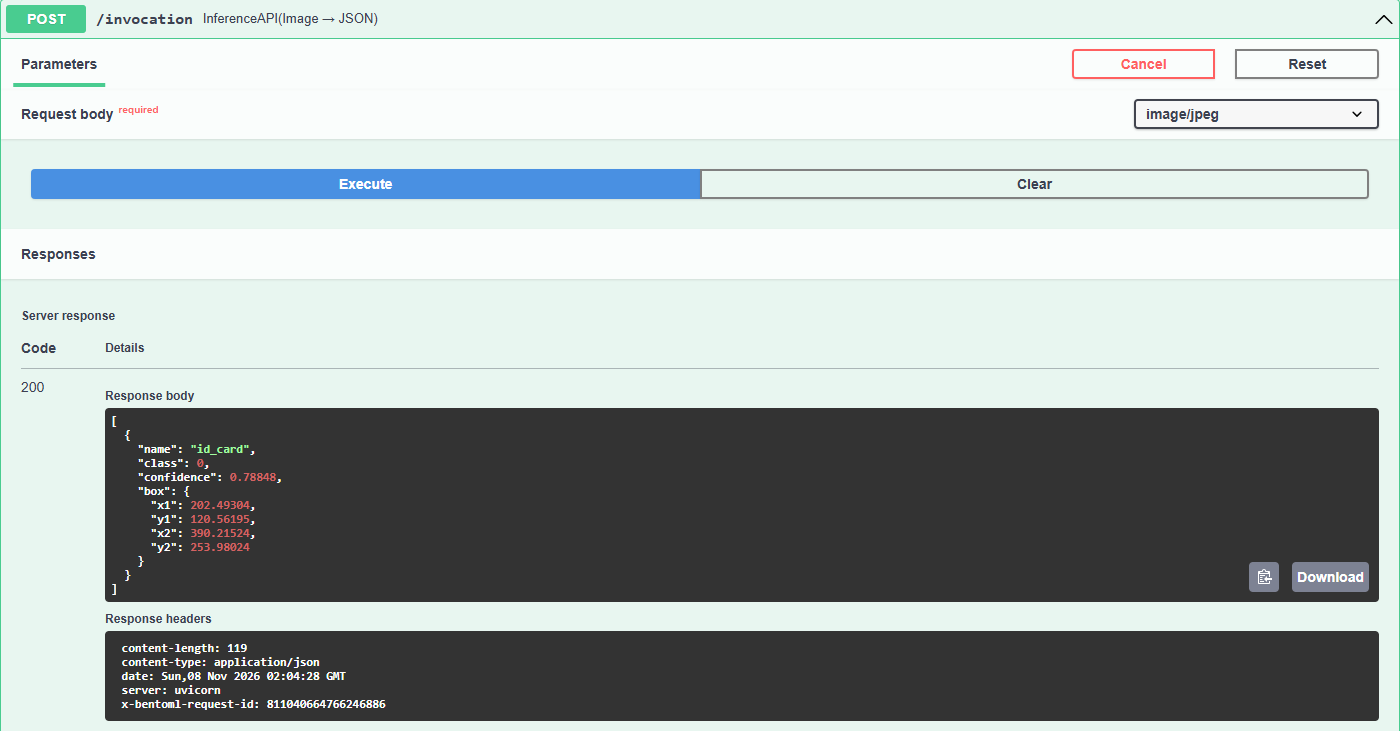
같은 이미지를 POST /render로 보내면 응답 본문에 Download file 링크가 생긴다(책의 그림 10.5).
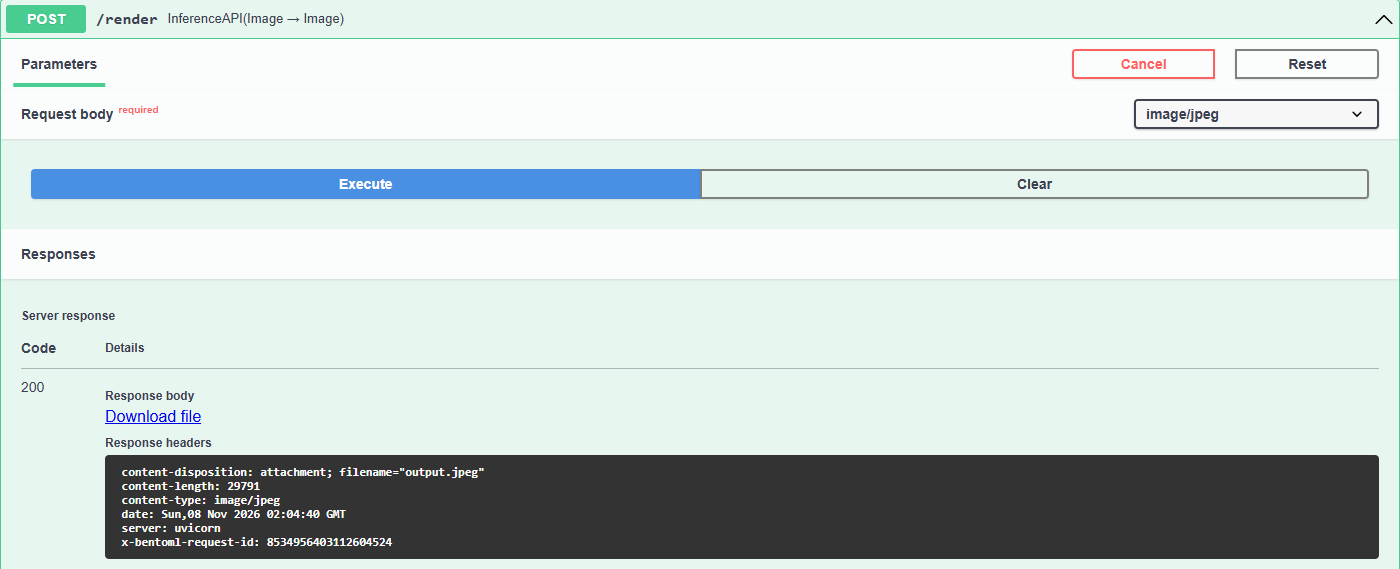
내려받은 이미지에는 박스가 두 개 그려져 있다. 같은 모델, 같은 이미지인데 두 엔드포인트의 답이 다르다.
다른 터미널에서 카드가 없는 이미지를 보낸다.
curl.exe -s -w " [%{http_code}]`n" -X POST -H "Content-Type: image/jpeg" --data-binary "@ch08\samples\neg01.jpg" http://127.0.0.1:3010/invocation"" [500]서버 로그의 마지막 줄은
IndexError: index 0 is out of bounds for dimension 0 with size 0이다./render를 몇 번 부른 뒤ch10\yolo-serving을 보면predict,predict2,predict3… 폴더가 요청 수만큼 생겨 있다. 확인했으면 서버를 멈추고 이 폴더들을 지운다.
B-3. 고친 서비스
요청 검증과 응답 계약에서 정리한 문제를 고친다. 구조(Runner 하나, API 둘)와 엔드포인트 이름은 책과 같다.
ch10\yolo-fixed\service.py:
import io
import json
import os

import bentoml
import PIL.Image
from bentoml.exceptions import BadInput
from bentoml.io import JSON, Image
from ultralytics import YOLO

HERE = os.path.dirname(os.path.abspath(__file__))
MODEL_INFO = json.load(open(os.path.join(HERE, "model_info.json")))
MODEL_LABEL = f"{MODEL_INFO['registered_model']}/{MODEL_INFO['version']}"
MAX_PIXELS = 4096 * 4096


class YOLOv8Runnable(bentoml.Runnable):
    SUPPORTED_RESOURCES = ("cpu",)
    SUPPORTS_CPU_MULTI_THREADING = True

    def __init__(self):
        self.model = YOLO(os.path.join(HERE, "yolov8_custom.pt"))
        self.model.cpu()

    @bentoml.Runnable.method(batchable=False)
    def inference(self, input_img):
        result = self.model(input_img, verbose=False)[0]
        # every box, and [] when nothing is detected
        return json.loads(result.to_json())

    @bentoml.Runnable.method(batchable=False)
    def render(self, input_img):
        result = self.model(input_img, verbose=False)[0]
        # draw in memory instead of saving predictN/ folders on every request.
        # The runner is another process, so the image needs a format to be sent back.
        buf = io.BytesIO()
        PIL.Image.fromarray(result.plot()[..., ::-1]).save(buf, format="JPEG")
        buf.seek(0)
        return PIL.Image.open(buf)


yolo_v8_runner = bentoml.Runner(YOLOv8Runnable, name="yolov8_runnable")
svc = bentoml.Service("yolo_v8", runners=[yolo_v8_runner])


def check(img: PIL.Image.Image, ctx: bentoml.Context) -> PIL.Image.Image:
    if img.width * img.height > MAX_PIXELS:
        raise BadInput(f"image too large: {img.width}x{img.height}")
    ctx.response.headers["x-model-version"] = MODEL_LABEL
    return img.convert("RGB")


@svc.api(input=Image(), output=JSON())
async def invocation(input_img, ctx: bentoml.Context):
    return await yolo_v8_runner.inference.async_run([check(input_img, ctx)])


@svc.api(input=Image(), output=Image())
async def render(input_img, ctx: bentoml.Context):
return await yolo_v8_runner.render.async_run([check(input_img, ctx)])render가 PIL.Image.fromarray(...)를 그대로 돌려주면 ValueError: unknown file extension으로 500이 난다. Runner가 결과를 API 서버로 보내려고 이미지를 직렬화할 때 image.format을 쓰는데, 메모리에서 만든 이미지에는 그 값이 없다. JPEG로 한 번 인코딩해 다시 연 이미지를 돌려주면 형식이 붙는다.
B-4. 응답, 상태 경로, 지연 확인
고친 서비스를 띄운다. 이번에는 API 서버를 둘만 띄운다.
cd ch10\yolo-fixed
..\..\.venv-ch10-yolo\Scripts\bentoml.exe serve service.py:svc --port 3011 --api-workers 2
다른 터미널에서 시작 직후부터
/livez와/readyz를 0.3초 간격으로 확인하면, 한동안 연결 거부(000)였다가 두 경로가 함께 200이 된다.0.3s livez=000 readyz=000 30.2s livez=200 readyz=200다른 작업이 함께 돌던 이번 측정은 30.2초였고, 한가할 때는 10초 남짓이었다.
Swagger에서 B-2와 같이
two_cards.jpg를 보낸다. 박스 두 개와x-model-version: ch08-id-card-detector/1헤더가 온다. 아래 화면은 C-2에서 같은 코드를 Bento 태그로 띄운 뒤 찍은 것이다.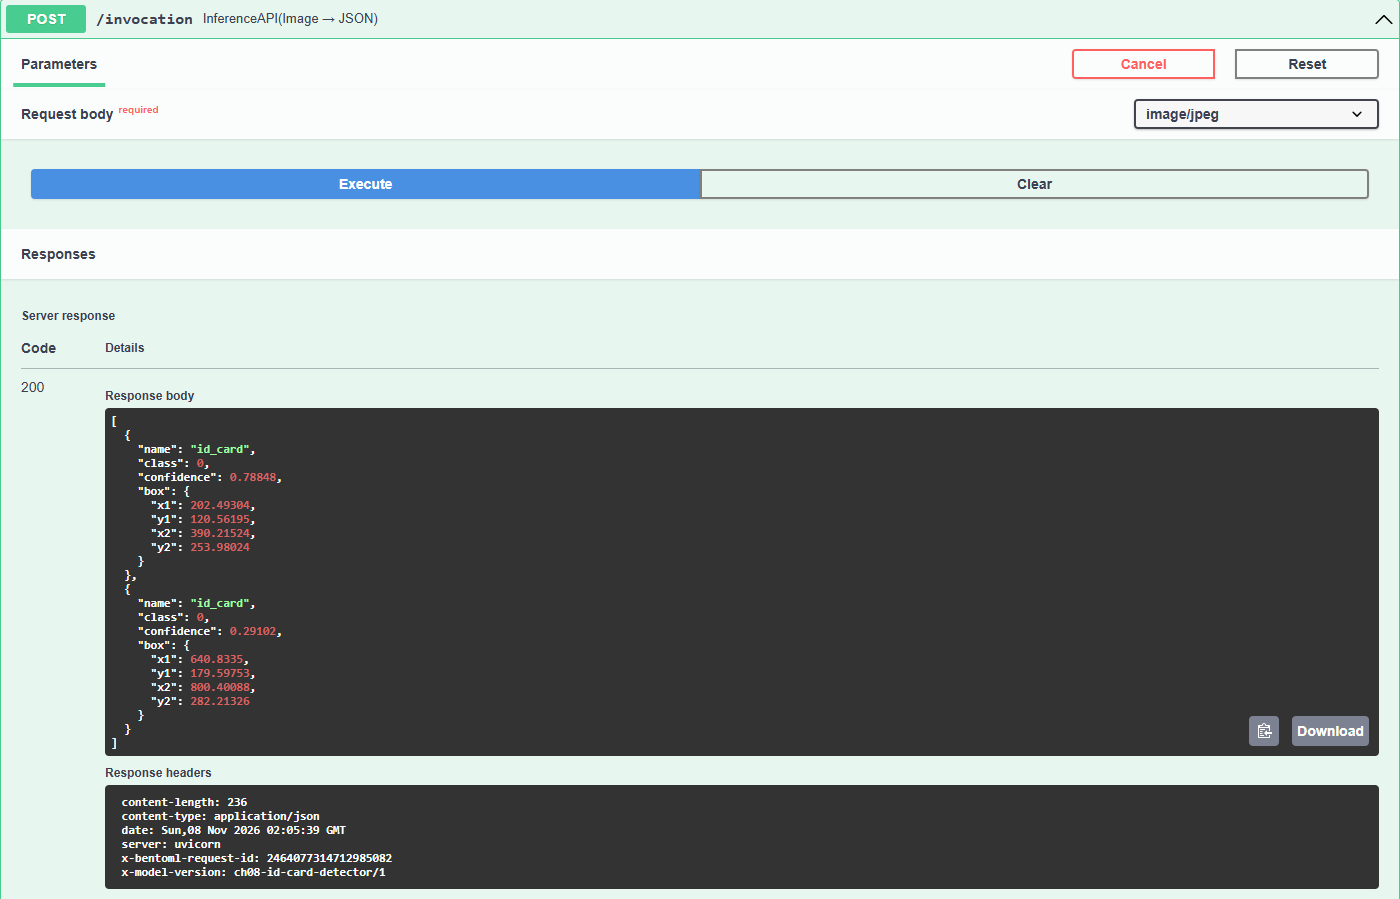
/render의 결과 이미지는 아래와 같다. 오른쪽 카드는 신뢰도 0.29로, 기본 신뢰도 문턱(0.25)을 겨우 넘었다.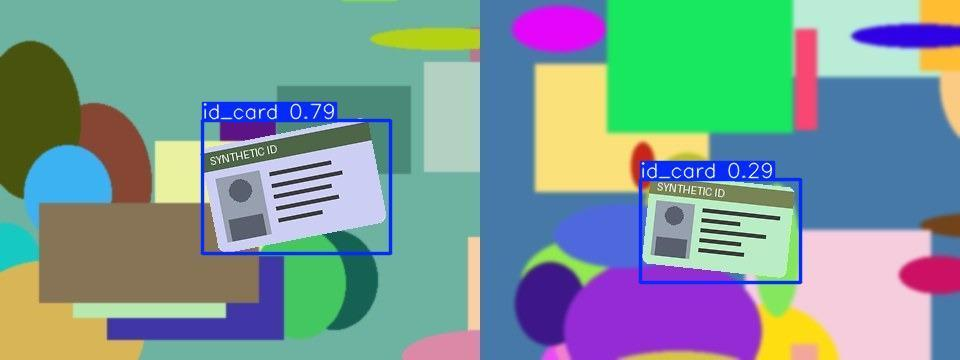
잘못된 입력을 보낸다.
curl.exe -s -w " [%{http_code}]`n" -X POST -H "Content-Type: image/jpeg" --data-binary "@ch08\samples\neg01.jpg" http://127.0.0.1:3011/invocation
curl.exe -s -w " [%{http_code}]`n" -X POST -H "Content-Type: image/png" --data-binary "@ch10\huge.png" http://127.0.0.1:3011/invocation
curl.exe -s -w " [%{http_code}]`n" -X POST -H "Content-Type: image/jpeg" --data "not an image" http://127.0.0.1:3011/invocation
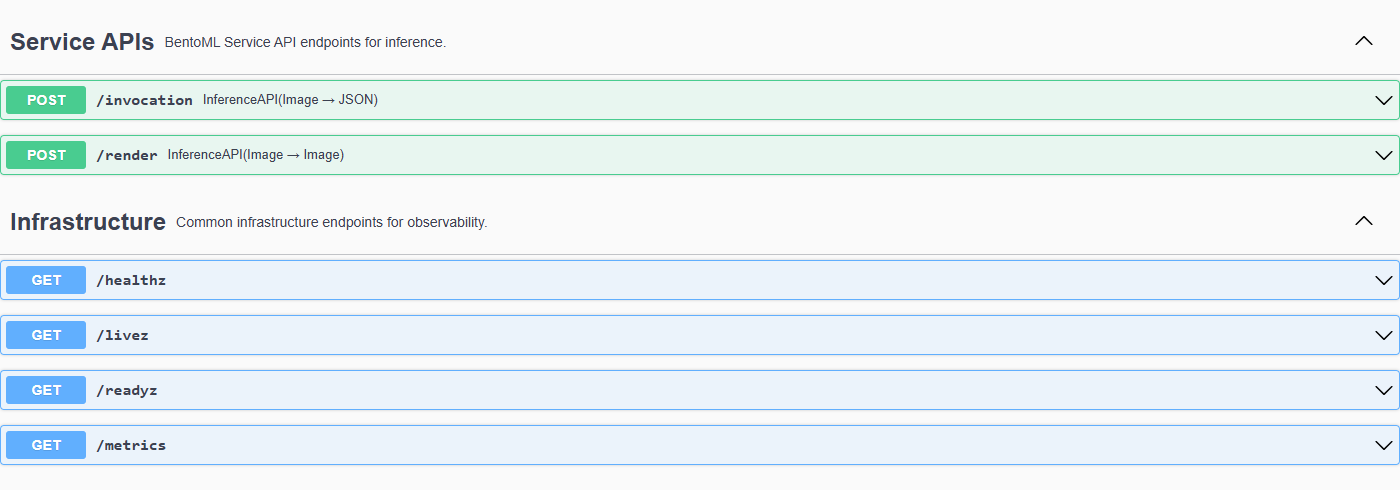
[] [200] "BentoService error handling API request: image too large: 5000x4000" [400] "BentoService error handling API request: Failed to parse uploaded image file: cannot identify image file <_io.BytesIO object at 0x...>" [400]Swagger 페이지 아래쪽의 Infrastructure 묶음이 책의 그림 10.7에 해당하는 상태 경로다.
지연을 잰다.
ch10\loadtest.py는 같은 이미지를 동시 요청 수를 바꿔 40건씩 보낸다.import time, urllib.request, statistics, concurrent.futures as cf, sys data = open("ch10/two_cards.jpg", "rb").read() url = sys.argv[1] def call(_): t = time.perf_counter() req = urllib.request.Request(url, data=data, headers={"Content-Type": "image/jpeg"}) urllib.request.urlopen(req).read() return (time.perf_counter() - t) * 1000 for conc in (1, 4, 8): n = 40 t0 = time.perf_counter() with cf.ThreadPoolExecutor(conc) as ex: lat = sorted(ex.map(call, range(n))) wall = time.perf_counter() - t0 print(f"concurrency={conc:<2} n={n} p50={statistics.median(lat):6.1f}ms " f"p95={lat[int(n*0.95)-1]:6.1f}ms throughput={n/wall:5.1f} req/s").\.venv-ch10-yolo\Scripts\python.exe ch10\loadtest.py http://127.0.0.1:3011/invocationconcurrency=1 n=40 p50= 36.0ms p95= 50.8ms throughput= 25.9 req/s concurrency=4 n=40 p50= 64.3ms p95= 430.9ms throughput= 30.5 req/s concurrency=8 n=40 p50= 59.6ms p95=1149.4ms throughput= 33.1 req/s이 측정은 C-2에서 Bento 태그로 띄운 같은 서비스에 대한 것이다. 해석은 배치와 지연에 적었다.
완료 기준: two_cards.jpg에 박스 두 개, neg01.jpg에 []와 200, huge.png에 400이 오고, ch10\yolo-fixed에 predict 폴더가 생기지 않는다.
C. Bento 빌드
③에 해당하는 책 10.5를 따라간다.
C-1. 저자 bentofile로 빌드
cd ch10\yolo-serving
..\..\.venv-ch10-yolo\Scripts\bentoml.exe build
Using lowercased runnable class name 'yolov8runnable' for runner.
BentoML will not install Python to custom base images; ensure the base image 'ultralytics/ultralytics:8.0.203-cpu' has Python installed.
...
Successfully built Bento(tag="yolo_v8:rkfmjl63dcwtflaz").경고가 말하듯 기반 이미지를 직접 지정하면 BentoML은 파이썬과 패키지를 그 이미지에 맡긴다. bentoml-home\bentos\yolo_v8\rkfmjl63dcwtflaz\env\docker\Dockerfile의 첫 줄은 FROM ultralytics/ultralytics:8.0.203-cpu as base-container이고, 설치하는 파이썬 패키지 목록 파일은 없다.
책의 1.1.6으로 빌드하면 같은 명령이 Successfully built를 출력하지만, 이어서 bentoml list와 bentoml get이 KeyError: 'name'으로 실패한다. 만들어진 bento.yaml에 name과 version 항목이 없다. 1.1.10으로 올려 다시 빌드하면 정상이다.
C-2. 고친 bentofile로 빌드하고 태그로 실행
ch10\yolo-fixed\bentofile.yaml을 만든다. 포함할 파일에 버전 정보를 넣고, 패키지를 고정하고, 라벨에 모델 버전을 적는다.service: "service.py:svc" labels: owner: ch10 model: ch08-id-card-detector model_version: "1" include: - "service.py" - "yolov8_custom.pt" - "model_info.json" python: packages: - ultralytics==8.3.40 - torch==2.5.1 - torchvision==0.20.1 - numpy==1.26.4 - opencv-python<4.12 lock_packages: false extra_index_url: - https://download.pytorch.org/whl/cpu docker: python_version: "3.10" system_packages: - libgl1 - libglib2.0-0lock_packages: false는 디스크 때문이다. 1.1의 기본값(true)은 빌드할 때pip-compile로 의존성을 잠그는데, 이때 torch를 포함한 휠을 실제로 내려받는다. 실습 중 이 단계가 몇 분 동안 임시 폴더를 키워 중단했다. 버전을 모두==로 적었으므로 잠그지 않아도 설치 결과의 차이는 하위 의존성에 한정된다.- 빌드하고 목록을 본다.
cd ch10\yolo-fixed
..\..\.venv-ch10-yolo\Scripts\bentoml.exe build
..\..\.venv-ch10-yolo\Scripts\bentoml.exe list
Successfully built Bento(tag="yolo_v8:rxu4w6w3dcwsplaz"). Tag Size Model Size Creation Time yolo_v8:rxu4w6w3dcwsplaz 5.93 MiB 0.00 B 2026-11-08 11:03:13 yolo_v8:rkfmjl63dcwtflaz 5.93 MiB 0.00 B 2026-11-08 11:03:07Model Size가 0인 것은 가중치가 BentoML 모델이 아니라 소스 파일로 들어갔기 때문이다. Bento 크기 5.93MiB의 대부분이 그 가중치다. - 소스 폴더가 아니라 태그로 띄운다. B-4의 응답과 지연 측정은 이렇게 띄운 서비스에서 했다.
..\..\.venv-ch10-yolo\Scripts\bentoml.exe serve yolo_v8:rxu4w6w3dcwsplaz --port 3011 --api-workers 2 curl.exe -s http://127.0.0.1:3011/metrics | Select-String 'request_total\{endpoint="/(invocation|render)'소스 폴더에서 띄웠을 때는bentoml_api_server_request_total{endpoint="/invocation",http_response_code="200",service_name="yolo_v8",service_version="rxu4w6w3dcwsplaz"} 2.0 bentoml_api_server_request_total{endpoint="/render",http_response_code="200",service_name="yolo_v8",service_version="rxu4w6w3dcwsplaz"} 1.0 bentoml_api_server_request_total{endpoint="/invocation",http_response_code="400",service_name="yolo_v8",service_version="rxu4w6w3dcwsplaz"} 1.0service_version="not available"이었다. 400 응답이 따로 집계되므로 클라이언트 오류와 서버 오류를 구분해 볼 수 있다.
C-3. 컨테이너 이미지
책은 bentoml containerize yolo_v8:<태그>와 docker run --rm -p 3000:3000 yolo_v8:<태그>로 이어진다. 이번 실습에서는 실행하지 않았다. 공유 PC의 디스크 여유가 실습 중 2~7GB 사이였는데, torch가 들어간 이미지를 빌드하면 Docker 디스크 파일이 수 GB 늘고 이 파일은 저절로 줄지 않는다. 디스크가 충분하다면 아래 명령으로 이어 가면 된다.
..\..\.venv-ch10-yolo\Scripts\bentoml.exe containerize yolo_v8:rxu4w6w3dcwsplaz
docker run --rm -p 3000:3000 yolo_v8:rxu4w6w3dcwsplaz
docker image inspect yolo_v8:rxu4w6w3dcwsplaz --format "{{.Id}}"
마지막 명령의 값이 출시 기록에 들어갈 이미지 식별자다. 레지스트리에 올린 뒤에는 docker image inspect --format "{{index .RepoDigests 0}}"의 digest를 쓴다.
완료 기준: bentoml list에 두 Bento가 보이고, 태그로 띄운 서비스의 지표에 service_version이 Bento 버전으로 찍힌다.
D. BentoML과 MLflow 추천 서비스
지금 위치는 전체 그림의 ④~⑥이다. 책 10.6과 리스팅 10.1, 10.2를 따라간다.
D-1. prod 별칭 준비
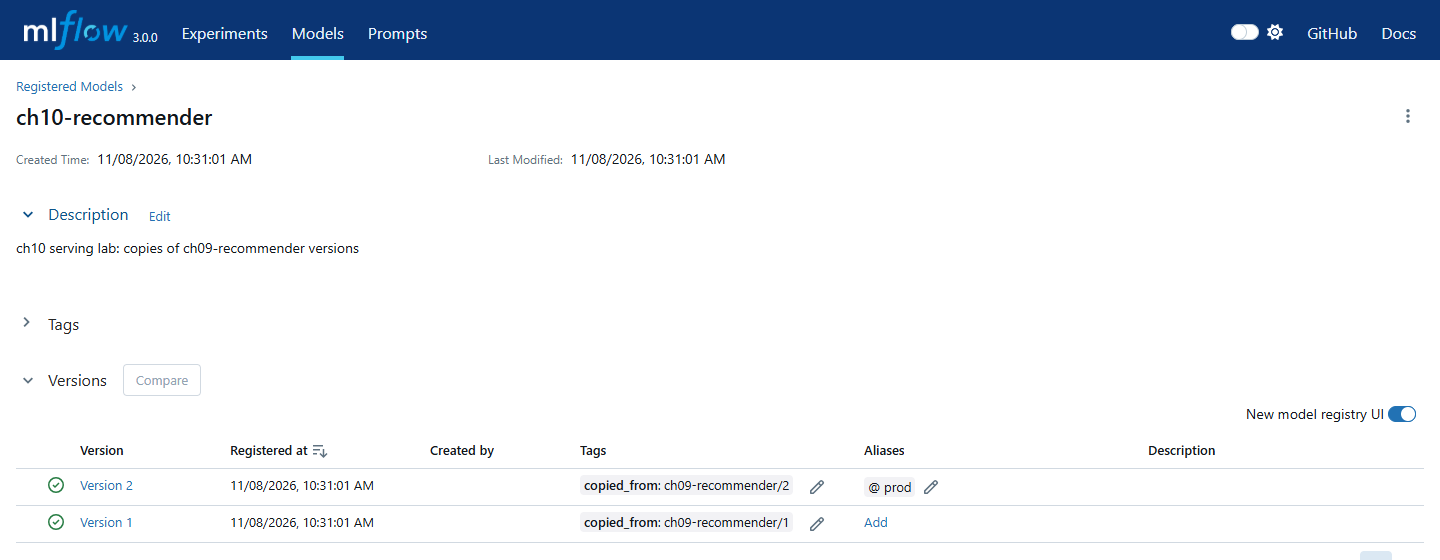
리스팅 10.1은 prod 별칭을 찾는다. 그런데 9장 파이프라인은 staging만 만들었고, 9장의 등록 모델을 직접 바꾸면 9장의 기록이 흐려진다. 그래서 9장의 두 버전을 같은 원천을 가리키는 새 등록 모델 ch10-recommender로 복사하고 거기에 prod를 붙인다. 모델 파일은 복사되지 않고 같은 MLflow 모델(models:/m-...)을 가리킨다.
ch10\register_recommender.py:
import os
os.environ.setdefault("MLFLOW_S3_ENDPOINT_URL", "http://127.0.0.1:9000")
os.environ.setdefault("AWS_ACCESS_KEY_ID", "minio")
os.environ.setdefault("AWS_SECRET_ACCESS_KEY", "minio123")
import mlflow
from mlflow import MlflowClient

mlflow.set_tracking_uri("http://127.0.0.1:5000")
c = MlflowClient()
src, name = "ch09-recommender", "ch10-recommender"
try:
    c.create_registered_model(name, description="ch10 serving lab: copies of ch09-recommender versions")
except Exception as e:
    print("exists:", type(e).__name__)
existing = {v.tags.get("copied_from") for v in c.search_model_versions(f"name='{name}'")}
for v in sorted(c.search_model_versions(f"name='{src}'"), key=lambda v: int(v.version)):
    tag = f"{src}/{v.version}"
    if tag not in existing:
        nv = c.create_model_version(name, source=v.source, run_id=v.run_id, tags={"copied_from": tag})
        print("created", nv.version, "from", tag, v.source)
c.set_registered_model_alias(name, "prod", "2").\.venv-ch10-rec\Scripts\python.exe ch10\register_recommender.pycreated 1 from ch09-recommender/1 models:/m-3d3e5a3a2562492299e2e346c7383f14
created 2 from ch09-recommender/2 models:/m-4db3af9d5a1a4773a66d02e7f3c05a36MLflow 화면의 Models → ch10-recommender에서 두 버전과 v2의 @ prod를 확인한다. 9장에서 본 대로 v2는 인기순 기준선보다 크게 낮은 모델이다. 여기서 prod는 서빙 실습을 위한 이름표이지 출시 판단이 아니다.
D-2. 저자 서비스 실행
- 저자 폴더를 복사하고 실행을 막는 두 줄만 바꾼다. MLflow 주소와 모델 이름을 환경 변수로 받게 한다.
New-Item -ItemType Directory -Force ch10\rec-author | Out-Null Copy-Item upstream\ch10-movie-recommender\serving\* ch10\rec-author\ch10\rec-author\service.py에서import os를 맨 위에 넣고 두 곳을 고친다.def __init__(self, registered_model_name=os.environ.get("MODEL_NAME", "recommender_production"), device="cpu"): mlflow.set_tracking_uri(uri=os.environ["MLFLOW_TRACKING_URI"]) - 환경 변수를 넣고 띄운다.
$env:MLFLOW_TRACKING_URI = "http://127.0.0.1:5000"
$env:MLFLOW_S3_ENDPOINT_URL = "http://127.0.0.1:9000"
$env:AWS_ACCESS_KEY_ID = "minio"; $env:AWS_SECRET_ACCESS_KEY = "minio123"
$env:MODEL_NAME = "ch10-recommender"
cd ch10\rec-author
..\..\.venv-ch10-rec\Scripts\bentoml.exe serve service:RecommenderRunable --port 3020
prometheus_client.registry.DuplicateTimeseries: Duplicated timeseries in CollectorRegistry: {'ranked_movie_present_counter', 'ranked_movie_present_counter_created', 'ranked_movie_present_counter_total'}metrics.py의 두 번째 카운터ranked_movie_absent_counter도name="ranked_movie_present_counter"로 등록돼 있다. 이름을ranked_movie_absent_counter로 고치고 다시 띄우면 18초 뒤 준비된다. 로그에runs:/c1252d6c9f944228a7a93c26585708c4/model이 찍혀prod가 v2로 해석됐음을 알 수 있다. - 요청 본문을 파일로 만들어 보낸다. PowerShell에서 JSON 문자열을 직접 넘기면 따옴표가 깨지므로 파일이 안전하다.
New-Item -ItemType Directory -Force ch10\req | Out-Null '{"user_id": 50, "top_k": 5}' | Set-Content -NoNewline ch10\req\u50.json '{"user_id": 99999, "top_k": 5}' | Set-Content -NoNewline ch10\req\u99999.json '{"user_id": "abc"}' | Set-Content -NoNewline ch10\req\bad.json '{"user_id": 50, "top_k": 0}' | Set-Content -NoNewline ch10\req\k0.json foreach ($f in 'u50','u99999','bad','k0') { "$f -> " + (curl.exe -s -w " [%{http_code}]" -X POST -H "Content-Type: application/json" --data-binary "@ch10\req\$f.json" http://127.0.0.1:3020/predict) }상위 5개 중 54004(I Now Pronounce You Chuck and Larry)만 영화 목록에 있고 나머지 넷은 없는 ID다. 문자열 사용자 ID는 타입 힌트 덕분에 400이지만, 없는 사용자는 500이다.u50 -> [132269, 123347, 54004, 89636, 89459] [200] u99999 -> {"error":"An unexpected error has occurred, please check the server log."} [500] bad -> {"error":"1 validation error for Input","detail":[{"type":"int_parsing","loc":["user_id"],"msg":"Input should be a valid integer, unable to parse string as an integer",...}]} [400] k0 -> [] [200] - 서버를 멈췄다가 다시 띄운 뒤 BentoML 모델 저장소를 본다.
..\..\.venv-ch10-rec\Scripts\bentoml.exe models list시작할 때마다 같은 모델이 한 벌씩 늘어난다.Tag Module Size Creation Time recommender:tte63hw3csmwtlaz bentoml.mlflow 14.85 MiB 2026-11-08 10:35:00 recommender:kbjzhn63cs65hlaz bentoml.mlflow 14.85 MiB 2026-11-08 10:32:51
D-3. 고친 서비스
ch10\rec-fixed\에 D-2에서 고친 metrics.py를 복사하고 service.py를 새로 쓴다. 구조는 리스팅 10.1을 따른다. 다른 점은 클래스 이름을 RecommenderService로 바꾼 것, 그리고 Python 3.9에서는 list[int] | None 표기를 쓸 수 없어 typing의 Optional[List[int]]를 쓴 것뿐이다.
import io
import os
from typing import List, Optional

import bentoml
import boto3
import mlflow
import numpy as np
import pandas as pd
import torch
from bentoml.exceptions import InvalidArgument
from mlflow import MlflowClient

from metrics import ranked_movie_absent_counter, ranked_movie_present_counter

MODEL_NAME = os.environ.get("MODEL_NAME", "ch10-recommender")
MODEL_ALIAS = os.environ.get("MODEL_ALIAS", "prod")
MODEL_VERSION = os.environ.get("MODEL_VERSION")  # pin a version for a release; alias otherwise
CATALOG_URI = os.environ.get(
    "CATALOG_URI", "s3://ch09-datasets/ml-latest-small/movies.parquet.gzip")
MAX_TOP_K = 100


@bentoml.service(
    resources={"cpu": "2"},
    traffic={"timeout": 10},
    workers=1,
)
class RecommenderService:
    def __init__(self) -> None:
        mlflow.set_tracking_uri(os.environ["MLFLOW_TRACKING_URI"])
        client = MlflowClient()
        if MODEL_VERSION:
            mv = client.get_model_version(MODEL_NAME, MODEL_VERSION)
        else:
            mv = client.get_model_version_by_alias(MODEL_NAME, MODEL_ALIAS)
        # resolve the alias once and keep the concrete version for logs and headers
        self.model_label = f"{MODEL_NAME}/{mv.version}"
        print(f"loading {self.model_label} (alias={MODEL_ALIAS}, pinned={MODEL_VERSION}) run={mv.run_id}")
        self.model = mlflow.pytorch.load_model(f"models:/{MODEL_NAME}/{mv.version}", map_location="cpu")
        self.model.eval()
        self.n_users = self.model.user_factors.num_embeddings - 1
        bucket, key = CATALOG_URI[len("s3://"):].split("/", 1)
        body = boto3.client("s3", endpoint_url=os.environ["MLFLOW_S3_ENDPOINT_URL"]).get_object(Bucket=bucket, Key=key)["Body"].read()
        catalog = pd.read_parquet(io.BytesIO(body))
        # only real movie ids that the model has an embedding for
        ids = catalog.movieId.to_numpy()
        self.items = np.sort(ids[ids <= self.model.n_items])
        print(f"ready: users={self.n_users} catalog_items={len(self.items)}")

    @bentoml.api
    def predict(
        self,
        user_id: int,
        top_k: int = 10,
        ranked_movies: Optional[List[int]] = None,
        ctx: bentoml.Context = None,
    ) -> List[int]:
        if not 1 <= user_id <= self.n_users:
            raise InvalidArgument(f"unknown user_id {user_id}; valid range is 1..{self.n_users}")
        if not 1 <= top_k <= MAX_TOP_K:
            raise InvalidArgument(f"top_k must be between 1 and {MAX_TOP_K}")
        items = self.items
        if ranked_movies:
            ranked_movie_present_counter.inc()
            items = items[~np.isin(items, ranked_movies)]
        else:
            ranked_movie_absent_counter.inc()
        with torch.no_grad():
            # training used 0-based rows: userId - 1, movieId - 1
            users = torch.full((len(items),), user_id - 1, dtype=torch.long)
            scores = self.model(users, torch.as_tensor(items - 1, dtype=torch.long)).squeeze(1)
        top = torch.topk(scores, min(top_k, len(items))).indices.numpy()
        ctx.response.headers["x-model-version"] = self.model_label
return items[top].tolist()workers=1은 시작 비용 때문이다. 워커마다 MLflow에서 모델을 내려받고 카탈로그를 읽는다.
D-4. 응답 확인
D-2와 같은 환경 변수로 띄운다.
cd ch10\rec-fixed
..\..\.venv-ch10-rec\Scripts\bentoml.exe serve service:RecommenderService --port 3021
loading ch10-recommender/2 (alias=prod, pinned=None) run=c1252d6c9f944228a7a93c26585708c4 ready: users=610 catalog_items=9742http://127.0.0.1:3021 의 Swagger에서 POST /predict에
{"user_id": 50, "top_k": 5}를 보낸다. 모두 카탈로그에 있는 영화이고 응답 헤더에 해석된 버전이 있다.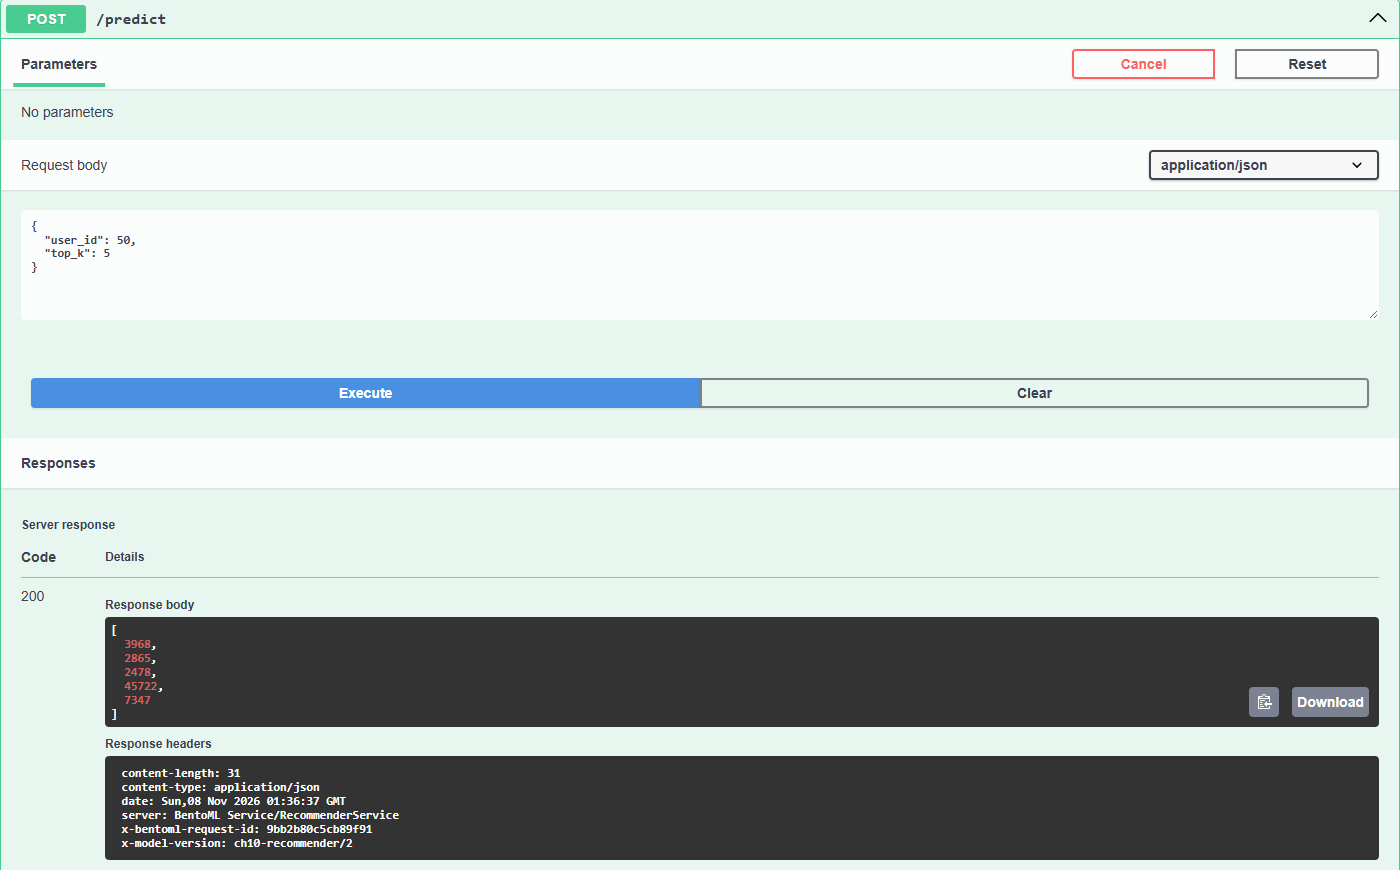
3968은 Bedazzled(2000), 45722는 Pirates of the Caribbean: Dead Man’s Chest(2006)다. 학습과 같은 인덱스로 같은 모델을 직접 불러 계산한 상위 5개와 같았다.
없는 사용자를 보내면 400과 이유가 온다.
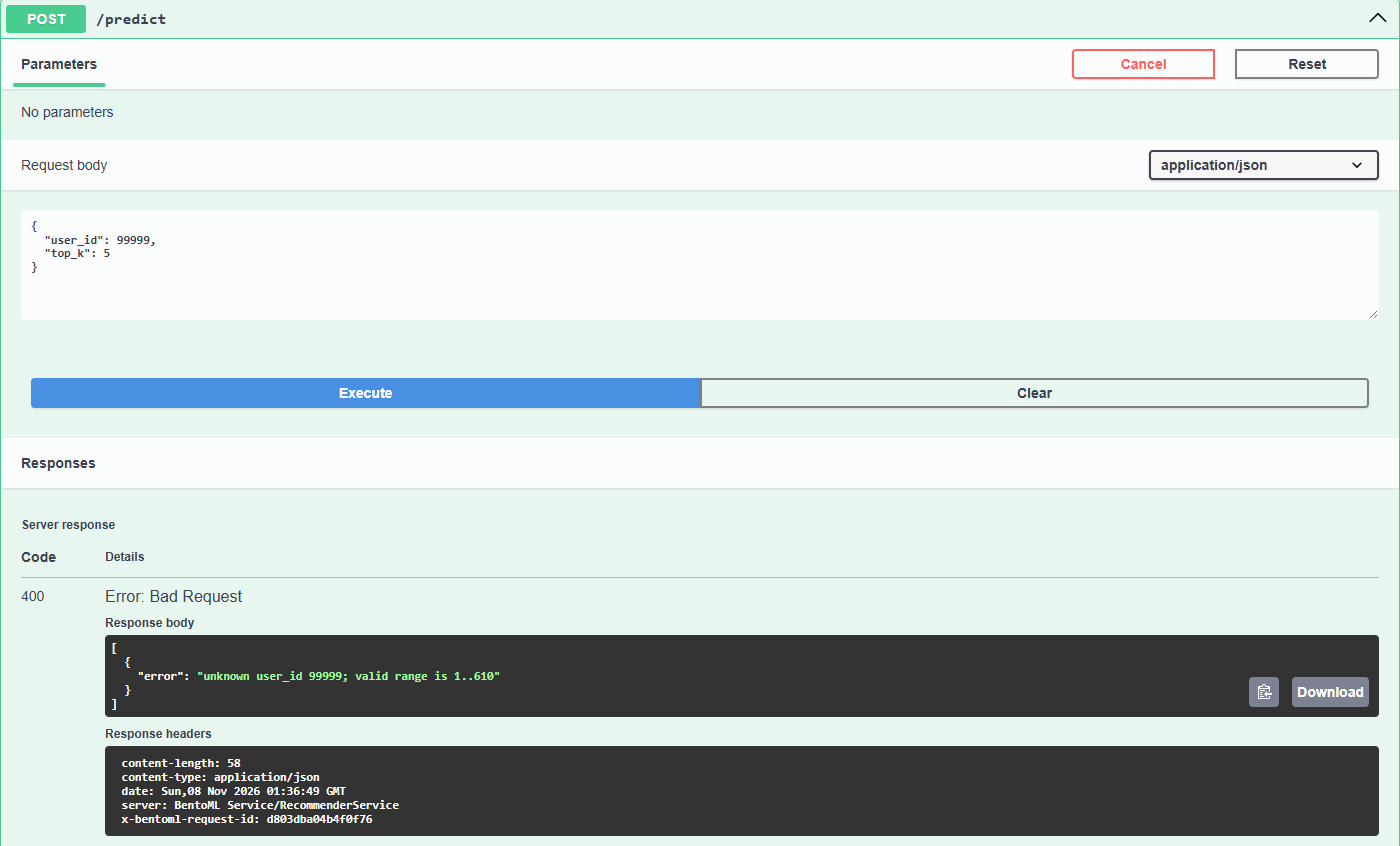
D-2의 나머지 요청도 보내면
top_k: 0은top_k must be between 1 and 100과 400,user_id: -3도 400이다. 오류 본문이[{"error": ...}]처럼 목록으로 감싸여 오는 것은 반환 타입을List[int]로 선언한 1.4.40의 동작이다.
D-5. Bento 빌드와 의존성 잠금
ch10\rec-fixed\bentofile.yaml은 리스팅 10.2에 기반 이미지의 파이썬 버전과 기본 환경 변수를 더했다.service: "service:RecommenderService" labels: owner: ch10 stage: demo include: - "*.py" python: requirements_txt: "./requirements.txt" docker: python_version: "3.9" envs: - name: MODEL_NAME value: ch10-recommender - name: MODEL_ALIAS value: prod- 저자처럼
requirements.txt에torch,mlflow만 적고 빌드하면 성공은 하지만, Bento의env\python\requirements.txt에 잠긴 목록을 보면 CUDA 패키지가 들어 있다...\..\.venv-ch10-rec\Scripts\bentoml.exe build Get-Content $env:BENTOML_HOME\bentos\recommender_service\<태그>\env\python\requirements.txt | Select-String '^(torch|nvidia|triton)'nvidia-cublas-cu12==12.8.4.1 nvidia-cudnn-cu12==9.10.2.21 ... torch==2.8.0 triton==3.4.0nvidia-패키지가 15개였다. Windows에서 빌드해도 BentoML 1.4는x86_64-manylinux_2_36용으로 잠그고, 그 플랫폼의 PyPI torch는 CUDA 빌드다. - CPU 휠 주소를 직접 적는다.
--extra-index-url로 PyTorch 인덱스를 더하는 방법은 uv가 첫 번째로 찾은 인덱스의 버전만 보는 규칙 때문에certifi를 찾지 못해 잠금에 실패했다.bentoml==1.4.40 torch @ https://download-r2.pytorch.org/whl/cpu/torch-2.8.0%2Bcpu-cp39-cp39-manylinux_2_28_x86_64.whl mlflow==3.0.0 numpy==2.0.2 pandas==2.3.3 pyarrow boto3 - 이번에는
no wheels with a matching Python version tag (e.g., cp312)로 실패했다. 빌드 환경의 파이썬(3.9)과docker.python_version이 같으면 BentoML이 잠금 명령에 파이썬 버전을 넘기지 않고, uv가 PC의 다른 파이썬(3.12)을 기준으로 잡기 때문이다.UV_PYTHON을 지정하고 다시 빌드한다.$env:UV_PYTHON = "3.9" ..\..\.venv-ch10-rec\Scripts\bentoml.exe build잠긴 목록에서Successfully built Bento(tag="recommender_service:5d2vlxw3cwf75laz").nvidia-로 시작하는 것은 BentoML의 의존성인nvidia-ml-py하나만 남았다.bento.yaml의models: []가 보여 주듯 이 Bento에는 모델이 없다. 어떤 모델이 뜰지는 시작 시점의prod별칭이 정한다.
D-6. 별칭을 옮기면 무엇이 바뀌는가
롤백을 별칭 이동으로 할 수 있는지 확인한다. D-4의 서비스가 떠 있는 상태에서 진행한다.
function Ask { $b = curl.exe -s -D ch10\hdr.txt -X POST -H "Content-Type: application/json" --data-binary "@ch10\req\u50.json" http://127.0.0.1:3021/predict; "$b  " + ((Get-Content ch10\hdr.txt | Select-String 'x-model-version') -join '') }
Ask
.\.venv-ch10-rec\Scripts\python.exe -c "import mlflow; from mlflow import MlflowClient; mlflow.set_tracking_uri('http://127.0.0.1:5000'); MlflowClient().set_registered_model_alias('ch10-recommender','prod','1')"
Ask
서비스 터미널에서 Ctrl+C로 멈추고 같은 명령으로 다시 띄운 뒤 한 번 더 Ask를 부른다. 세 번의 Ask 결과를 차례로 모으면 다음과 같다.
1) 시작 직후:               [3968, 2865, 2478, 45722, 7347]  x-model-version: ch10-recommender/2
2) 별칭을 v1로 옮긴 뒤:      [3968, 2865, 2478, 45722, 7347]  x-model-version: ch10-recommender/2
3) 다시 시작한 뒤:           [115727, 103228, 122902, 59604, 63433]  x-model-version: ch10-recommender/1
별칭 이동만으로는 아무것도 바뀌지 않고, 재시작해야 반영된다. 3)의 목록은 9장 F-3에서 v1로 계산한 사용자 50의 상위 5편과 같다. 확인이 끝나면 별칭을 v2로 되돌린다(마지막 명령의 '1'을 '2'로).
완료 기준: 고친 서비스가 카탈로그에 있는 영화만 돌려주고, 범위 밖 입력에 400을 돌려주며, 응답 헤더의 버전이 재시작 시점의 별칭과 일치한다.
E. MLflow만으로 서빙
책 10.7을 따라간다. 그림의 ⑦이다.
E-1. 등록 모델을 그대로 서빙
책의 스크립트와 같이 별칭으로 서빙한다. 가상환경의
Scripts를 PATH 앞에 넣어야 한다.mlflow models serve는 내부에서uvicorn명령을 PATH에서 찾아 실행하는데, 이를 빼먹으면 PC에 설치된 다른 프로그램의uvicorn이 잡혀returned non zero return code로 실패한다.$env:PATH = "$PWD\.venv-ch10-rec\Scripts;$env:PATH" mlflow models serve -m "models:/ch10-recommender@prod" --env-manager local -p 5010 -h 127.0.0.1--env-manager local은 모델의python_env.yaml로 새 가상환경을 만들지 않고 현재 환경을 쓰라는 뜻이다. 현재 환경을 9장 학습과 같은 Python 3.9로 맞춰 두었기 때문에 쓸 수 있다.상태 경로는 정상이다.
curl.exe -s -w " [%{http_code}]`n" http://127.0.0.1:5010/ping
curl.exe -s -w " [%{http_code}]`n" http://127.0.0.1:5010/version
[200] 3.0.0 [200]예측은 어떤 형식으로도 되지 않는다. 등록된 서명은
user,movie두 텐서다.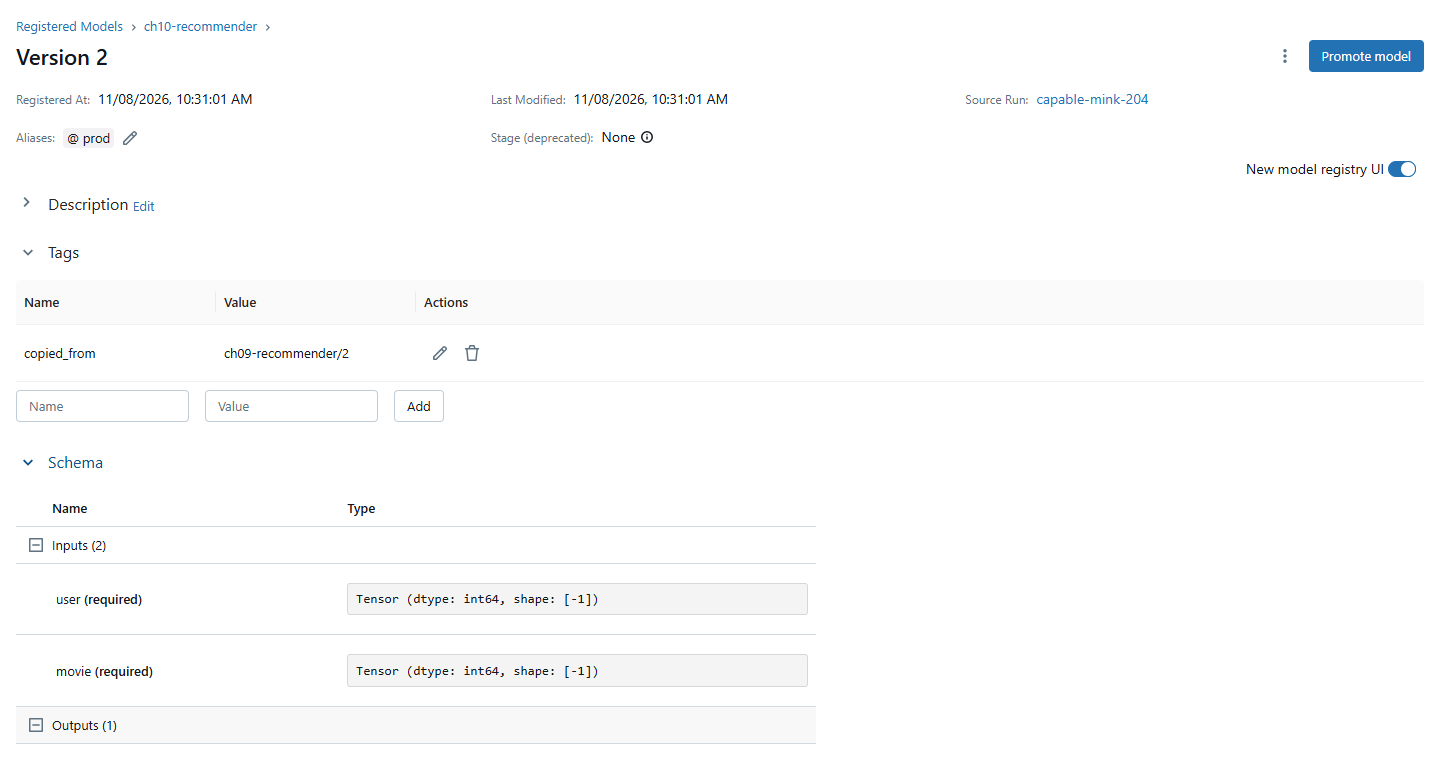
'{"inputs": {"user": [49, 49, 49], "movie": [3967, 2864, 0]}}' | Set-Content -NoNewline ch10\req\mlflow-dict.json
'{"inputs": [[49, 3967]]}' | Set-Content -NoNewline ch10\req\mlflow-list.json
foreach ($f in 'mlflow-dict','mlflow-list') { curl.exe -s -w "  [%{http_code}]`n" -X POST -H "Content-Type: application/json" --data-binary "@ch10\req\$f.json" http://127.0.0.1:5010/invocations }
{"error_code": "BAD_REQUEST", ..., "stack_trace": "...TypeError: The PyTorch flavor does not support List or Dict input types. Please use a pandas.DataFrame or a numpy.ndarray\n"} [400] {"error_code": "INVALID_PARAMETER_VALUE", "message": "... Model is missing inputs ['user', 'movie']."} [400]dataframe_split으로 두 열을 보내도 첫 번째와 같은TypeError였다. 첫 응답의stack_trace에는 서버의 가상환경 경로가 그대로 들어 있었다.
E-2. pyfunc 래퍼 모델 기록
추천 절차를 MLflow 모델 안에 넣는다.
ch10\mlflow-pyfunc\rec_pyfunc.py:import mlflow import numpy as np import pandas as pd import torch class RecommenderPyfunc(mlflow.pyfunc.PythonModel): """Wrap the two-input PyTorch model so MLflow serving takes user_id and top_k.""" def load_context(self, context): self.model = mlflow.pytorch.load_model(context.artifacts["torch_model"], map_location="cpu") self.model.eval() self.n_users = self.model.user_factors.num_embeddings - 1 ids = pd.read_parquet(context.artifacts["catalog"]).movieId.to_numpy() self.items = np.sort(ids[ids <= self.model.n_items]) def predict(self, context, model_input: pd.DataFrame, params=None): out = [] for user_id, top_k in zip(model_input["user_id"], model_input["top_k"]): if not 1 <= user_id <= self.n_users: raise ValueError(f"unknown user_id {user_id}") with torch.no_grad(): users = torch.full((len(self.items),), int(user_id) - 1, dtype=torch.long) scores = self.model(users, torch.as_tensor(self.items - 1, dtype=torch.long)).squeeze(1) out.append(self.items[torch.topk(scores, int(top_k)).indices.numpy()].tolist()) return pd.DataFrame({"movie_ids": out})ch10\mlflow-pyfunc\log_pyfunc.py는 현재prod버전과 카탈로그 파일을 아티팩트로 담아 새 모델을 기록하고ch10-recommender-pyfunc로 등록한다.import os, sys sys.path.insert(0, os.path.dirname(os.path.abspath(__file__))) os.environ.setdefault("MLFLOW_S3_ENDPOINT_URL", "http://127.0.0.1:9000") os.environ.setdefault("AWS_ACCESS_KEY_ID", "minio") os.environ.setdefault("AWS_SECRET_ACCESS_KEY", "minio123") import boto3 import mlflow import pandas as pd from mlflow import MlflowClient from mlflow.models import infer_signature from rec_pyfunc import RecommenderPyfunc mlflow.set_tracking_uri("http://127.0.0.1:5000") mlflow.set_experiment("ch10-serving") client = MlflowClient() src = client.get_model_version_by_alias("ch10-recommender", "prod") here = os.path.dirname(os.path.abspath(__file__)) catalog = os.path.join(here, "movies.parquet.gzip") boto3.client("s3", endpoint_url=os.environ["MLFLOW_S3_ENDPOINT_URL"]).download_file( "ch09-datasets", "ml-latest-small/movies.parquet.gzip", catalog) example = pd.DataFrame({"user_id": [50], "top_k": [5]}) with mlflow.start_run(run_name="ch10-recommender-pyfunc") as run: mlflow.set_tags({"wraps": f"ch10-recommender/{src.version}", "wraps_run_id": src.run_id, "catalog": "s3://ch09-datasets/ml-latest-small/movies.parquet.gzip"}) info = mlflow.pyfunc.log_model( "model", python_model=RecommenderPyfunc(), artifacts={"torch_model": f"models:/ch10-recommender/{src.version}", "catalog": catalog}, code_paths=[os.path.join(here, "rec_pyfunc.py")], signature=infer_signature(example, pd.DataFrame({"movie_ids": [[1, 2, 3, 4, 5]]})), input_example=example, registered_model_name="ch10-recommender-pyfunc", ) latest = max(client.search_model_versions("name='ch10-recommender-pyfunc'"), key=lambda m: int(m.version)) client.set_registered_model_alias("ch10-recommender-pyfunc", "prod", latest.version) print("run", run.info.run_id, "model", info.model_uri, "version", latest.version, "wraps", src.version)실행한다. 콘솔 인코딩이 cp949이면 MLflow가 마지막에 출력하는 이모지에서
UnicodeEncodeError가 나므로PYTHONIOENCODING을 지정한다. 이 오류는 모델 등록이 끝난 뒤에 나기 때문에, 등록 모델 버전만 생기고 run은RUNNING으로 남는다. 그렇게 됐다면 그 버전과 run을 지우고 다시 실행한다. 아래는 다시 실행한 결과다.$env:PYTHONIOENCODING = "utf-8" .\.venv-ch10-rec\Scripts\python.exe ch10\mlflow-pyfunc\log_pyfunc.pyCreated version '1' of model 'ch10-recommender-pyfunc'. run 1117db056b4e4897901c90403b894930 model models:/m-8231dc6309784bbf85978b8302e2d046 version 1 wraps 2MLflow 화면의 Models → ch10-recommender-pyfunc → Version 1에서
@ prod와 새 스키마(user_id,top_k입력,movie_ids출력)를 확인한다.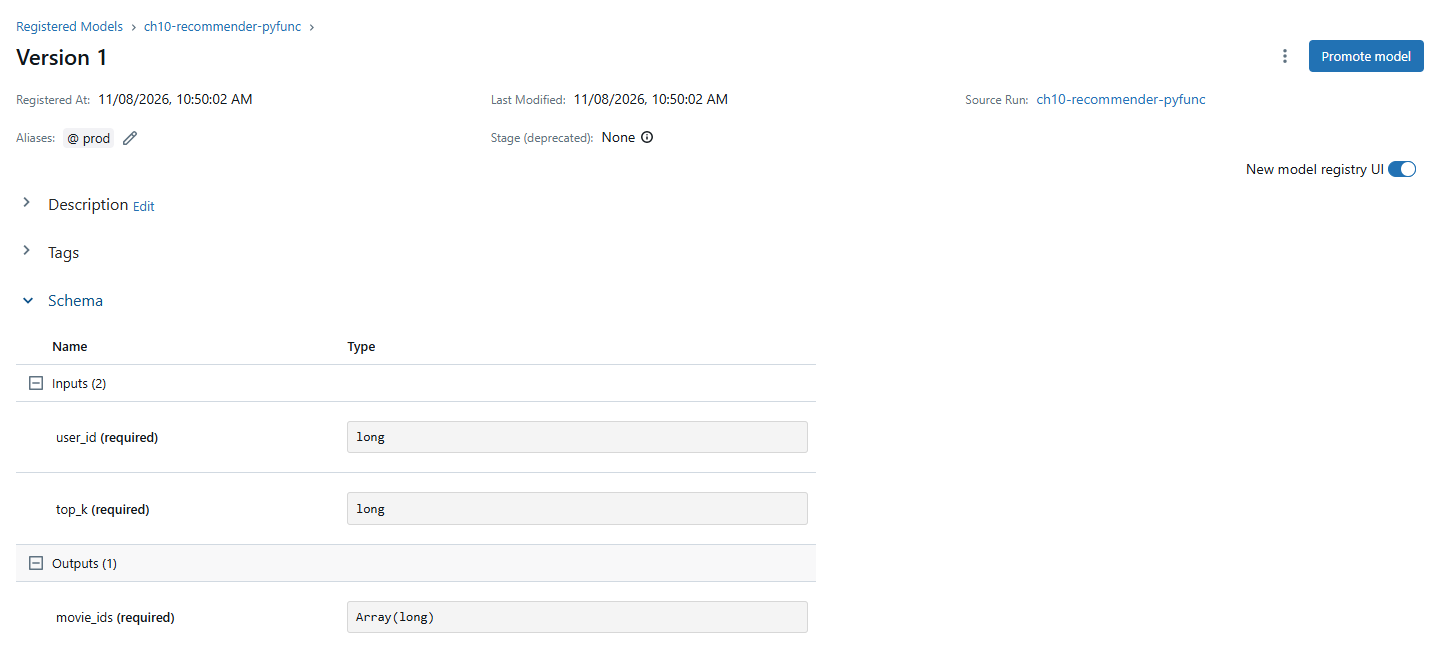
E-3. 래퍼 모델 서빙
mlflow models serve -m "models:/ch10-recommender-pyfunc@prod" --env-manager local -p 5010 -h 127.0.0.1다른 터미널에서:
'{"dataframe_records": [{"user_id": 50, "top_k": 5}]}' | Set-Content -NoNewline ch10\req\pyfunc.json
curl.exe -s -i -X POST -H "Content-Type: application/json" --data-binary "@ch10\req\pyfunc.json" http://127.0.0.1:5010/invocations
HTTP/1.1 200 OK
server: uvicorn
content-type: application/json
{"predictions": [{"movie_ids": [3968, 2865, 2478, 45722, 7347]}]}8초 만에 준비됐고, BentoML 서비스(D-4)와 같은 목록이다. 응답 헤더에는 어떤 버전이 답했는지가 없다. 없는 사용자를 보내면 400과 함께 서버 경로가 담긴 stack_trace가 온다.
완료 기준: /invocations가 D-4와 같은 추천 목록을 돌려준다.
F. KServe 배포와 롤백
책 10.8의 KServe를 실제 클러스터에 설치하고, B-1의 탐지 모델을 InferenceService로 배포한다. 남은 ⑧~⑫가 모두 여기에 들어간다.
F-1. KServe 설치(Standard 모드)
공식 설치 스크립트(kserve-standard-mode-full-install-with-manifests.sh)는 cert-manager를 Helm으로 새로 설치하고 Gateway API와 Envoy Gateway, LLM용 구성 요소까지 함께 넣는다. 6장에서 이미 cert-manager v1.13.3를 설치했고 Windows에서는 bash 스크립트를 그대로 쓸 수 없으므로, 릴리스의 매니페스트에서 InferenceService 컨트롤러에 필요한 것만 남겨 적용한다.
- KServe v0.21.0의 매니페스트를 받는다.
New-Item -ItemType Directory -Force ch10\kserve | Out-Null curl.exe -L -o ch10\kserve\kserve.yaml https://github.com/kserve/kserve/releases/download/v0.21.0/kserve.yaml ch10\kserve\filter_kserve.py로 LLM 서비스(llmisvc), 로컬 모델 캐시(localmodel), 커널 캐시(kernelcache) 구성 요소와 그 웹훅을 빼고, 기본 배포 모드를 Standard로, Ingress 생성은 끈다. CRD는 모두 남긴다.import json, yaml docs = [d for d in yaml.safe_load_all(open("ch10/kserve/kserve.yaml", encoding="utf-8")) if d] skip = ("llmisvc", "localmodel", "kernelcache", "llminferenceservice") out = [] for d in docs: name = d["metadata"]["name"] if d["kind"] != "CustomResourceDefinition" and any(s in name for s in skip): continue if d["kind"] in ("ValidatingWebhookConfiguration", "MutatingWebhookConfiguration"): d["webhooks"] = [w for w in d["webhooks"] if not any( s in w["name"] or s in w["clientConfig"].get("service", {}).get("name", "") for s in skip)] if d["kind"] == "ConfigMap" and name == "inferenceservice-config": deploy = json.loads(d["data"]["deploy"]); deploy["defaultDeploymentMode"] = "Standard" d["data"]["deploy"] = json.dumps(deploy, indent=2) ingress = json.loads(d["data"]["ingress"]); ingress["disableIngressCreation"] = True d["data"]["ingress"] = json.dumps(ingress, indent=2) out.append(d) yaml.safe_dump_all(out, open("ch10/kserve/ch10-kserve-core.yaml", "w", encoding="utf-8"), sort_keys=False) print("kept", len(out)).\.venv-ch10-yolo\Scripts\python.exe ch10\kserve\filter_kserve.pykept 43이 나온다. 배포 3개와 데몬셋 2개 중kserve-controller-manager만 남는다. 원본의 기본 모드는Serverless라 그대로 쓰면 Knative가 없는 클러스터에서 InferenceService가 준비되지 않는다.- 네임스페이스를 만들고 적용한다. CRD가 큰 파일이라
--server-side로 적용한다.처음 적용하면 마지막에kubectl create namespace kserve kubectl apply --server-side -f ch10\kserve\ch10-kserve-core.yamlno matches for kind "ClusterStorageContainer" in version "serving.kserve.io/v1alpha1"가 난다. 같은 파일 안의 CRD가 아직 등록되기 전에 그 리소스를 만들려 해서다. 몇 초 뒤 같은 명령을 한 번 더 실행하면 오류 없이 끝난다. - 웹훅 인증서와 컨트롤러를 확인한다.
kubectl -n kserve get certificate,podscert-manager v1.13.3가 KServe의 웹훅 인증서를 발급했다. 컨트롤러 이미지(43.7MB)와 kube-rbac-proxy 이미지(31.1MB)를 받는 데 1분 남짓 걸렸다.NAME READY SECRET AGE certificate.cert-manager.io/serving-cert True kserve-webhook-server-cert 28s NAME READY STATUS RESTARTS AGE pod/kserve-controller-manager-688c888fd9-wjtdl 2/2 Running 0 3m14s
F-2. 모델 위치와 접근 권한
- B-1의 가중치와 버전 정보를 버전 번호가 들어간 경로에 올린다. 경로가 곧 배포 명세에 적힐 모델 식별자가 된다.
.\.venv-ch10-yolo\Scripts\python.exe -c "import boto3; s3=boto3.client('s3', endpoint_url='http://127.0.0.1:9000', aws_access_key_id='minio', aws_secret_access_key='minio123'); 'ch10-models' in [b['Name'] for b in s3.list_buckets()['Buckets']] or s3.create_bucket(Bucket='ch10-models'); [s3.upload_file(f'ch10/yolo-fixed/{f}', 'ch10-models', f'detector/ch08-id-card-detector/1/{f}') for f in ('yolov8_custom.pt', 'model_info.json')]" ch10\kserve\ch10-setup.yaml로 네임스페이스, S3 키를 담은 Secret, 그 Secret을 쓰는 ServiceAccount를 만든다. Secret의 주석이 storage-initializer에게 S3 주소와 HTTP 사용 여부를 알려 준다.apiVersion: v1 kind: Namespace metadata: name: ch10-serving --- apiVersion: v1 kind: Secret metadata: name: ch10-s3 namespace: ch10-serving annotations: serving.kserve.io/s3-endpoint: minio-service.kubeflow.svc.cluster.local:9000 serving.kserve.io/s3-usehttps: "0" serving.kserve.io/s3-region: us-east-1 type: Opaque stringData: AWS_ACCESS_KEY_ID: minio AWS_SECRET_ACCESS_KEY: minio123 --- apiVersion: v1 kind: ServiceAccount metadata: name: ch10-kserve-sa namespace: ch10-serving secrets: - name: ch10-s3- 예측 서버 코드
ch10\kserve\detector_server.py를 만든다. KServe V1 프로토콜의 모델 상태 경로와 예측 경로를 표준 라이브러리로 구현하고, 포트는 먼저 열되 모델을 읽고 한 번 예열한 뒤에야 준비 상태를 200으로 돌려준다.PC에서"""Minimal KServe V1 protocol server for the ch08 YOLO detector. KServe only needs a container that listens on a port. In practice you would build an image with the kserve SDK (kserve.Model); this lab uses the standard library so that the ultralytics image already on the kind node can run it. """ import base64 import io import json import os import threading from http.server import BaseHTTPRequestHandler, ThreadingHTTPServer from PIL import Image from ultralytics import YOLO MODEL_NAME = os.environ.get("MODEL_NAME", "ch10-detector") MODEL_DIR = os.environ.get("MODEL_DIR", "/mnt/models") PORT = int(os.environ.get("PORT", "8080")) MAX_PIXELS = 4096 * 4096 state = {"ready": False, "model": None, "info": {}} lock = threading.Lock() def load(): info = json.load(open(os.path.join(MODEL_DIR, "model_info.json"))) model = YOLO(os.path.join(MODEL_DIR, "yolov8_custom.pt")) model(Image.new("RGB", (64, 64)), verbose=False) # warm up before reporting ready state.update(model=model, info=info, ready=True) print(f"ready: {info['registered_model']}/{info['version']} sha256={info['sha256'][:12]}", flush=True) class Handler(BaseHTTPRequestHandler): def _send(self, code, body): data = json.dumps(body).encode() self.send_response(code) self.send_header("Content-Type", "application/json") info = state["info"] if info: self.send_header("x-model-version", f"{info['registered_model']}/{info['version']}") self.send_header("Content-Length", str(len(data))) self.end_headers() self.wfile.write(data) def do_GET(self): if self.path == "/": self._send(200, {"status": "alive"}) elif self.path == f"/v1/models/{MODEL_NAME}": self._send(200 if state["ready"] else 503, {"name": MODEL_NAME, "ready": state["ready"]}) else: self._send(404, {"error": "not found"}) def do_POST(self): if self.path != f"/v1/models/{MODEL_NAME}:predict": return self._send(404, {"error": "not found"}) if not state["ready"]: return self._send(503, {"error": "model not ready"}) try: body = json.loads(self.rfile.read(int(self.headers.get("Content-Length", 0)))) images = [] for inst in body["instances"]: img = Image.open(io.BytesIO(base64.b64decode(inst["image_b64"]))) if img.width * img.height > MAX_PIXELS: raise ValueError(f"image too large: {img.width}x{img.height}") images.append(img.convert("RGB")) except Exception as e: # malformed JSON, base64 or image return self._send(400, {"error": f"bad request: {e}"}) with lock: results = state["model"](images, verbose=False) self._send(200, {"predictions": [json.loads(r.to_json()) for r in results]}) def log_message(self, fmt, *args): print(f"{self.address_string()} {fmt % args}", flush=True) if __name__ == "__main__": threading.Thread(target=load, daemon=True).start() ThreadingHTTPServer(("0.0.0.0", PORT), Handler).serve_forever()MODEL_DIR=ch10\yolo-fixed,PORT=8090으로 먼저 띄워 보면, 시작 직후 상태 경로는 연결되지 않다가 약 12초 뒤{"name": "ch10-detector", "ready": true}가 된다. - 적용하고, 서버 코드를 ConfigMap으로 넣는다.
kubectl apply -f ch10\kserve\ch10-setup.yaml
kubectl -n ch10-serving create configmap ch10-detector-server --from-file=ch10\kserve\detector_server.py --dry-run=client -o yaml | kubectl apply -f -
F-3. InferenceService 적용
ch10\kserve\ch10-detector-isvc.yaml. 이미지는 9장에서 kind 노드에 넣어 둔ultralytics/ultralytics:8.3.56-cpu를 그대로 쓴다.STORAGE_URI환경 변수가 storage-initializer를 붙이게 하는 신호다.readiness는 모델 상태 경로를, liveness는 모델과 무관한apiVersion: serving.kserve.io/v1beta1 kind: InferenceService metadata: name: ch10-detector namespace: ch10-serving labels: release: ch10-detector-r1 spec: predictor: serviceAccountName: ch10-kserve-sa minReplicas: 1 maxReplicas: 1 containers: - name: kserve-container image: ultralytics/ultralytics:8.3.56-cpu imagePullPolicy: IfNotPresent command: ["python3", "/app/detector_server.py"] env: - name: STORAGE_URI value: s3://ch10-models/detector/ch08-id-card-detector/1 - name: MODEL_NAME value: ch10-detector - name: YOLO_CONFIG_DIR value: /tmp/yolo ports: - containerPort: 8080 protocol: TCP readinessProbe: httpGet: path: /v1/models/ch10-detector port: 8080 periodSeconds: 5 livenessProbe: httpGet: path: / port: 8080 initialDelaySeconds: 30 periodSeconds: 10 resources: requests: {cpu: 500m, memory: 1Gi} limits: {cpu: "2", memory: 2Gi} volumeMounts: - name: server-code mountPath: /app volumes: - name: server-code configMap: name: ch10-detector-server/를 본다. 모델을 읽는 동안 liveness가 실패해 재시작되는 일을 막기 위한 구분이다.- 적용하고 KServe가 만든 리소스를 본다.30초 뒤의 상태다. 초기화 컨테이너가 storage-initializer 이미지(약 92MB)를 받는 중이다.
kubectl apply -f ch10\kserve\ch10-detector-isvc.yaml kubectl -n ch10-serving get inferenceservice,deploy,svc,pods,hpaNAME URL READY ... AGE inferenceservice.serving.kserve.io/ch10-detector http://ch10-detector-ch10-serving.example.com False 35s NAME READY UP-TO-DATE AVAILABLE AGE deployment.apps/ch10-detector-predictor 0/1 1 0 35s NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGE service/ch10-detector-predictor ClusterIP 10.96.113.37 <none> 80/TCP 35s NAME READY STATUS RESTARTS AGE pod/ch10-detector-predictor-b5dd9b8c5-phv9n 0/1 Init:0/1 0 35s NAME REFERENCE TARGETS MINPODS MAXPODS REPLICAS horizontalpodautoscaler.autoscaling/ch10-detector-predictor Deployment/ch10-detector-predictor cpu: <unknown>/80% 1 1 1InferenceService하나가 Deployment, Service, HPA로 바뀌었다. URL의example.com은 Ingress 도메인의 기본값으로, Ingress를 만들지 않았으므로 실제로 열리지는 않는다. - 1분쯤 뒤 READY가
True가 된다. 초기화 컨테이너의 로그에서 모델 파일을 가져온 기록을 본다.kubectl -n ch10-serving get inferenceservice kubectl -n ch10-serving logs deploy/ch10-detector-predictor -c storage-initializer --tail 3 kubectl -n ch10-serving logs deploy/ch10-detector-predictor -c kserve-container --tail 3마지막 줄은 kubelet의 readiness 프로브다.NAME URL READY ... AGE ch10-detector http://ch10-detector-ch10-serving.example.com True 65s ... Downloaded object detector/ch08-id-card-detector/1/yolov8_custom.pt ... Successfully copied s3://ch10-models/detector/ch08-id-card-detector/1 to /mnt/models ... Model downloaded in 0.639153748001263 seconds. ready: ch08-id-card-detector/1 sha256=d8c5a0d2bf8f 10.244.0.1 "GET /v1/models/ch10-detector HTTP/1.1" 200 -
F-4. 요청 보내기
- 세 번째 터미널에서 Service로 포트를 연결한다. 4장의 포트포워딩과 겹치지 않는 8095를 쓴다.
kubectl -n ch10-serving port-forward svc/ch10-detector-predictor 8095:80 - 이미지를 base64로 바꿔 V1 형식으로 보낸다.
$b64 = [Convert]::ToBase64String([IO.File]::ReadAllBytes("$PWD\ch10\two_cards.jpg")) "{`"instances`": [{`"image_b64`": `"$b64`"}]}" | Set-Content -NoNewline ch10\req\ks-two.json curl.exe -s -w " [%{http_code}]`n" http://127.0.0.1:8095/v1/models/ch10-detector curl.exe -s -i -X POST -H "Content-Type: application/json" --data-binary "@ch10\req\ks-two.json" http://127.0.0.1:8095/v1/models/ch10-detector:predictB-4의 BentoML 서비스와 같은 박스 두 개다. 좌표의 마지막 자리가 조금 다른 것은 ultralytics 버전(8.3.40과 8.3.56)과 파이썬 버전(3.10과 3.11)이 다르기 때문이다.{"name": "ch10-detector", "ready": true} [200] HTTP/1.0 200 OK Server: BaseHTTP/0.6 Python/3.11.10 Content-Type: application/json x-model-version: ch08-id-card-detector/1 {"predictions": [[{"name": "id_card", "class": 0, "confidence": 0.78848, "box": {"x1": 202.49304, "y1": 120.56191, "x2": 390.21524, "y2": 253.98024}}, {"name": "id_card", "class": 0, "confidence": 0.29102, "box": {"x1": 640.8335, "y1": 179.59755, "x2": 800.40088, "y2": 282.21329}}]]} - 이미지가 아닌 값을 보내면 400이다.
{"error": "bad request: cannot identify image file <_io.BytesIO object at 0x75ece3b73420>"} [400]
F-5. 책의 예시 명세
책의 InferenceService를 이름과 네임스페이스만 바꿔 적용한다.
apiVersion: "serving.kserve.io/v1beta1"
kind: "InferenceService"
metadata:
  name: "ch10-book-sample"
  namespace: ch10-serving
spec:
  predictor:
    model:
      modelFormat:
        name: sklearn
      storageUri: "gs://yolov8/models/pytorch/1.0/model"
kubectl apply -f ch10\kserve\ch10-book-sample.yaml
kubectl -n ch10-serving get inferenceservice
kubectl -n ch10-serving describe inferenceservice ch10-book-sampleNAME URL READY ...
ch10-book-sample Unknown
ch10-detector http://ch10-detector-ch10-serving.example.com True
Warning InternalError 9s (x13 over 37s) v1beta1Controllers no runtime found to support predictor with model type: {sklearn <nil>}상태의 modelStatus에는 NoSupportingRuntime, transitionStatus: InvalidSpec이 남는다. 이번 설치에는 ClusterServingRuntime을 넣지 않았으므로 sklearn 런타임도 없다. 런타임을 설치해도 이 명세는 YOLO PyTorch 모델을 scikit-learn 서버에 넘기는 셈이라 동작하지 않는다. 확인했으면 지운다.
kubectl -n ch10-serving delete inferenceservice ch10-book-sampleF-6. 잘못된 릴리스와 롤백
- 저장 위치를 존재하지 않는 버전 2로 바꾼 명세를 만든다. 실수로 아직 올리지 않은 모델 경로를 배포한 상황이다.
(Get-Content ch10\kserve\ch10-detector-isvc.yaml -Raw).Replace('ch10-detector-r1','ch10-detector-r2').Replace('ch08-id-card-detector/1','ch08-id-card-detector/2') | Set-Content ch10\kserve\ch10-detector-isvc-r2.yaml kubectl apply -f ch10\kserve\ch10-detector-isvc-r2.yaml - 1분 뒤 상태를 본다.
kubectl -n ch10-serving get inferenceservice,pods kubectl -n ch10-serving rollout status deploy/ch10-detector-predictor --timeout=10s새 Pod의 storage-initializer 로그는NAME URL READY ... inferenceservice.serving.kserve.io/ch10-detector http://ch10-detector-ch10-serving.example.com True NAME READY STATUS RESTARTS AGE pod/ch10-detector-predictor-68b4746cdb-lzjbq 0/1 Init:CrashLoopBackOff 3 (8s ago) 53s pod/ch10-detector-predictor-b5dd9b8c5-phv9n 1/1 Running 0 2m39s Waiting for deployment "ch10-detector-predictor" rollout to finish: 1 old replicas are pending termination... error: timed out waiting for the conditionStorage initialization failed: Failed to fetch model. No model found in detector/ch08-id-card-detector/2.다. 그 사이 F-4의 요청을 다시 보내면 여전히 200과x-model-version: ch08-id-card-detector/1이 온다. READY가True인 것은 기존 Pod가 살아 있어서이고, 새 릴리스가 반영됐다는 뜻이 아니다. - 이전 명세를 다시 적용해 되돌린다.
kubectl apply -f ch10\kserve\ch10-detector-isvc.yaml kubectl -n ch10-serving rollout status deploy/ch10-detector-predictor --timeout=60s kubectl -n ch10-serving get rs -o custom-columns=NAME:.metadata.name,DESIRED:.spec.replicas,READY:.status.readyReplicas,REVISION:.metadata.annotations.deployment\.kubernetes\.io/revisionr1과 같은 Pod 템플릿이라 Deployment는 처음 ReplicaSet(deployment "ch10-detector-predictor" successfully rolled out NAME DESIRED READY REVISION ch10-detector-predictor-68b4746cdb 0 <none> 2 ch10-detector-predictor-b5dd9b8c5 1 1 3b5dd9b8c5)을 리비전 3으로 다시 쓰고, 실패한 ReplicaSet은 0으로 줄였다. 응답하던 Pod는 한 번도 내려가지 않았다.
F-7. 출시 기록 만들기
ch10\release_manifest.py는 InferenceService 명세, 실행 중인 Pod의 이미지 ID, ConfigMap의 서버 코드 해시, MLflow 모델 버전을 모아 기록을 만든다.
import hashlib, json, os, subprocess, sys
import yaml
import mlflow
from mlflow import MlflowClient

ns, name, release_id, previous = sys.argv[1:5]

def kubectl(*args):
    return json.loads(subprocess.check_output(["kubectl", "-n", ns, *args, "-o", "json"]))

isvc = kubectl("get", "inferenceservice", name)
c = isvc["spec"]["predictor"]["containers"][0]
env = {e["name"]: e["value"] for e in c.get("env", [])}
pods = kubectl("get", "pods", "-l", f"serving.kserve.io/inferenceservice={name}")["items"]
image_ids = sorted({s["imageID"] for p in pods for s in p["status"].get("containerStatuses", [])})
cm = kubectl("get", "configmap", "ch10-detector-server")
code_sha = hashlib.sha256(cm["data"]["detector_server.py"].encode()).hexdigest()

storage = env["STORAGE_URI"]  # s3://ch10-models/detector/<registered model>/<version>
registered, version = storage.rstrip("/").split("/")[-2:]
mlflow.set_tracking_uri("http://127.0.0.1:5000")
mv = MlflowClient().get_model_version(registered, version)
info = json.load(open(os.path.join("ch10", "yolo-fixed", "model_info.json")))

record = {
    "release_id": release_id,
    "previous_release_id": previous,
    "inference_service": f"{ns}/{name}",
    "isvc_generation": isvc["metadata"]["generation"],
    "image": c["image"],
    "image_id": image_ids,
    "server_code_sha256": code_sha,
    "storage_uri": storage,
    "model": {"registry_name": registered, "version": mv.version, "run_id": mv.run_id,
              "weights_sha256": info["sha256"],
              "release_decision": mv.tags.get("release_decision")},
    "api_contract": "KServe V1 /v1/models/ch10-detector:predict, instances[].image_b64",
    "ready": [f"{x['type']}={x['status']}" for x in isvc["status"]["conditions"]],
}
print(yaml.safe_dump(record, sort_keys=False, allow_unicode=True)).\.venv-ch10-yolo\Scripts\python.exe ch10\release_manifest.py ch10-serving ch10-detector ch10-detector-r1 none출력은 출시 정보와 롤백 단위에 실은 YAML이다. 롤백 뒤에 만들었으므로 isvc_generation이 3(r1, r2, r1 재적용)이다. 이 기록을 릴리스마다 남겨 두면 F-6의 롤백은 “기록의 r1 값으로 명세를 다시 적용한다"는 한 줄이 된다.
완료 기준: kubectl -n ch10-serving get inferenceservice ch10-detector가 True이고, 예측 응답의 x-model-version과 출시 기록의 모델 버전이 같다.
G. 문제 해결과 정리
G-1. 자주 만나는 실패
| 증상 | 위치 | 원인과 조치 |
|---|---|---|
bentoml list나 bentoml serve <태그>에서 KeyError: 'name' | C-1 | BentoML 1.1.6과 cattrs 26. 1.1.10으로 올린다 |
No module named 'pkg_resources', containerize의 NotImplementedError | A-3 | setuptools<70, click==8.1.7 |
/invocation이 박스를 하나만 돌려줌, 카드 없는 이미지에서 500 | B-2 | 저자 코드의 results[0]. B-3의 수정 |
/render에서 ValueError: unknown file extension | B-3 | 메모리에서 만든 PIL 이미지에 형식이 없다. JPEG로 인코딩한 뒤 다시 연다 |
작업 폴더에 predict, predict2… | B-2 | 저자 코드의 save=True. B-3의 수정 |
DuplicateTimeseries | D-2 | metrics.py의 카운터 이름 중복 |
| 존재하지 않는 영화 ID 추천, 학습 평가와 다른 목록 | D-2 | 인덱스 - 1 누락과 카탈로그 밖 후보. D-3의 수정 |
Registered model alias prod not found | D-2 | 9장 파이프라인은 staging만 만든다. D-1 |
TypeError: code() argument 13 must be str, not int | D-2, E-1 | 모델을 학습한 Python 3.9와 다른 버전에서 불러왔다 |
Bento 잠금에 nvidia- 패키지 | D-5 | Linux PyPI torch는 CUDA 빌드. CPU 휠 주소를 적는다 |
Failed to lock PyPI packages, cp312 | D-5 | 잠금이 다른 파이썬을 잡았다. $env:UV_PYTHON = "3.9" |
Accessing hidden files is not allowed | D-5 | BentoML 1.4는 경로에 .으로 시작하는 폴더가 있으면 빌드를 거부한다. 숨김 폴더 밖에서 빌드한다 |
| 별칭을 옮겼는데 응답 버전이 그대로 | D-6 | 별칭은 시작할 때 한 번 해석된다. 재시작한다 |
mlflow models serve가 non zero return code | E-1 | 다른 uvicorn이 PATH에서 잡혔다. 가상환경의 Scripts를 PATH 앞에 둔다 |
The PyTorch flavor does not support List or Dict input types | E-1 | 두 입력 모델은 PyTorch pyfunc로 서빙할 수 없다. E-2의 래퍼 |
UnicodeEncodeError: 'cp949' codec | E-2 | MLflow의 이모지 출력. $env:PYTHONIOENCODING = "utf-8" |
no matches for kind "ClusterStorageContainer" | F-1 | CRD 등록 전에 적용했다. 같은 명령을 다시 실행한다 |
InferenceService가 계속 False이고 Knative 관련 오류 | F-1 | 기본 모드가 Serverless다. defaultDeploymentMode를 Standard로 |
no runtime found to support predictor | F-5 | 지정한 형식의 ClusterServingRuntime이 없다 |
새 Pod가 Init:CrashLoopBackOff인데 READY는 True | F-6 | 저장 위치가 틀렸다. READY는 기존 Pod 기준이다. rollout status와 응답 헤더로 확인한다 |
이번 실행에서 실제로 만난 것은 pkg_resources, NotImplementedError, Registered model alias prod not found, code() argument 13, Knative 관련 오류를 뺀 나머지다. 빠진 다섯 가지는 6장과 9장에서 만났거나 설정을 미리 바꿔 피한 것이다.
G-2. 정리
- 띄운 서버(
bentoml serve,mlflow models serve, 포트포워딩)를 모두Ctrl+C로 멈춘다. - KServe 배포와 실습 네임스페이스를 지운다. 네임스페이스를 지우면 InferenceService, Secret, ConfigMap이 함께 사라진다.
kubectl delete namespace ch10-serving - KServe 컨트롤러까지 지우려면 설치 파일로 지운다. 다른 장에서 KServe를 쓰지 않을 때만 한다. cert-manager는 6장의 것이므로 지우지 않는다.
kubectl delete -f ch10\kserve\ch10-kserve-core.yaml kubectl delete namespace kserve - MLflow의
ch10-recommender,ch10-recommender-pyfunc등록 모델과 실험ch10-serving, S3의ch10-models버킷은 11장에서 서빙 결과를 볼 때 쓸 수 있으므로 남겨 둔다. 지우려면 MLflow 화면에서 등록 모델과 실험을, 저장소 화면에서 버킷을 지운다.ch10-recommender의 버전은 9장 모델을 가리킬 뿐이라 지워도 9장의 파일은 남는다. - PC의 Bento와 모델 저장소는
ch10\bentoml-home폴더를 지우면 함께 사라진다.