09. 모델 학습과 검증 II: 실습 기록
09. 모델 학습과 검증 II에서 정리한 내용을 책의 코드로 직접 실행한 기록이다. 개념과 요점은 본문에 두고, 여기에는 명령, 실제 출력과 화면만 모았다.
실습 순서
두 파이프라인을 차례로 돌린다. 탐지 파이프라인에서 PVC와 TensorBoard를, 추천 파이프라인에서 S3 직접 읽기와 MLflow 기록, 등록 판단을 본다. 끝으로 등록된 모델을 내려받아 지표를 다시 잰다. 아래 출력과 화면은 2026년 11월 7일에 이 순서로 실행해 얻었다.
    flowchart LR
    accTitle: 9장 실습 순서
    accDescr: 환경과 저자 코드를 준비하고, PVC를 쓰는 탐지 파이프라인을 실행한 뒤 TensorBoard로 학습 로그를 본다. 이어 추천 데이터를 올리고 학습 파이프라인을 두 번 실행해 MLflow에서 비교와 등록을 확인하고, 마지막으로 지표를 다시 계산한 뒤 정리한다.
    A["A. 환경과 코드 준비"] --> B["B. PVC 탐지 파이프라인"]
    B --> C["C. TensorBoard"]
    A --> D["D. 추천 학습 파이프라인"]
    D --> E["E. MLflow 비교와 등록"]
    E --> F["F. 지표 다시 보기"]
    C --> G["G. 문제 해결과 정리"]
    F --> G
| 구간 | 끝났을 때 남는 것 |
|---|---|
| A. 환경과 코드 준비 | 저자 코드 두 저장소, .venv-ch09 가상환경, 제출 스크립트 |
| B. PVC 탐지 파이프라인 | 성공한 ch09-yolo-pvc-pipeline 실행, PVC 안의 분할 데이터와 /data/runs 로그 |
| C. TensorBoard | PVC를 마운트한 ch09-tensorboard 화면, 실행 뒤 PVC 정리 확인 |
| D. 추천 학습 파이프라인 | ch09-datasets 버킷의 parquet, 학습률이 다른 실행 두 개 |
| E. MLflow 비교와 등록 | 실험 ch09-recommender, 등록 모델 ch09-recommender v1, v2와 staging 별칭 |
| F. 지표 다시 보기 | 평점별 RMSE, 전체 후보 Recall@10과 NDCG@10, 인기순 기준선, 사용자 추천 예시 |
| G. 정리 | 지운 PVC, Deployment, 남겨 둘 기록 |
B, C와 D, E, F는 서로 독립이라 순서를 바꿔도 된다. 명령은 ml-platform-book-env 저장소 최상위 폴더의 PowerShell에서 실행하고, 이 장에서 만드는 파일은 ch09\ 폴더에 둔다.
A. 환경과 코드 준비
전체 그림의 ①에 들어가기 전 준비 단계다.
A-1. 클러스터와 화면 확인
- 4장 A-2, A-3과 같이 클러스터를 설치하고, 두 번째 터미널에서 포트포워딩을 켜 둔다.
python bookenv.py status python bookenv.py forward - PVC를 만들 StorageClass 이름을 확인한다. 책은
local-path를 쓰지만 kind에서는 이름이standard다.kubectl get storageclassNAME PROVISIONER RECLAIMPOLICY VOLUMEBINDINGMODE ALLOWVOLUMEEXPANSION AGE standard (default) rancher.io/local-path Delete WaitForFirstConsumer false 10mWaitForFirstConsumer는 PVC를 마운트할 Pod가 생겨야 실제 볼륨을 만든다는 뜻이다. 실행을 중간에 취소하면 PVC가Pending으로 남는 것도 이 때문이다. - http://localhost:8888/buckets/ 에
mlflow-artifacts와mlpipeline이 있는지 본다. 없으면python bookenv.py buckets를 한 번 실행한다.
A-2. 저자 코드와 가상환경
9장 전용 저자 저장소는 없다. PVC와 TensorBoard 코드는 object-detection-project, 추천 학습 코드는 movie-recommender-project에 있다.
- 두 저장소를 받고 이 글에서 확인한 커밋으로 고정한다.각각 2025-01-02, 2025-04-18 커밋이다.
git clone https://github.com/practical-mlops/object-detection-project.git upstream/object-detection-project git -C upstream/object-detection-project checkout c6afb11 git clone https://github.com/practical-mlops/movie-recommender-project.git upstream/movie-recommender-project git -C upstream/movie-recommender-project checkout 4e0a808 - 컴파일과 제출용 가상환경을 만든다. KFP SDK는 저자
requirements.txt와 같은 2.11.0이고, MLflow는 서버와 같은 3.0.0이다.책의uv venv .venv-ch09 --python 3.12 uv pip install --python .venv-ch09 kfp==2.11.0 kfp-kubernetes==1.4.0 mlflow==3.0.0 boto3 pandas pyarrow scikit-learn .\.venv-ch09\Scripts\Activate.ps1pip install kfp[kubernetes]가 설치하는 것이kfp-kubernetes패키지다. SDK 버전이 중요한 이유는 컴포넌트의 기본 이미지를 정하기 때문이다. 2.9.0으로 컴파일하면 기본 이미지가python:3.8인데, MLflow 3.0.0은 Python 3.9 이상이 필요하다. 2.11.0의 기본 이미지는python:3.9다.
A-3. 제출 스크립트
UI에서 YAML을 올려도 되지만, 같은 파이프라인을 파라미터만 바꿔 여러 번 돌릴 것이라 스크립트로 제출한다. 파이프라인이 이미 있으면 새 버전으로 올리고, KFP 실험 ch09에 실행을 만든다.
ch09\submit.py:
import argparse
import json

import kfp

parser = argparse.ArgumentParser()
parser.add_argument("package")
parser.add_argument("--pipeline", required=True)
parser.add_argument("--run", required=True)
parser.add_argument("--params", default="{}")
parser.add_argument("--host", default="http://127.0.0.1:8080")
args = parser.parse_args()

client = kfp.Client(host=args.host)
pipeline_id = client.get_pipeline_id(args.pipeline)
if pipeline_id is None:
    pipeline = client.upload_pipeline(args.package, pipeline_name=args.pipeline)
    pipeline_id = pipeline.pipeline_id
    version_id = client.list_pipeline_versions(pipeline_id).pipeline_versions[0].pipeline_version_id
else:
    version = client.upload_pipeline_version(
        args.package, pipeline_version_name=args.run, pipeline_id=pipeline_id)
    version_id = version.pipeline_version_id

experiment = client.create_experiment("ch09")
run = client.run_pipeline(
    experiment_id=experiment.experiment_id, job_name=args.run,
    pipeline_id=pipeline_id, version_id=version_id,
    params=json.loads(args.params), enable_caching=False)
print("run", run.run_id)enable_caching=False를 넘겨도 파이프라인 ID로 실행하면 컴파일된 YAML의 캐시 설정이 그대로 쓰였다. 캐시는 B-5에서 보듯 파이프라인 코드에서 꺼야 한다.
완료 기준: kubectl get storageclass에 standard가 보이고, python -c "import kfp, mlflow; print(kfp.__version__, mlflow.__version__)"가 2.11.0 3.0.0을 출력한다.
B. PVC 탐지 파이프라인
탐지 파이프라인을 PVC 위에서 돌린다. 전체 그림의 ①, ③, ④, ⑤를 지난다.
B-1. 저자 코드 고치기
upstream\object-detection-project\pipeline_with_pvc.py를 앞의 표대로 고친다. 핵심 변경만 옮기면 다음과 같다.
# split_dataset: 이미지와 라벨을 파일 이름으로 짝짓는다
stem = lambda p: os.path.splitext(os.path.basename(p))[0]
mismatched = sum(stem(i) != stem(l) for i, l in zip(images, labels))
print(f"images={len(images)} labels={len(labels)} "
      f"mismatched pairs in original order={mismatched}")
label_by_stem = {stem(l): l for l in labels}
images = sorted(i for i in images if stem(i) in label_by_stem)
labels = [label_by_stem[stem(i)] for i in images]

# TRAINING_SCRIPT: 로그를 PVC에 남긴다
results = model.train(data=data_yaml_path, imgsz=args.imgsz, epochs=args.epochs,
                      batch=args.batch, project='/data/runs',
                      name=args.model_name, exist_ok=True)
best_model_source = os.path.join('/data/runs', args.model_name, "weights", "best.pt")

# train_model: 검증과 같은 CPU 이미지, TensorBoard 기록 켜기
image='ultralytics/ultralytics:8.3.56-cpu',
# args 앞부분
#   pip install --no-cache-dir tensorboard && yolo settings tensorboard=True &&
#   cat << 'EOF' > /tmp/train.py ... python3 /tmp/train.py ... --imgsz "$5"

# pipeline
pvc = kubernetes.CreatePVC(
    pvc_name_suffix='-ch09-yolo',
    access_modes=['ReadWriteOnce'],
    size='5Gi',
    storage_class_name='standard',
)
pvc_name = pvc.outputs['name']
download_op = download_dataset().set_caching_options(False)
split_op = split_dataset(random_state=random_state).after(download_op).set_caching_options(False)
train_op = train_model(epochs=epochs, batch=batch, yolo_model_name=yolo_model_name,
                       imgsz=imgsz).after(split_op).set_caching_options(False)
파이프라인 이름은 다른 실습과 겹치지 않게 ch09-yolo-pvc-pipeline으로 바꿨다. CPU에서도 끝나도록 이미지 크기는 파라미터 imgsz로 뺐고, 기본값은 책과 같은 640이다.
B-2. 이미지 준비
학습과 검증이 쓰는 ultralytics/ultralytics:8.3.56-cpu는 풀어 놓으면 7.8GB다. 노드가 직접 받게 둬도 되지만, 미리 받아 kind 노드에 넣어 두면 실행 시간을 예측하기 쉽다.
docker pull ultralytics/ultralytics:8.3.56-cpu
kind load docker-image ultralytics/ultralytics:8.3.56-cpu --name book-env
kind load가 content digest not found로 실패하면 docker save ultralytics/ultralytics:8.3.56-cpu -o ultralytics.tar 후 kind load image-archive ultralytics.tar --name book-env를 쓴다. 디스크 여유가 20GB 이상 필요하고, 노드에 넣은 뒤에는 PC 쪽 이미지를 docker rmi로 지워도 된다.
B-3. 실행 제출
- 컴파일한다.
cd upstream\object-detection-project python pipeline_with_pvc.py cd ..\..ch09_yolo_pvc_pipeline.yaml이 생긴다. - 실행을 만든다. 3 epoch, 배치 8, 이미지 크기 320으로 줄였다.이 글에서 성공한 실행이 네 번째라 이름이
python ch09\submit.py upstream\object-detection-project\ch09_yolo_pvc_pipeline.yaml --pipeline ch09-yolo-pvc-pipeline --run ch09-yolo-pvc-run-4 --params '{"epochs":3,"batch":8,"imgsz":320}'run-4다. 앞의 세 번은 B-5와 G의 실패 사례다.
다운로드(1.2GB), 분할, 3 epoch 학습(약 5분), 검증까지 모두 약 15분 걸렸다.
B-4. PVC와 그래프 확인
createpvc가 끝나면 PVC가 생긴다. 이름 앞부분은 실행마다 다르다.kubectl -n kubeflow get pvcNAME STATUS VOLUME CAPACITY ACCESS MODES STORAGECLASS 65a853f2-87d4-4404-bd95-b548c5446dc6-ch09-yolo Bound pvc-c1b1067d-4948-4f89-85ea-a4ddd3d70fde 5Gi RWO standardKFP 화면의 Runs에서 실행을 연다. 모든 단계가
createpvc에서 갈라져 나오는 그래프로, 책의 그림 9.2, 9.3에 해당한다. 마지막deletepvc는 검증이 끝난 뒤에 돈다.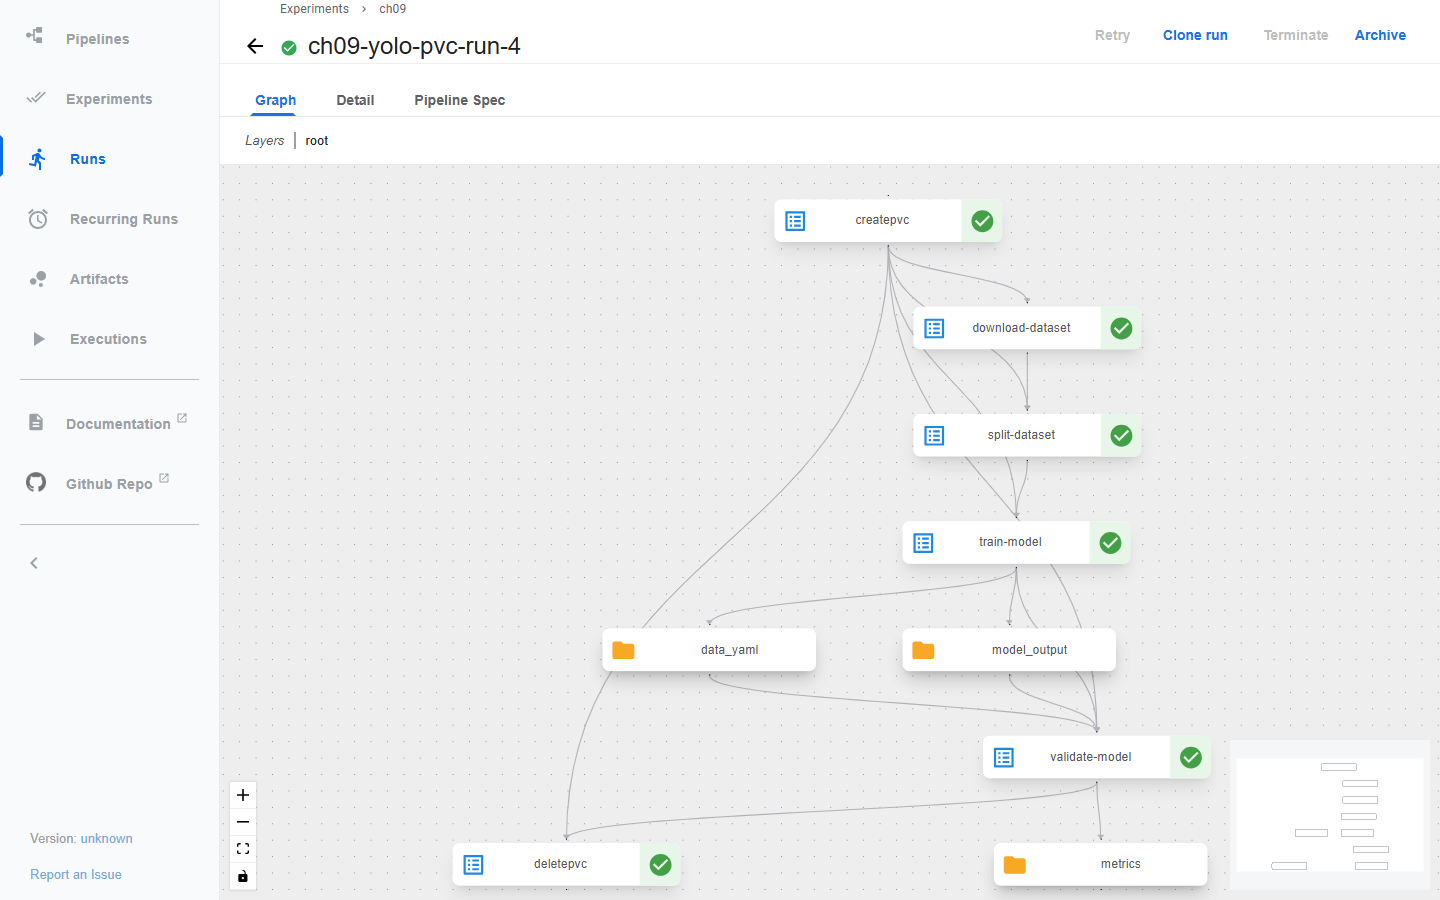
createpvc를 누르고 Input/Output을 보면 출력 파라미터name에 실제 PVC 이름이 있다. 책의 그림 9.5가 TensorBoard를 만들 때 적어 두라고 한 값이다.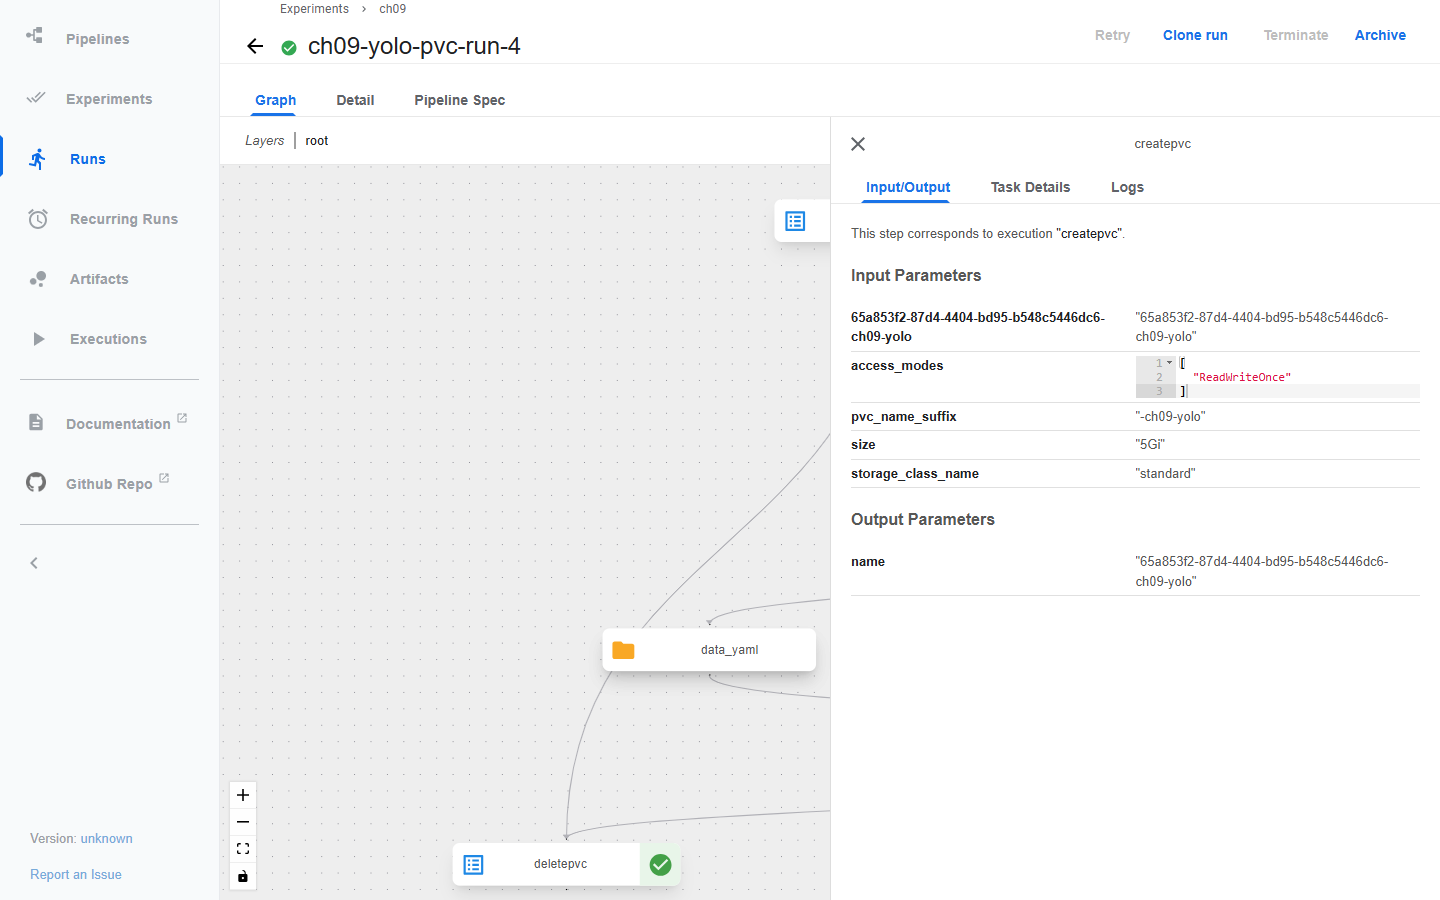
B-5. 분할 로그와 캐시 실패
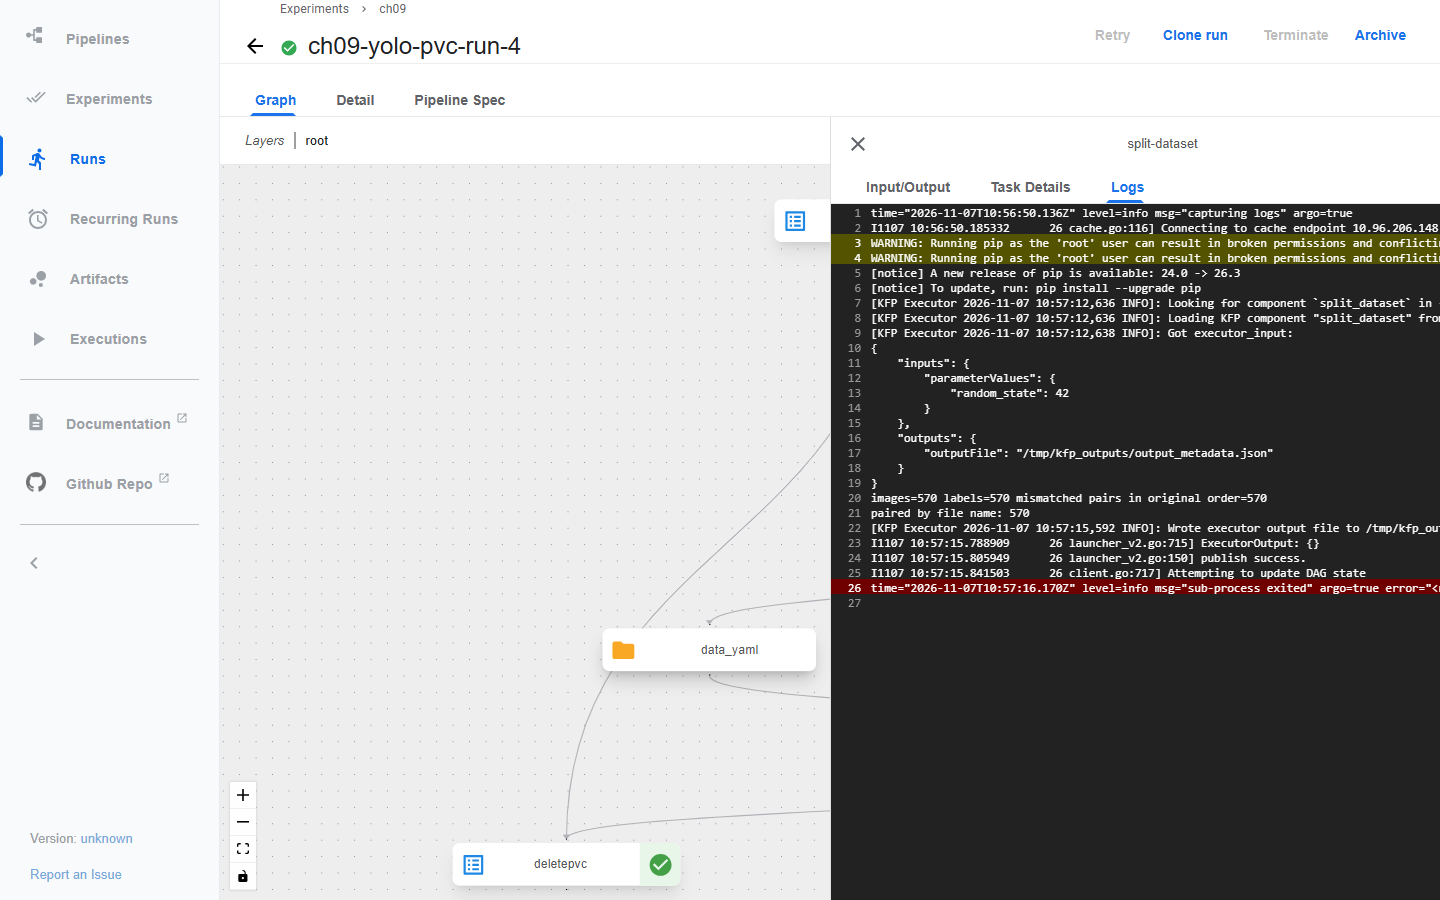
split-dataset의 Logs에서 B-1에서 넣은 확인 줄을 본다.images=570 labels=570 mismatched pairs in original order=570 paired by file name: 570저자 코드 그대로였다면 570쌍 모두 엉뚱한 파일끼리 묶인 채 분할됐을 것이다.
캐시와 PVC의 충돌은 두 번째 실행에서 드러났다. 파라미터가 첫 실행과 같아
download-dataset과split-dataset이 캐시로 처리됐고(구름 모양 아이콘), 학습은 새로 만든 빈 PVC에서 시작해 실패했다.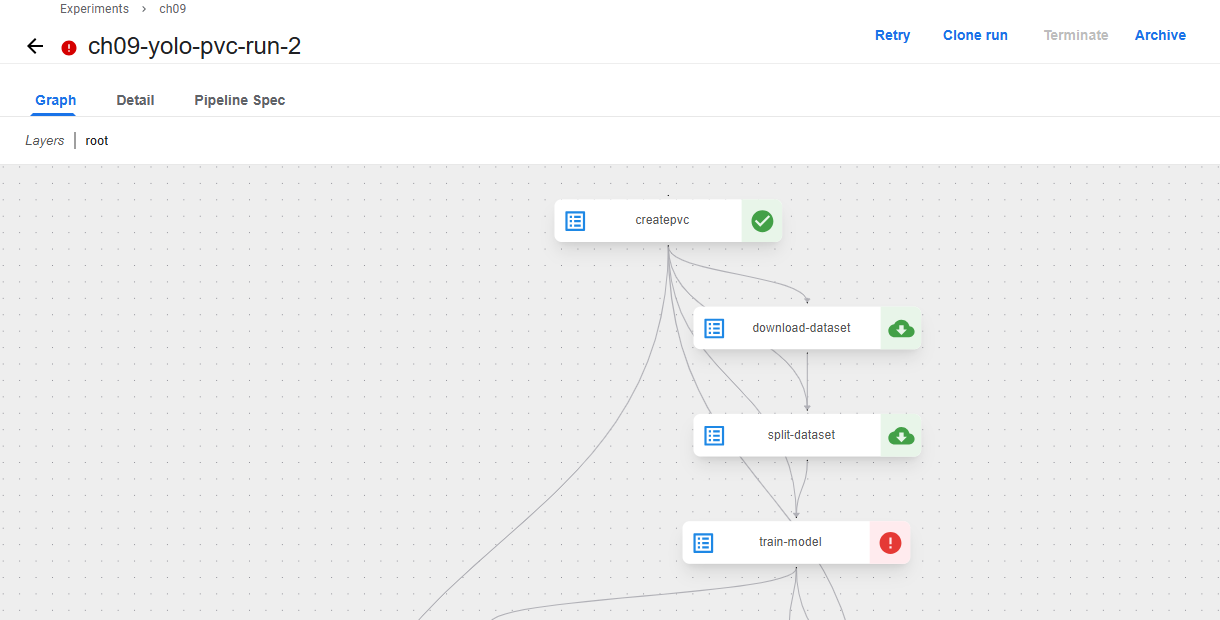
Dataset '.../data_yaml/data.yaml' images not found, missing path '/data/val/images'KFP 캐시는 입력과 출력 아티팩트만 보고 같은 작업인지 판단한다. PVC에 쓴 내용은 KFP가 모르는 외부 상태다. PVC에 결과를 남기는 단계는 캐시를 꺼야 한다.
B-6. 학습과 검증 결과
train-model 로그의 끝부분이다. TensorBoard 기록이 켜졌고 결과는 PVC의 /data/runs에 저장됐다.
TensorBoard: Start with 'tensorboard --logdir /data/runs/yolov8n_custom', view at http://localhost:6006/
TensorBoard: model graph visualization added ✅
Starting training for 3 epochs...
                   all         85         85      0.999          1      0.995      0.964
3 epochs completed in 0.078 hours.
Results saved to /data/runs/yolov8n_custom
열은 이미지 수, 객체 수, precision, recall, mAP50, mAP50-95 순이다. 분할은 train 427장, val 85장, test 58장이다. validate-model도 같은 val 85장으로 똑같은 0.995, 0.964를 냈다. 앞에서 본 대로 학습이 best.pt를 고를 때 쓴 데이터로 잰 값이고, test 58장은 쓰이지 않았다.
완료 기준: 실행의 모든 단계가 초록색이고, kubectl -n kubeflow get pvc에서 이 실행의 PVC를 찾을 수 있다.
C. TensorBoard
⑤, ⑥에서 학습 로그를 그래프로 본다.
C-1. PVC를 마운트한 TensorBoard 띄우기
책은 Kubeflow 대시보드의 TensorBoards > New TensorBoard에서 PVC를 고른다. KFP만 설치한 이 환경에는 그 메뉴가 없어 같은 일을 하는 Deployment를 만든다. claimName에는 B-4에서 본 PVC 이름을 넣는다. 책의 순서처럼 createpvc가 끝났다면 학습 도중에 띄워도 된다.
ch09\tensorboard.yaml을 만든다.apiVersion: apps/v1 kind: Deployment metadata: name: ch09-tensorboard namespace: kubeflow spec: replicas: 1 selector: matchLabels: {app: ch09-tensorboard} template: metadata: labels: {app: ch09-tensorboard} spec: containers: - name: tensorboard image: python:3.11 command: ["bash", "-c"] args: ["pip install --no-cache-dir -q tensorboard && exec tensorboard --logdir /data/runs --host 0.0.0.0 --port 6006 --reload_interval 15"] ports: [{containerPort: 6006}] resources: requests: {cpu: 100m, memory: 256Mi} limits: {cpu: "1", memory: 1Gi} volumeMounts: - {name: pipeline-data, mountPath: /data, readOnly: true} volumes: - name: pipeline-data persistentVolumeClaim: {claimName: 65a853f2-87d4-4404-bd95-b548c5446dc6-ch09-yolo, readOnly: true}- 적용하고, 세 번째 터미널에서 포트를 연결한다. 포트는 8888과 6006 대신 비어 있는 6009를 썼다.Pod가
kubectl apply -f ch09\tensorboard.yaml kubectl -n kubeflow get pods -l app=ch09-tensorboard kubectl -n kubeflow port-forward deployment/ch09-tensorboard 6009:6006Running이 되기까지pip install때문에 30초 정도 걸린다.
학습 Pod와 TensorBoard Pod가 같은 PVC를 동시에 마운트할 수 있는 것은 둘이 같은 노드에 있어서다. RWO의 “Once"는 노드 단위다.
C-2. 스칼라와 그래프 보기
http://127.0.0.1:6009/#timeseries 를 열고 위쪽 태그 필터에
metrics/mAP|val/box를 입력한다. 실행yolov8n_custom의 epoch별 mAP50, mAP50-95, 검증 box 손실이 나온다. 책의 그림 9.9에 해당한다.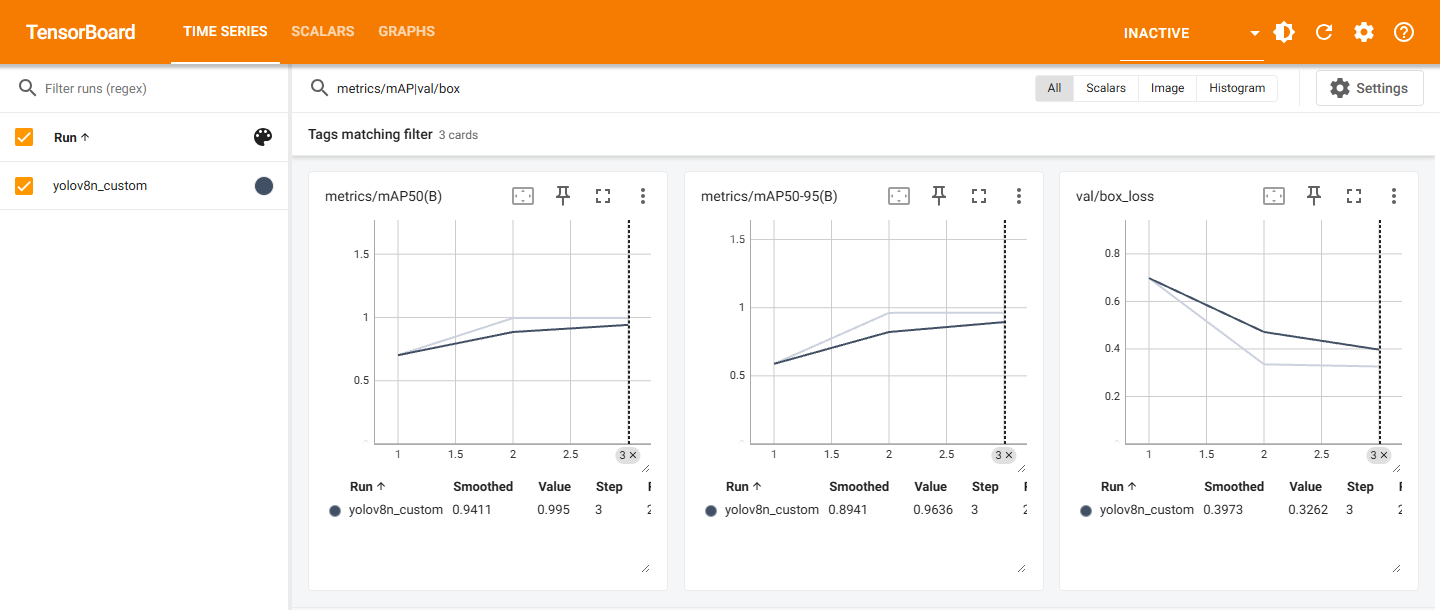
3 epoch뿐이라 곡선이라기보다 점 세 개다. 그래도 val 손실이 줄고 mAP가 오르는 방향과
lr/pg0같은 학습률 스케줄은 읽을 수 있다.GRAPHS 탭에서 모델 그래프를 본다. 로그의
model graph visualization added가 남긴 것으로 책의 그림 9.10에 해당한다. 처음에는input,DetectionModel,output세 상자로 접혀 있다.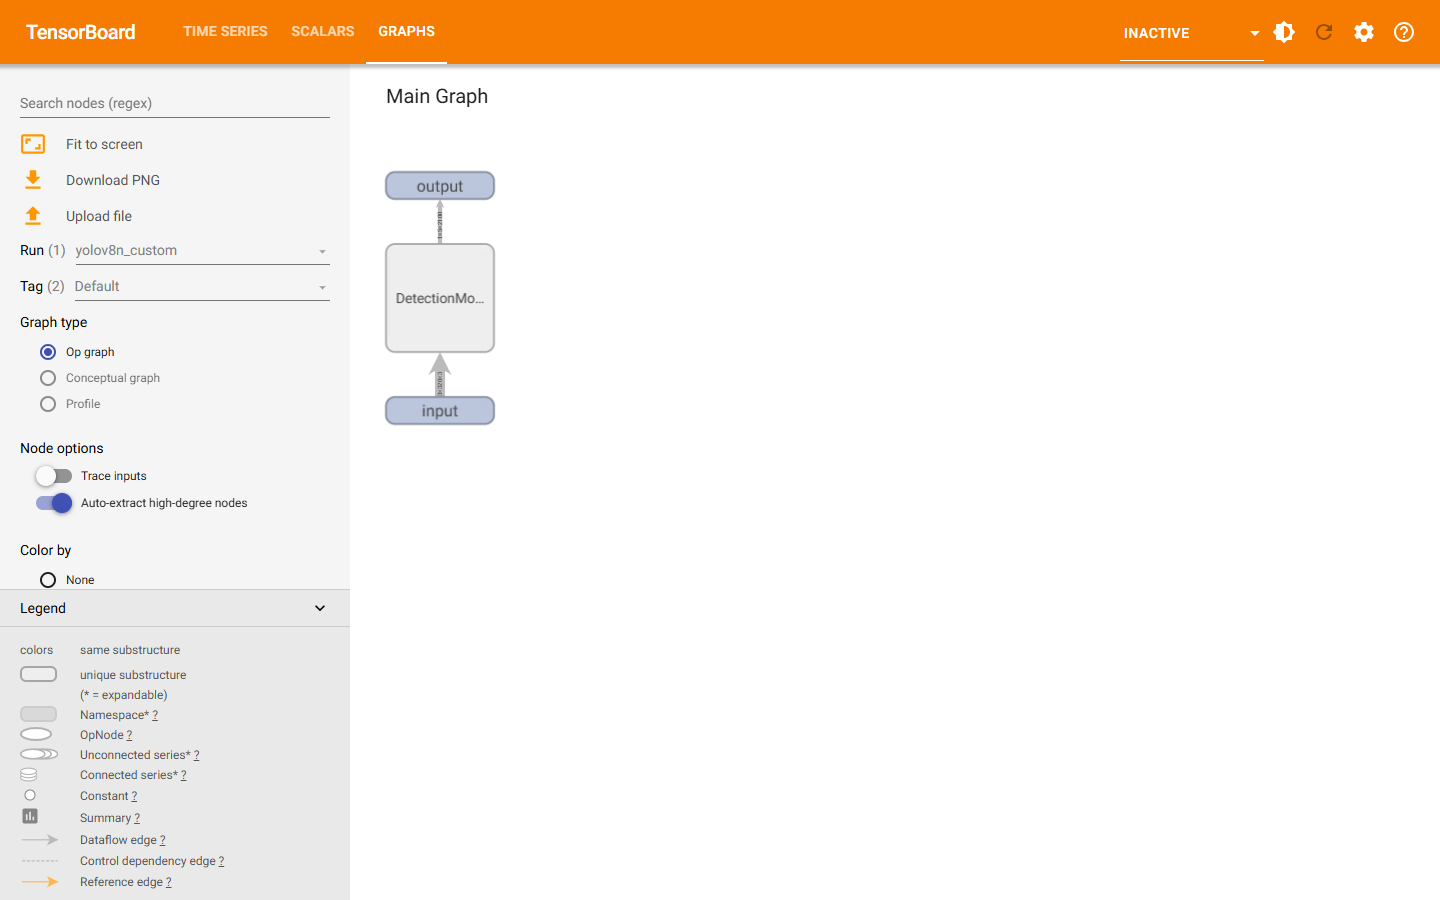
C-3. 실행이 끝난 뒤의 PVC
실행이 성공하면 마지막 deletepvc가 PVC 삭제를 요청한다. 하지만 TensorBoard가 아직 마운트하고 있으면 PVC는 바로 사라지지 않는다.
kubectl -n kubeflow get pvc 65a853f2-87d4-4404-bd95-b548c5446dc6-ch09-yolo
kubectl -n kubeflow describe pvc 65a853f2-87d4-4404-bd95-b548c5446dc6-ch09-yolo
NAME STATUS VOLUME CAPACITY ACCESS MODES STORAGECLASS
65a853f2-87d4-4404-bd95-b548c5446dc6-ch09-yolo Terminating pvc-c1b1067d-4948-4f89-85ea-a4ddd3d70fde 5Gi RWO standard
Used By: ch09-tensorboard-56fd9f7964-wmknp
ch09-yolo-pvc-pipeline-sb4jq-system-container-impl-1703972427
ch09-yolo-pvc-pipeline-sb4jq-system-container-impl-217696017
ch09-yolo-pvc-pipeline-sb4jq-system-container-impl-3320485420
ch09-yolo-pvc-pipeline-sb4jq-system-container-impl-95559514Used By에는 TensorBoard뿐 아니라 이미 끝난 작업 Pod 네 개도 있다. Kubernetes는 PVC를 참조하는 Pod가 남아 있는 동안 삭제를 미룬다. 덕분에 실행이 끝난 뒤에도 TensorBoard로 로그를 볼 수 있지만, 그동안 디스크도 계속 차지한다.
실패해서 deletepvc까지 가지 못한 실행의 PVC는 Bound로 남는다. 이번에도 실패하거나 취소한 세 실행의 PVC가 남아 있었다. 그중 실패한 두 실행의 PVC는 삭제를 요청해도 Terminating에 머물렀고, 그 실행의 끝난 Pod를 지우고 나서야 사라졌다. 정리 명령은 G-2에 모았다.
완료 기준: TensorBoard 화면에 mAP 곡선이 보이고, 정리 뒤 kubectl -n kubeflow get pvc에 ch09-yolo PVC가 남지 않는다.
D. 추천 학습 파이프라인
추천 쪽은 전체 그림의 ②, ③, ⑦, ⑧, ⑨를 차례로 지난다.
D-1. 데이터 준비와 업로드
책은 7장의 데이터 준비 파이프라인이 datasets 버킷의 ml-25m/에 올린 MovieLens 25M(평점 2,500만 개)을 쓴다. 이 실습은 CPU에서 끝내기 위해 같은 GroupLens의 ml-latest-small(평점 100,836개, 사용자 610명, 영화 9,724편)을 쓴다. 나누는 방식은 7장의 split_dataset과 같고(train_test_split, 75:15:10, random_state=42), 결과는 별도 버킷 ch09-datasets에 올린다. 규모가 250분의 1이라 지표 값을 책과 비교할 수는 없다. MovieLens는 GroupLens 이용 조건에 따라 연구와 학습 목적으로만 쓰고, 내려받은 파일은 저장소에 커밋하지 않는다.
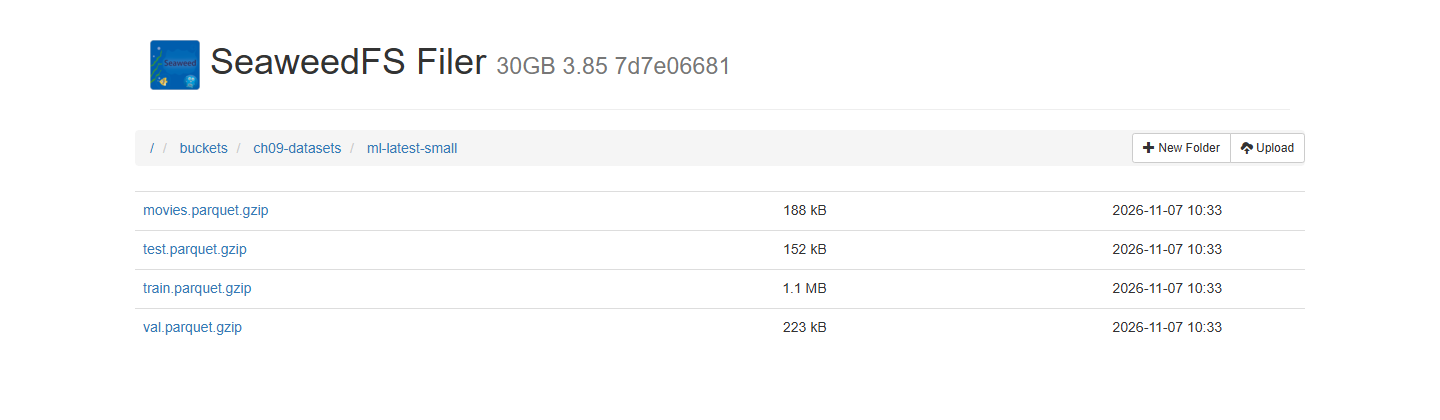
ch09\data폴더에서 원본을 받는다.New-Item -ItemType Directory -Force ch09\data | Out-Null curl.exe -L -o ch09\data\ml-latest-small.zip https://files.grouplens.org/datasets/movielens/ml-latest-small.zipch09\prepare_movielens.py를 만들고 실행한다.import os, zipfile import boto3 import pandas as pd from sklearn.model_selection import train_test_split os.chdir(os.path.join(os.path.dirname(__file__), "data")) z = zipfile.ZipFile("ml-latest-small.zip") ratings = pd.read_csv(z.open("ml-latest-small/ratings.csv")) movies = pd.read_csv(z.open("ml-latest-small/movies.csv")) print(ratings.shape, list(ratings.columns), ratings.userId.max(), ratings.movieId.max()) train, test = train_test_split(ratings, test_size=0.25, random_state=42) val, test = train_test_split(test, test_size=0.10 / 0.25, random_state=42) os.makedirs("ml-latest-small", exist_ok=True) for name, df in [("train", train), ("test", test), ("val", val)]: df.to_parquet(f"ml-latest-small/{name}.parquet.gzip", compression="gzip") print(name, df.shape) movies.to_parquet("ml-latest-small/movies.parquet.gzip", compression="gzip") s3 = boto3.client("s3", endpoint_url="http://127.0.0.1:9000", aws_access_key_id="minio", aws_secret_access_key="minio123") if "ch09-datasets" not in [b["Name"] for b in s3.list_buckets()["Buckets"]]: s3.create_bucket(Bucket="ch09-datasets") for f in sorted(os.listdir("ml-latest-small")): s3.upload_file(f"ml-latest-small/{f}", "ch09-datasets", f"ml-latest-small/{f}")python ch09\prepare_movielens.py(100836, 4) ['userId', 'movieId', 'rating', 'timestamp'] 610 193609 train (75627, 4) test (10084, 4) val (15125, 4)http://localhost:8888/buckets/ch09-datasets/ml-latest-small/ 에서 파일 네 개를 확인한다. 전체 그림의 ②가 남긴 결과다.
D-2. 저자 코드 고치기
upstream\movie-recommender-project에서 실행을 막는 부분만 고친다.
| 파일 | 변경 | 이유 |
|---|---|---|
02_training_and_validation.py | mlflow_uri 기본값을 http://mlflow-service.mlflow.svc.cluster.local:5000으로 | 저자 기본값은 저자 집의 IP(192.168.1.90:8080)다 |
| 같은 파일 | qa_data에 dataset과 min_rows를 넘기는 qa_min_rows 파라미터 추가 | 저자 코드는 데이터셋 이름을 넘기지 않아 항상 ml-25m을 읽고, 1,875만 행 이상을 요구한다 |
| 같은 파일 | 학습, 검증, 등록 단계에 MLFLOW_S3_ENDPOINT_URL, AWS_ACCESS_KEY_ID, AWS_SECRET_ACCESS_KEY 환경 변수 | 아티팩트를 Pod가 직접 올리는 구성이다 |
model_training.py, model_validation.py, model_registration.py | mlflow를 mlflow==3.0.0으로 고정하고 boto3 추가 | 클라이언트를 서버 버전에 맞추고, S3 업로드와 다운로드에 boto3가 필요하다 |
model_registration.py | current_staging is not None and ..., 하드코딩한 recommender_production 대신 registered_model_name, 비교 지표 출력 | 첫 등록 오류와 이름 충돌 |
model_training.py | log_metric에 문자열 대신 float 전달 | 필수는 아니다. MLflow 3.0.0은 문자열 "0.912345"도 받아들였다. 다만 :3f는 소수 셋째 자리 반올림이 아니라 폭 지정이라 의도와도 다르다 |
파이프라인에 넣은 환경 변수 부분이다.
promote = promote_model_to_staging(...).after(val).set_caching_options(False)

for task in (training, val, promote):
    task.set_env_variable('MLFLOW_S3_ENDPOINT_URL', 'http://minio-service.kubeflow.svc.cluster.local:9000')
    task.set_env_variable('AWS_ACCESS_KEY_ID', 'minio')
    task.set_env_variable('AWS_SECRET_ACCESS_KEY', 'minio123')
실습 편의로 키를 코드에 적었지만, 실제로는 kfp.kubernetes.use_secret_as_env로 Secret에서 읽어야 한다. 데이터 준비 컴포넌트에도 같은 키가 코드에 박혀 있다.
D-3. 학습률 두 가지로 실행
책의 표 9.1, 9.2처럼 학습률만 바꾼 실행 두 개를 만든다. 다른 사람의 실습과 겹치지 않게 MLflow 실험과 등록 모델 이름은 ch09-recommender로 했다. CPU에서 끝나도록 epoch는 책의 30 대신 10이다.
cd upstream\movie-recommender-project
python 02_training_and_validation.py
cd ..\..
$common = '"minio_bucket":"ch09-datasets","training_dataset_name":"ml-latest-small","qa_min_rows":70000,"training_epochs":10,"mlflow_experiment_name":"ch09-recommender","mlflow_registered_model_name":"ch09-recommender"'
python ch09\submit.py upstream\movie-recommender-project\compiled_pipelines\ch09_training_pipeline.yaml --pipeline ch09-recommender-training --run ch09-rec-lr-0.001 --params "{$common}"
첫 실행이 끝나 staging이 생긴 뒤 두 번째를 제출한다. 순서가 바뀌면 등록 판단의 비교 대상이 달라진다.
python ch09\submit.py upstream\movie-recommender-project\compiled_pipelines\ch09_training_pipeline.yaml --pipeline ch09-recommender-training --run ch09-rec-lr-0.01 --params "{$common,`"training_learning_rate`":0.01}"한 실행에 1520분쯤 걸렸다. 학습 자체는 49분이고, 나머지는 학습과 검증 Pod가 매번 torch를 pip install하는 시간이다.
D-4. 그래프와 로그 확인
실행 그래프는 책의 리스팅 9.16 그대로다. 앞의 두 단계는
.after()로만 이어지고, 데이터는negative_sampled_dataset,testing_dataset,validation_dataset아티팩트로 넘어간다.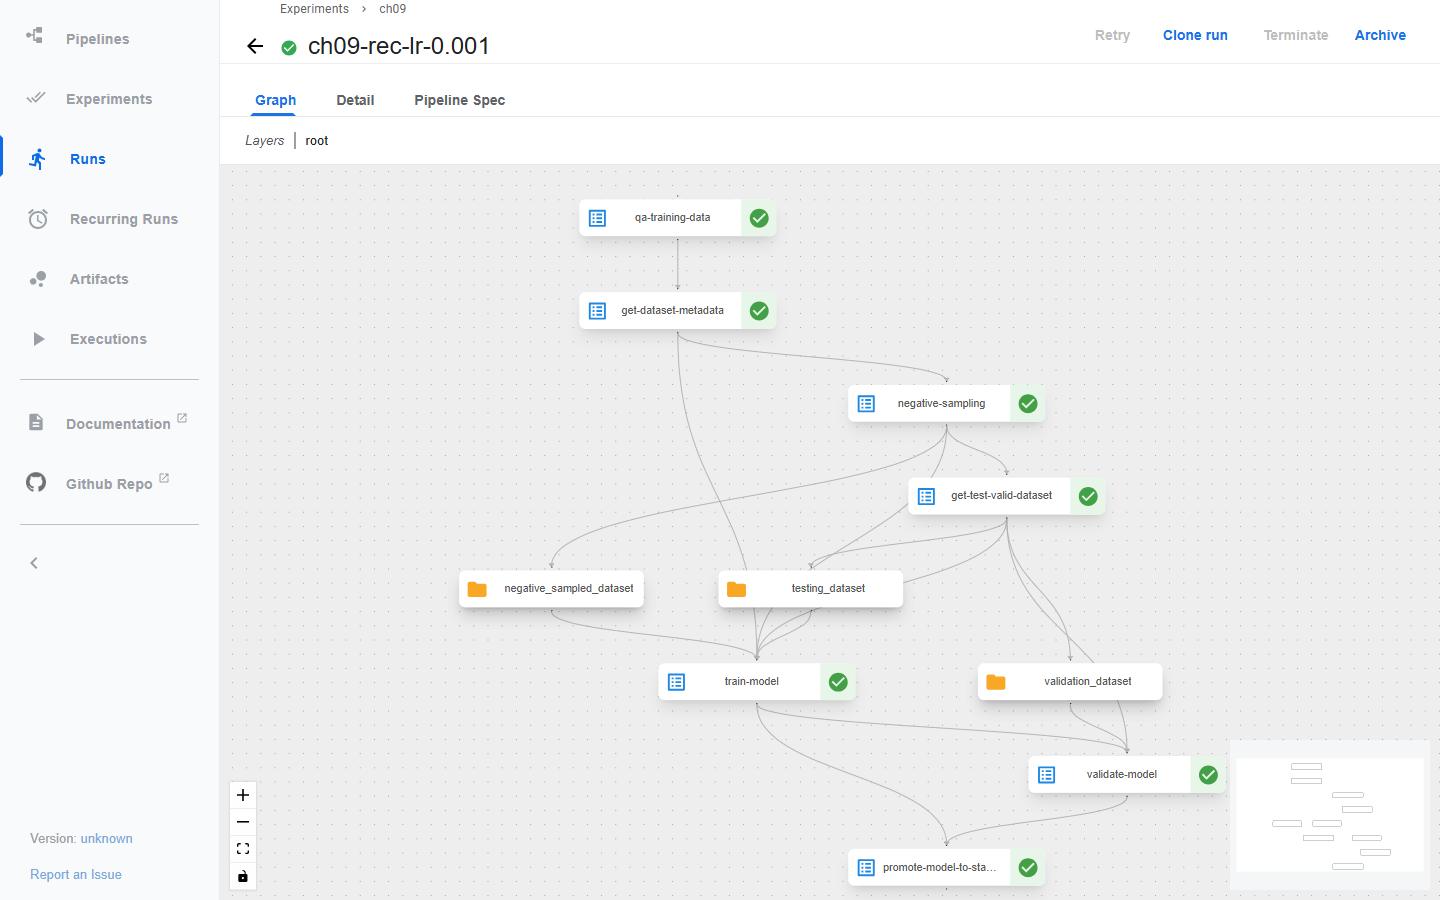
qa-training-data로그에 실제 열 이름과 타입이 찍힌다. 책 리스팅 9.10의user_id,item_id와 다르다.Running QA {'userId': dtype('int64'), 'movieId': dtype('int64'), 'rating': dtype('float64'), 'timestamp': dtype('int64')} (75627, 4) QA passed!train-model의 Input/Output에서 파라미터와training_data_metadata를 본다.n_items가 영화 수 9,724가 아니라 최대 ID 193,609다.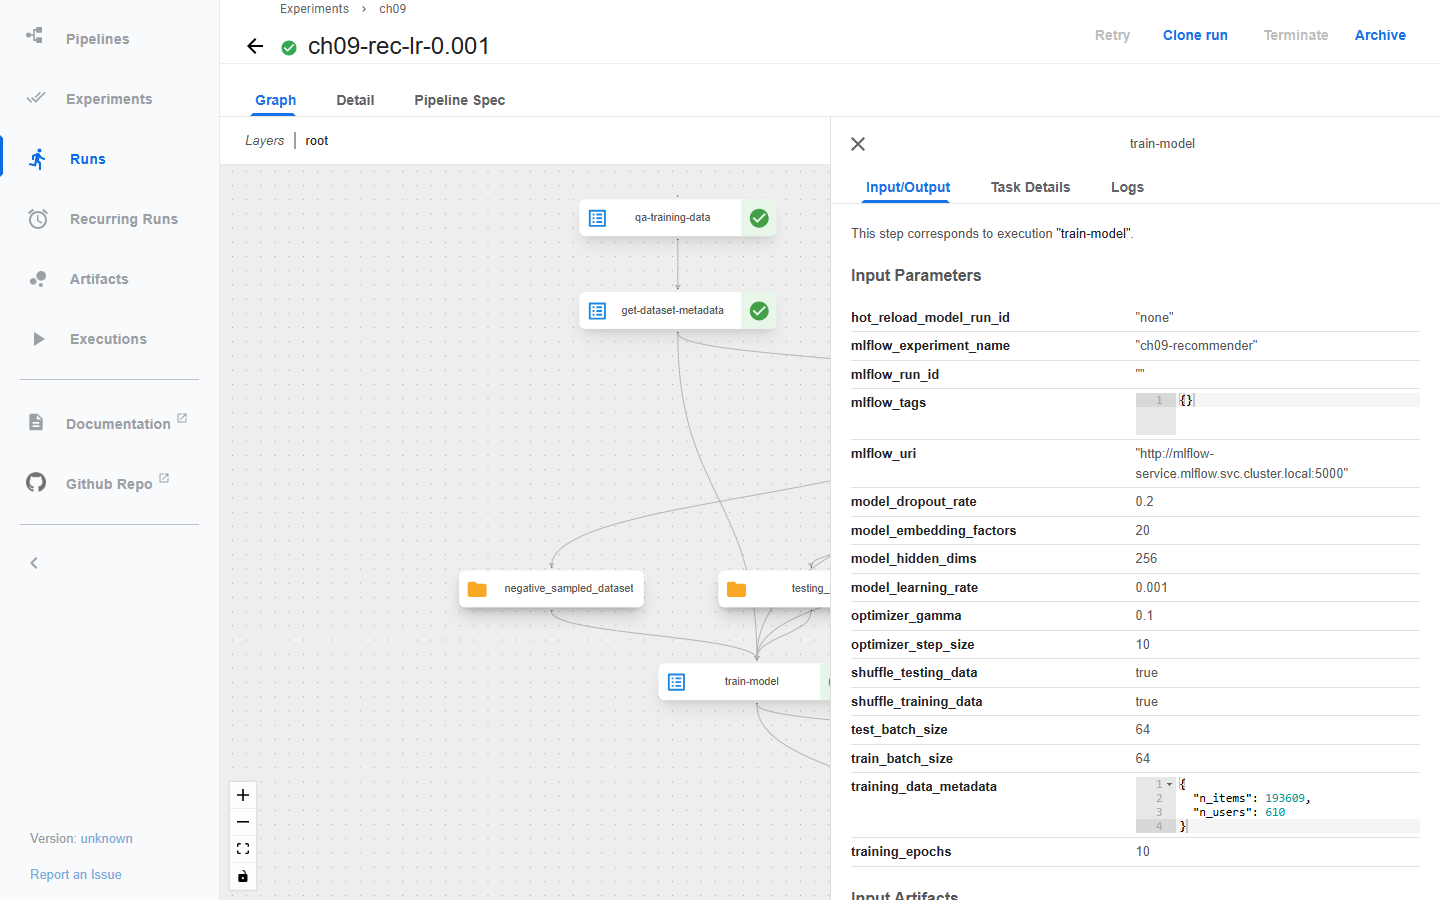
validate-model의 Logs에서 입력으로 받은model_run_id와 계산한 지표를 본다. 학습 단계가 출력한 문자열이 그대로 검증 단계의 입력이 된다.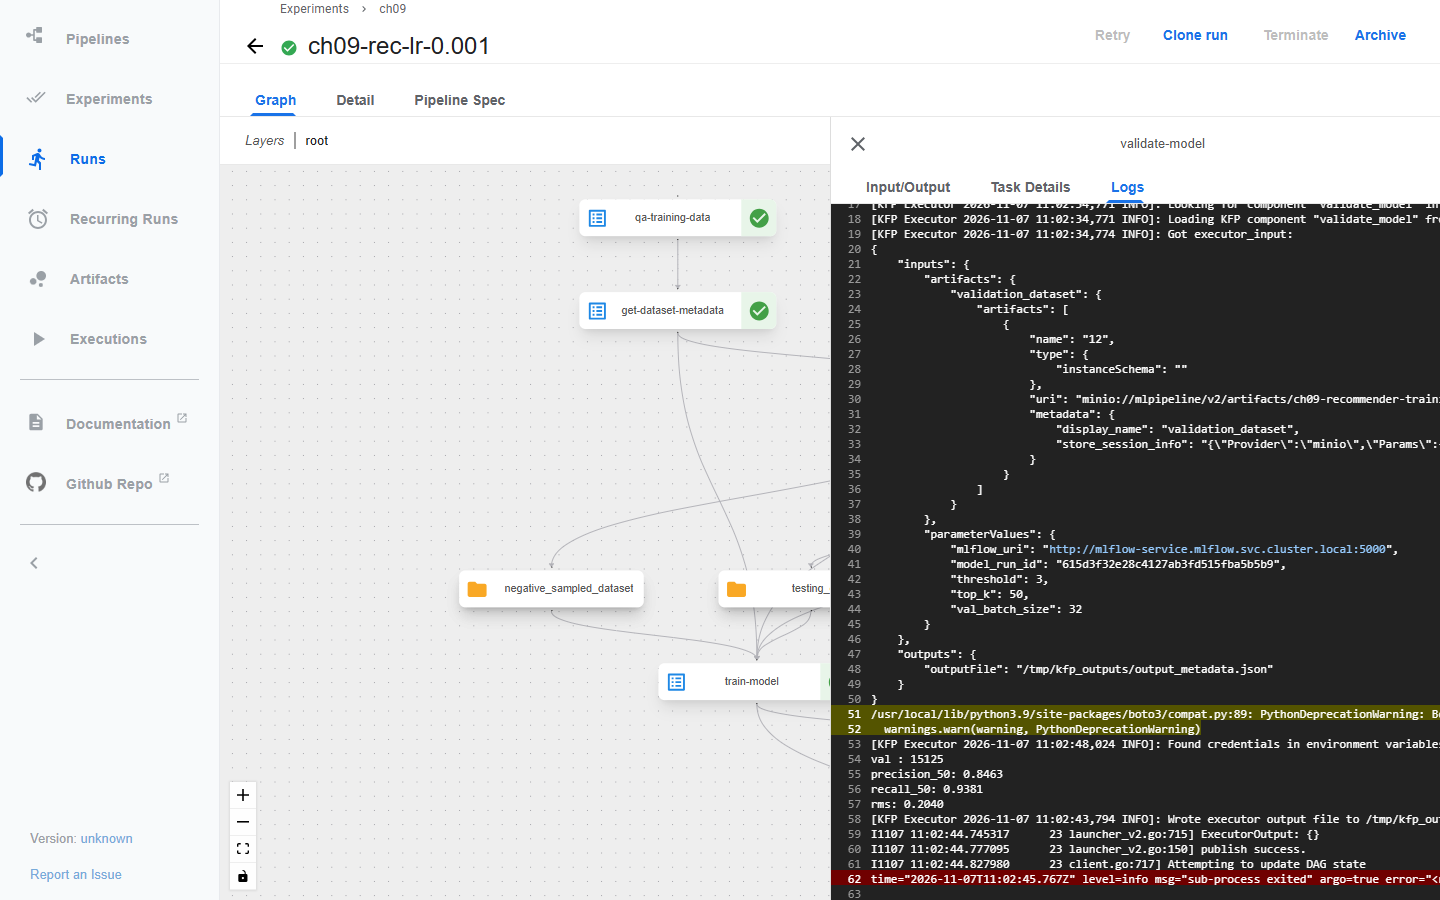
완료 기준: 두 실행 모두 promote-model-to-staging까지 초록색이다.
E. MLflow 비교와 등록
두 실행을 비교하고 등록하는 ⑧, ⑨, ⑩ 구간이다.
E-1. 실행 비교
http://localhost:5000 에서 실험
ch09-recommender를 열면 run이 두 개 있다. 이름은 MLflow가 무작위로 붙였으니 파라미터model_learning_rate로 구분한다.efficient-pug-796이 0.001,capable-mink-204가 0.01이다.목록 위의 차트 보기 버튼을 누르면 epoch별 손실과 검증 지표가 run별로 겹쳐 그려진다. 책의 그림 9.11에 해당한다. 두 run을 체크하고 Compare를 누르면 파라미터와 지표를 표로 나란히 볼 수 있다.
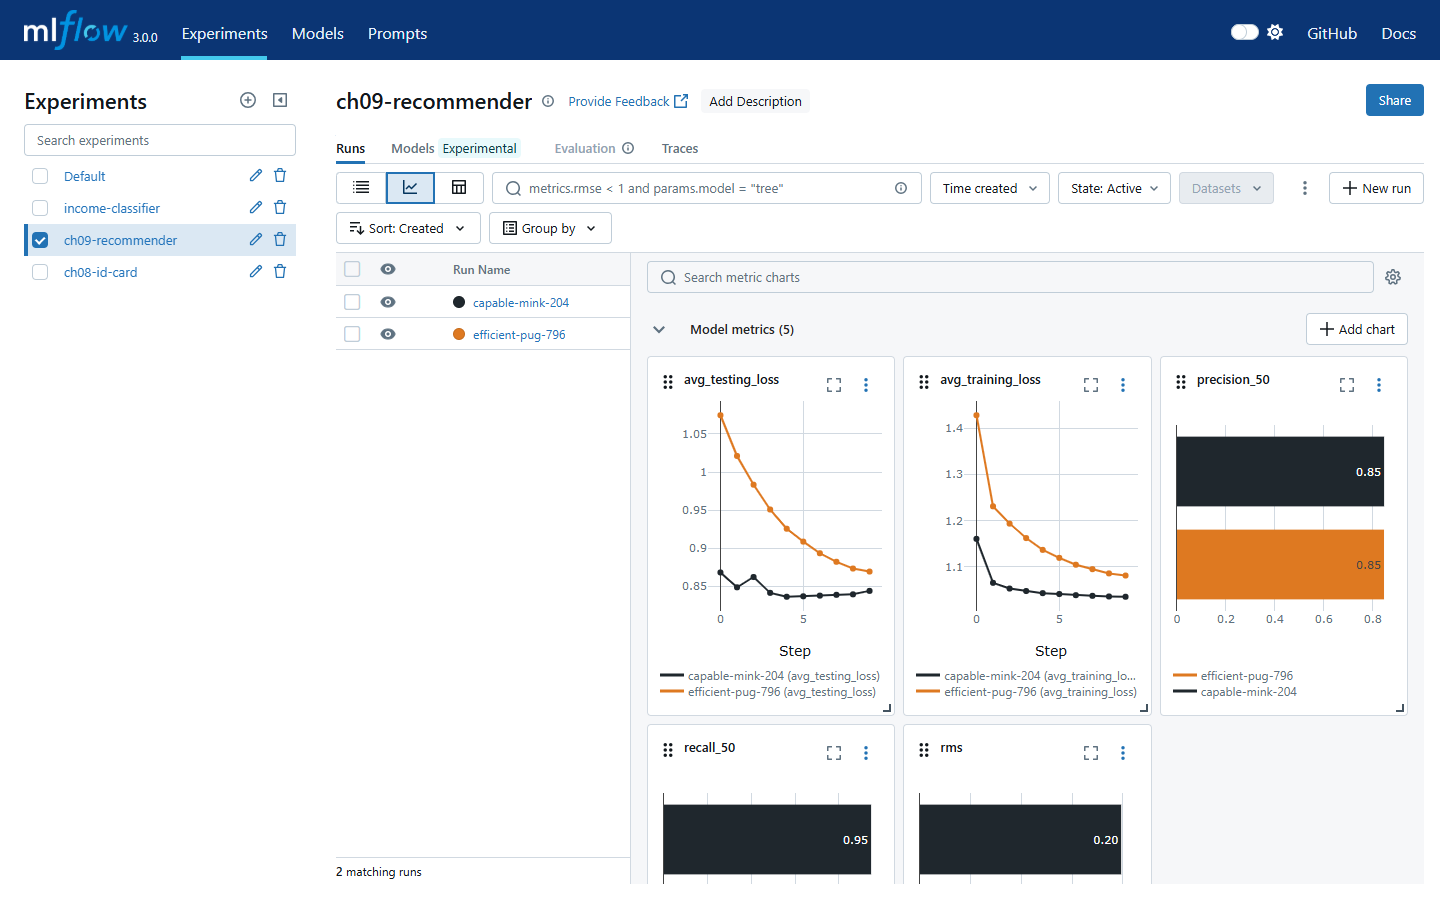
| 지표(val, 저자 계산 방식) | lr 0.001 efficient-pug-796 | lr 0.01 capable-mink-204 |
|---|---|---|
precision_50 | 0.8463 | 0.8466 |
recall_50 | 0.9381 | 0.9479 |
rms | 0.2040 | 0.1982 |
마지막 epoch avg_testing_loss(L1) | 0.8694 | 0.8440 |
| 학습 시간 | 8.6분 | 4.0분 |
학습 시간 차이는 첫 실행이 탐지 파이프라인과 동시에 돌면서 CPU를 나눠 쓴 탓이 크다. 지표만 보면 학습률 0.01이 모든 항목에서 조금씩 낫다. 이 숫자가 실제로 무엇을 말하는지는 F에서 다시 따진다.
E-2. 모델 파일과 레지스트리
모델 파일은 MLflow 서버가 아니라 S3에 있다. http://localhost:8888/buckets/mlflow-artifacts/ 에서 실험 ID 폴더(
2) 아래models/m-.../artifacts/data/를 열면model.pth가 보인다. 학습 Pod가 D-2의 환경 변수로 직접 올린 파일이다. 16MB 중 대부분은 193,610행짜리 영화 임베딩이다.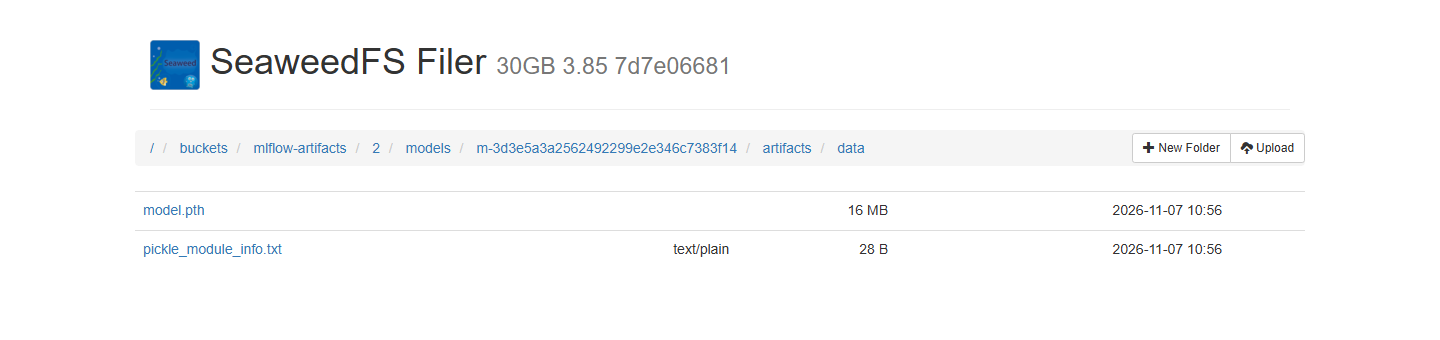
promote-model-to-staging로그에서 등록 판단을 본다. 첫 실행은 비교 대상이 없어 바로 등록했다.No staging model found. Auto upgrade current run to staging. Created version '1' of model 'ch09-recommender'. registered ch09-recommender v1 as staging두 번째 실행은 v1의 지표와 비교했다.
staging: {..., 'precision_50': 0.8462577914475892, 'recall_50': 0.9381313115782935, 'rms': 0.20403913887012845} new: {..., 'precision_50': 0.8465828273194906, 'recall_50': 0.9479055437857468, 'rms': 0.19817643799826062} Created version '2' of model 'ch09-recommender'. registered ch09-recommender v2 as stagingModels에서
ch09-recommender를 연다. 새 레지스트리 UI 안내 창이 뜨면 닫는다. Version 2에@ staging별칭이 붙어 있고 Version 1에는 별칭이 없다. 별칭만 옮겨 갔을 뿐 v1은 그대로 있으니, 되돌리려면 별칭을 다시 옮기면 된다.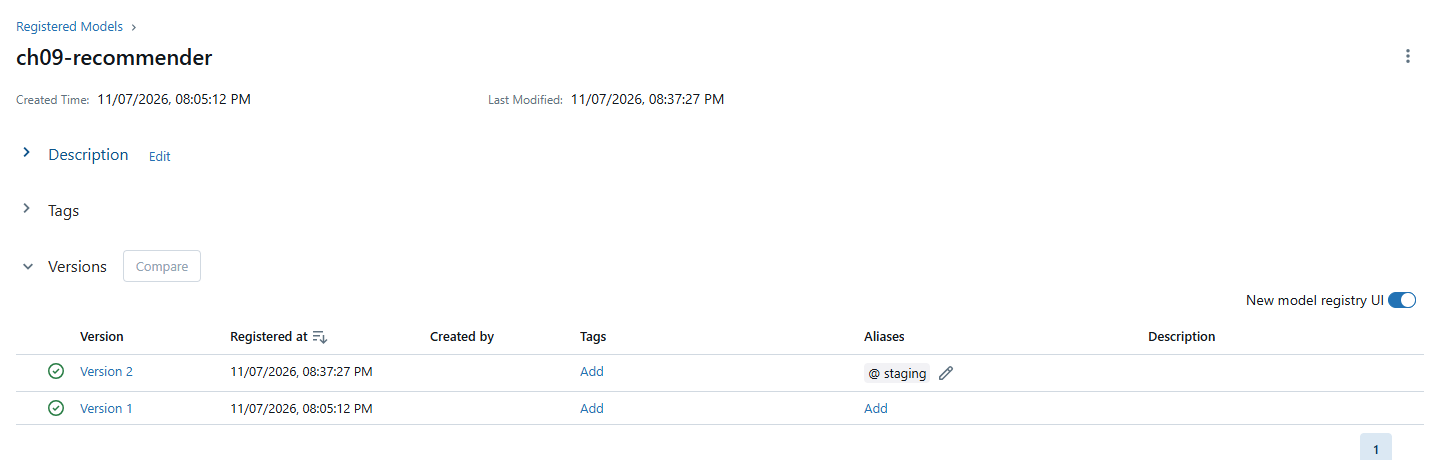
책 리스팅 9.17은 prod 별칭을 찾는다. 파이프라인은 staging까지만 옮기므로, 10장으로 가기 전에 검토한 버전에 사람이 prod를 붙여야 한다. 이번에는 F의 결과를 보고 prod를 붙이지 않았다.
완료 기준: 등록 모델 ch09-recommender에 버전 두 개가 있고 staging이 v2를 가리킨다.
F. 지표 다시 보기
등록된 모델을 PC로 내려받아, 파이프라인이 기록한 숫자를 서비스 관점의 지표와 기준선으로 다시 잰다.
F-1. 모델을 불러올 환경
모델을 불러오는 쪽은 학습 컴포넌트의 파이썬 버전을 따라야 한다. 컴파일한 YAML에서 train-model의 이미지는 python:3.9이고, MLflow는 모델 폴더의 python_env.yaml에 기록 당시의 파이썬 버전을 남긴다. PC의 파이썬은 3.12였다. A-2 환경에서 mlflow.pytorch.load_model을 부르면 다음 오류가 나고, 함께 뜨는 경고에서 학습 쪽 PyTorch가 2.8.0+cpu였음을 알 수 있다.
TypeError: code() argument 13 must be str, not int학습 Pod와 같은 Python 3.9, PyTorch 2.8.0 환경을 따로 만든다. Windows에서는 greenlet 최신판에 Python 3.9용 바이너리가 없어 소스 빌드가 실패하므로 버전을 고정했다.
uv venv .venv-ch09-py39 --python 3.9
uv pip install --python .venv-ch09-py39 torch==2.8.0 mlflow==3.0.0 greenlet==3.1.1 boto3 pandas pyarrow --extra-index-url https://download.pytorch.org/whl/cpu --index-strategy unsafe-best-match
F-2. 지표 다시 계산
ch09\evaluate_recommender.py는 세 가지를 계산한다. 첫째는 저자 방식(배치 평균)과 평점별 RMSE다. 둘째는 보지 않은 영화 전체를 순위화한 Recall@10과 NDCG@10으로, 인기순 기준선과 함께 낸다. 셋째는 무작위 분할이 가리는 정보다. 평점 4 이상인 val 영화를 “관련 있음"으로 봤다.
import os, sys
import numpy as np
import pandas as pd
import torch

os.environ.setdefault("MLFLOW_S3_ENDPOINT_URL", "http://127.0.0.1:9000")
os.environ.setdefault("AWS_ACCESS_KEY_ID", "minio")
os.environ.setdefault("AWS_SECRET_ACCESS_KEY", "minio123")
import mlflow

run_id = sys.argv[1]
data_dir = sys.argv[2] if len(sys.argv) > 2 else "ch09/data/ml-latest-small"
mlflow.set_tracking_uri("http://127.0.0.1:5000")
train = pd.read_parquet(f"{data_dir}/train.parquet.gzip")
val = pd.read_parquet(f"{data_dir}/val.parquet.gzip")
model = mlflow.pytorch.load_model(f"runs:/{run_id}/model", map_location="cpu")
model.eval()

def predict(users, items):
    with torch.no_grad():
        u = torch.tensor(np.asarray(users) - 1, dtype=torch.long)
        i = torch.tensor(np.asarray(items) - 1, dtype=torch.long)
        return model(u, i).squeeze(1).numpy()

# 1. RMSE: 저자 방식(배치 32개 평균)과 평점별, 평균 예측 기준선
pred, true = predict(val.userId.values, val.movieId.values), val.rating.values
order = np.random.default_rng(0).permutation(len(val))
bm = [(pred[order[s:s + 32]].mean(), true[order[s:s + 32]].mean()) for s in range(0, len(val), 32)]
bp, bt = map(np.array, zip(*bm))
print(f"rms (author, batch means of 32): {np.sqrt(np.mean((bp - bt) ** 2)):.4f}")
print(f"rmse per rating                : {np.sqrt(np.mean((pred - true) ** 2)):.4f}")
print(f"rmse of train mean {train.rating.mean():.2f} baseline : "
      f"{np.sqrt(np.mean((train.rating.mean() - true) ** 2)):.4f}")

# 2. 보지 않은 영화 전체에서 Recall@10, NDCG@10, 인기순 기준선
k = 10
items = np.array(sorted(set(train.movieId)))
popular = train.movieId.value_counts().index.values
seen = train.groupby("userId").movieId.apply(set)
relevant = val[val.rating >= 4].groupby("userId").movieId.apply(set)

def metrics(ranked, rel):
    hits = [1.0 if m in rel else 0.0 for m in ranked[:k]]
    dcg = sum(h / np.log2(i + 2) for i, h in enumerate(hits))
    idcg = sum(1 / np.log2(i + 2) for i in range(min(len(rel), k)))
    return sum(hits) / len(rel), dcg / idcg

rows = {"model": [], "popularity": []}
for user, rel in relevant.items():
    unseen = items[~np.isin(items, list(seen.get(user, set())))]
    scores = predict(np.full(len(unseen), user), unseen)
    rows["model"].append(metrics(unseen[np.argsort(-scores)], rel))
    rows["popularity"].append(metrics([m for m in popular if m not in seen.get(user, set())], rel))
for name, values in rows.items():
    recall, ndcg = np.mean(values, axis=0)
    print(f"{name:<10} Recall@{k}={recall:.4f} NDCG@{k}={ndcg:.4f} (users={len(values)})")

# 3. 무작위 분할이 가리는 것
last_train = train.groupby("userId").timestamp.max()
earlier = (val.timestamp.values < val.userId.map(last_train).values).mean()
print(f"val ratings older than the same user's latest train rating: {earlier:.1%}")
print(f"val items never seen in train: {(~val.movieId.isin(train.movieId)).sum()} rows, "
      f"val users never seen in train: {(~val.userId.isin(train.userId)).sum()} rows")
run ID는 MLflow 화면이나 D-4의 validate-model 로그에서 확인한다.
.\.venv-ch09-py39\Scripts\python.exe ch09\evaluate_recommender.py 615d3f32e28c4127ab3fd515fba5b5b9
.\.venv-ch09-py39\Scripts\python.exe ch09\evaluate_recommender.py c1252d6c9f944228a7a93c26585708c4
학습률 0.001 run의 출력이다.
rms (author, batch means of 32): 0.2148
rmse per rating                : 1.0811
rmse of train mean 3.50 baseline : 1.0467
model      Recall@10=0.0002 NDCG@10=0.0006 (users=582)
popularity Recall@10=0.0990 NDCG@10=0.1224 (users=582)
val ratings older than the same user's latest train rating: 98.8%
val items never seen in train: 635 rows, val users never seen in train: 0 rows
두 run을 나란히 놓으면 다음과 같다.
| 지표 | lr 0.001 | lr 0.01 | 인기순 또는 평균 기준선 |
|---|---|---|---|
저자 방식 rms(배치 평균, 다시 계산) | 0.2148 | 0.1936 | |
| 평점별 RMSE | 1.0811 | 1.0466 | 1.0467(평균 3.50 예측) |
| Recall@10(보지 않은 영화 전체) | 0.0002 | 0.0016 | 0.0990 |
| NDCG@10 | 0.0006 | 0.0018 | 0.1224 |
저자 방식의 rms는 배치를 섞는 순서에 따라 파이프라인 기록(0.2040, 0.1982)과 조금 다르지만 크기는 같다. 평점별로 재면 학습률 0.01 모델은 평균 평점을 그대로 예측하는 것과 같은 수준이고, 0.001 모델은 그보다 못하다. 추천 목록으로 보면 두 모델 모두 인기순보다 수십 배 낮다.
그런데도 E-2의 등록 판단은 두 번 다 “등록"이었다. 자동화 자체는 제대로 동작했다. 문제는 그 자동화가 믿은 숫자가 질문에 맞지 않았다는 데 있다.
F-3. 사용자 한 명의 추천 보기
책의 리스팅 9.17과 그림 9.12, 9.13처럼 별칭으로 모델을 찾아 한 사용자에게 추천해 본다. ch09\recommend_user.py는 리스팅 9.17을 줄인 것이다. 학습에서 본 영화를 빼고 점수 상위 10편을 뽑고, 그 사용자가 높게 평가한 영화도 함께 출력한다.
import os, sys
import pandas as pd
import torch

os.environ.setdefault("MLFLOW_S3_ENDPOINT_URL", "http://127.0.0.1:9000")
os.environ.setdefault("AWS_ACCESS_KEY_ID", "minio")
os.environ.setdefault("AWS_SECRET_ACCESS_KEY", "minio123")
import mlflow
from mlflow import MlflowClient

name, alias, user = sys.argv[1], sys.argv[2], int(sys.argv[3])
data_dir = sys.argv[4] if len(sys.argv) > 4 else "ch09/data/ml-latest-small"
mlflow.set_tracking_uri("http://127.0.0.1:5000")
version = MlflowClient().get_model_version_by_alias(name, alias)
print(f"{name}@{alias} -> version {version.version}, run {version.run_id}")
model = mlflow.pytorch.load_model(f"runs:/{version.run_id}/model", map_location="cpu")
model.eval()

movies = pd.read_parquet(f"{data_dir}/movies.parquet.gzip")
train = pd.read_parquet(f"{data_dir}/train.parquet.gzip")
candidates = movies[~movies.movieId.isin(train[train.userId == user].movieId)].copy()
with torch.no_grad():
    scores = model(torch.full((len(candidates),), user - 1, dtype=torch.long),
                   torch.tensor(candidates.movieId.values - 1, dtype=torch.long)).squeeze(1)
candidates["score"] = scores.numpy()
print(candidates.nlargest(10, "score")[["movieId", "title", "score"]].to_string(index=False))
history = train[train.userId == user].merge(movies, on="movieId").nlargest(5, "rating")
print(f"\nuser {user} top-rated in train:")
print(history[["title", "rating"]].to_string(index=False)).\.venv-ch09-py39\Scripts\python.exe ch09\recommend_user.py ch09-recommender staging 50v1이 staging이던 시점에 실행한 결과다.
ch09-recommender@staging -> version 1, run 615d3f32e28c4127ab3fd515fba5b5b9
 movieId                                                              title    score
  115727 Crippled Avengers (Can que) (Return of the 5 Deadly Venoms) (1981) 4.763456
  103228                                                 Pacific Rim (2013) 4.592159
  122902                                              Fantastic Four (2015) 4.552133
   59604                                         Girl Next Door, The (2007) 4.550359
   63433                              Farscape: The Peacekeeper Wars (2004) 4.501512
    5889                         Cruel Romance, A (Zhestokij Romans) (1984) 4.486191
  139130                                                Afro Samurai (2007) 4.466871
    2717                                             Ghostbusters II (1989) 4.460788
    4865                                                   From Hell (2001) 4.442851
   65740                      Revenge of the Nerds IV: Nerds in Love (1994) 4.435467

user 50 top-rated in train:
                       title  rating
2001: A Space Odyssey (1968)     4.5
       Apocalypse Now (1979)     4.5
           8 1/2 (8½) (1963)     4.5
   Lawrence of Arabia (1962)     4.5
         Blade Runner (1982)     4.0
고전 영화를 높게 평가한 사용자에게 평점이 거의 없는 영화들이 올라왔다. 학습 데이터에 거의 나오지 않은 영화의 임베딩이 초기값 근처에 머물다 우연히 높은 점수를 받은 결과다. 콜드 스타트에서 말한 현상이 그대로 보인다. 책의 그림 9.12처럼 그럴듯한 결과가 나올지는 데이터 규모와 학습 길이에 크게 달려 있다. 사람이 결과를 직접 보는 확인이 지표만큼 중요하다는 책의 요약이 여기서 실감 났다.
완료 기준: 두 run의 평점별 RMSE, Recall@10, NDCG@10을 기준선과 함께 설명할 수 있다.
G. 문제 해결과 정리
G-1. 자주 만나는 실패
| 증상 | 위치 | 원인과 조치 |
|---|---|---|
PVC가 계속 Pending | createpvc 뒤 | StorageClass 이름이 local-path. kind는 standard. 실행을 취소해도 WaitForFirstConsumer 때문에 Pending으로 남는다 |
missing path '/data/val/images' | train-model | 다운로드와 분할이 캐시로 건너뛰었다. 해당 단계의 set_caching_options(False) |
cannot import name 'YOLO' from 'ultralytics' | train-model | 학습 스크립트를 /train.py에 써서 이미지의 /ultralytics 폴더가 패키지를 가렸다. /tmp/train.py로 |
| TensorBoard에 실행이 없음 | TensorBoard | 학습 project가 PVC 밖이거나 Ultralytics tensorboard 설정이 꺼져 있다 |
PVC가 Terminating에서 멈춤 | 실행 뒤 | PVC를 참조하는 Pod가 남아 있다. kubectl describe pvc의 Used By 확인 |
AssertionError | qa-training-data | qa_min_rows나 데이터셋 이름이 실제 데이터와 맞지 않는다 |
모델 업로드에서 S3 연결 오류 또는 NoCredentialsError | train-model | MLflow가 아티팩트를 프록시하지 않는 구성에서 S3 환경 변수가 없다 |
'NoneType' object has no attribute 'run_id' | promote-model-to-staging | 첫 실행에서 staging이 없는 경우. D-2의 조건 수정 |
Registered model alias prod not found | 리스팅 9.17 | 파이프라인은 staging만 만든다 |
TypeError: code() argument 13 must be str, not int | 로컬 load_model | 학습 Pod와 파이썬 버전이 다르다. F-1의 Python 3.9 환경 |
이번에 실제로 만난 것은 캐시로 인한 missing path, YOLO import 오류, Terminating에 멈춘 PVC, 취소한 실행이 남긴 Pending PVC, prod 별칭 없음, 파이썬 버전 TypeError다. StorageClass 이름, TensorBoard 빈 화면, QA 조건, S3 환경 변수, 첫 등록의 NoneType 오류는 미리 고쳐서 직접 겪지 않았다. 이 다섯은 코드와 서버 구성을 읽고 판단한 것이다.
G-2. 정리
- TensorBoard 포트 연결 터미널을
Ctrl+C로 닫고 Deployment를 지운다.kubectl delete -f ch09\tensorboard.yaml - 남은 PVC를 확인한다. 실패한 실행의 PVC가 있으면, 그 실행의 끝난 Pod를 지워 참조를 끊은 뒤 PVC를 지운다. 실행 이름의 앞부분(예
ch09-yolo-pvc-pipeline-tqd5v)은 PVC의Used By에서 확인한다.kubectl -n kubeflow get pvc kubectl -n kubeflow get pods -o name | Select-String "ch09-yolo-pvc-pipeline-tqd5v" | ForEach-Object { kubectl -n kubeflow delete $_.ToString() --wait=false } kubectl -n kubeflow delete pvc <남은 PVC 이름> - MLflow 실험과 등록 모델,
ch09-datasets버킷은 10장에서 별칭으로 모델을 찾을 때 쓰므로 남겨 둔다. 지우려면 MLflow 화면에서 등록 모델과 실험을 삭제하고 저장소 화면에서ch09-datasets폴더를 지운다. - kind 노드에 넣은
ultralytics/ultralytics:8.3.56-cpu는 디스크를 많이 쓴다. 클러스터를 지울 때(python bookenv.py down) 함께 사라진다.