08. 모델 학습과 검증 I: 실습 기록
08. 모델 학습과 검증 I에서 정리한 내용을 책의 코드로 직접 실행한 기록이다. 개념과 요점은 본문에 두고, 여기에는 명령, 실제 출력과 화면만 모았다.
실습 순서
책 8장의 파이프라인을 book-env 클러스터에서 끝까지 돌리고, 결과를 수동 검토와 등록 결정까지 이어 본다. GPU가 없고 원래 데이터셋도 받을 수 없어서 두 가지를 바꿨다. 데이터는 개인 정보가 없는 합성 신분증 이미지 192장이고, 학습은 CPU에서 320px, 5 epoch, batch 8이다. 그러니 아래 수치는 책의 모델 성능과 견줄 값이 아니다. 절차가 끝까지 이어졌다는 기록으로 읽으면 된다.
    flowchart LR
    accTitle: 책 8장을 따라가는 실습 순서
    accDescr: 환경과 저자 코드를 준비하고 합성 데이터를 S3에 올린다. 저자 파이프라인을 고쳐 컴파일하고 KFP에 올려 실행한다. 학습과 검증 결과를 확인한 뒤 가중치를 내려받아 수동 검토하고, 보충으로 MLflow에 기록하고 등록 결정을 남긴 뒤 정리한다.
    A["A. 환경과 코드 준비"] --> B["B. 합성 데이터<br/>S3 업로드"]
    B --> C["C. 저자 코드 수정<br/>컴파일과 업로드"]
    C --> D["D. KFP 실행<br/>분할과 학습"]
    D --> E["E. 검증 지표와<br/>산출물 확인"]
    E --> F["F. 수동 검토"]
    F --> G["G. 보충: MLflow<br/>기록과 등록 결정"]
    G --> H["H. 오류 대응과 정리"]
| 구간 | 끝났을 때 남는 것 |
|---|---|
| A. 환경과 코드 준비 | 동작하는 book-env, 저자 코드 c6afb11, ch08\.venv |
| B. 합성 데이터 | ch08-datasets/DATASET.tar.gz |
| C. 코드 수정과 업로드 | ch08_pipeline.yaml, KFP 파이프라인 ch08-yolo-train-validate |
| D. KFP 실행 | 실험 ch08-id-card, 실행 ch08-yolo-e5-img320, 분할과 학습 로그 |
| E. 결과 확인 | metrics 아티팩트의 mAP, model_output/train_run의 학습 그림 |
| F. 수동 검토 | 사전학습 모델과 학습 모델의 비교, 실패 조건 목록 |
| G. 보충 | MLflow run과 ch08-id-card-detector 버전 1의 보류 결정 |
| H. 정리 | 지울 리소스 목록과 오류 대응표 |
명령은 PowerShell 기준이다. 따로 적지 않으면 ml-platform-book-env 저장소 아래의 ch08 폴더에서 실행한다. kubectl과 kind가 PATH에 있어야 한다.
A. 환경과 코드 준비
전체 그림의 ①에 들어가기 전에, ②에서 쓸 컴파일 환경부터 갖춘다.
A-1. 클러스터와 포트포워딩 확인
- 4~5장 글의 환경 세팅대로
book-env클러스터를 만들고, 두 번째 터미널에서python bookenv.py forward를 켜 둔다. ml-platform-book-env폴더에서 상태를 확인한다.python bookenv.py status- 브라우저에서 KFP(http://localhost:8080), MLflow(http://localhost:5000), 저장소(http://localhost:8888/buckets/)가 열리면 된다.
8장은 4장의 버킷이나 Feast 상태가 필요 없다. MLflow 서버는 G 구간의 보충 실습에서만 쓴다.
A-2. 저자 코드 받기
- 작업 폴더를 만들고 저자 코드를 받는다.
mkdir ch08; cd ch08
git clone https://github.com/practical-mlops/object-detection-project.git
git -C object-detection-project log -1 --format="%h %ad %s" --date=short
c6afb11 2025-01-02 Add pipeline with PVC가 나오면 이 글과 같은 코드다.
책 8장의 파이프라인은 저장소 최상위의 training_and_validation_pipeline.py다. practical-mlops 조직에 chapter-8 저장소는 없다.
A-3. 가상환경
- 컴파일, 업로드, 수동 검토, MLflow 기록에 쓸 가상환경을 만든다.
uv venv .venv --python 3.11 uv pip install --python .venv kfp==2.9.0 boto3 mlflow==3.0.0 ultralytics==8.3.40 ` torch==2.5.1 torchvision==0.20.1 numpy==1.26.4 "opencv-python<4.12" ` --extra-index-url https://download.pytorch.org/whl/cpu --index-strategy unsafe-best-match - 버전을 확인한다.
.\.venv\Scripts\python.exe -c "import kfp, ultralytics, torch, mlflow, numpy; print(kfp.__version__, ultralytics.__version__, torch.__version__, mlflow.__version__, numpy.__version__)"2.9.0 8.3.40 2.5.1+cpu 3.0.0 1.26.4 - Ultralytics 설정이 다른 프로젝트와 섞이지 않게 이 폴더 전용 설정 위치를 쓰고, 내장 MLflow 콜백을 끈다.
$env:YOLO_CONFIG_DIR = "$PWD\yolo-config"
.\.venv\Scripts\yolo.exe settings mlflow=False
NumPy를 고정하지 않으면 2.4 이상이 깔린다. 그러면 Ultralytics 8.3.40이 학습 마지막 검증에서 AttributeError: module 'numpy' has no attribute 'trapz'로 멈춘다. 고정하기 전 로컬 학습에서 실제로 이 오류가 났다. MLflow 콜백은 가상환경에 mlflow가 있으면 저절로 켜지고, Windows 경로를 추적 URI로 잘못 읽을 수 있어서 끈다. YOLO_CONFIG_DIR은 새 터미널마다 다시 지정한다.
B. 합성 데이터 준비와 업로드
7장에서 준비했어야 할 데이터셋을 S3에 올린다. 전체 그림의 ①이다.
B-1. 원래 데이터 주소 확인
저자 코드의 download_dataset은 Manning이 공유한 압축 파일을 받는다.
curl.exe -sI "https://manning.box.com/shared/static/coiv3n2t5t0v42xgfhlsfi8bhvd7b441.gz" | Select-String "HTTP/"HTTP/1.1 404 Not Found2026-11-07에 확인했을 때 404였다. 같은 파일을 공개적으로 받을 곳이 없어서, 저자 코드가 기대하는 폴더 구조를 그대로 갖춘 합성 데이터를 만들었다.
B-2. 합성 신분증 데이터 만들기
- 아래 내용을
make_synthetic_idcards.py로 저장한다. 실제 인물이나 문서 정보는 쓰지 않는다. 도형 배경 위에SYNTHETIC ID라고 적은 가짜 카드를 붙이고, MIDV-500처럼 한 clip이 같은 카드와 배경의 인접 프레임 여섯 장이 되게 했다."""Synthetic ID-card-like detection dataset in YOLO format. No real person or document data.""" import argparse import os import random import tarfile from PIL import Image, ImageDraw, ImageFilter, ImageFont W, H = 480, 360 def background(rng): img = Image.new("RGB", (W, H), tuple(rng.randint(40, 220) for _ in range(3))) d = ImageDraw.Draw(img) for _ in range(rng.randint(8, 25)): x0, y0 = rng.randint(-50, W), rng.randint(-50, H) x1, y1 = x0 + rng.randint(20, 220), y0 + rng.randint(20, 160) color = tuple(rng.randint(0, 255) for _ in range(3)) if rng.random() < 0.5: d.rectangle([x0, y0, x1, y1], fill=color) else: d.ellipse([x0, y0, x1, y1], fill=color) return img.filter(ImageFilter.GaussianBlur(rng.uniform(0.5, 2.5))) def card(rng, cw): ch = int(cw / 1.586) base = tuple(rng.randint(170, 250) for _ in range(3)) c = Image.new("RGBA", (cw, ch), (0, 0, 0, 0)) d = ImageDraw.Draw(c) d.rounded_rectangle([0, 0, cw - 1, ch - 1], radius=max(4, cw // 20), fill=base + (255,)) header = tuple(rng.randint(20, 140) for _ in range(3)) d.rectangle([0, int(ch * 0.05), cw, int(ch * 0.22)], fill=header + (255,)) font = ImageFont.load_default() d.text((int(cw * 0.05), int(ch * 0.08)), "SYNTHETIC ID", fill=(255, 255, 255, 255), font=font) # photo placeholder (abstract silhouette, not a face image) px0, py0 = int(cw * 0.06), int(ch * 0.30) px1, py1 = int(cw * 0.32), int(ch * 0.90) d.rectangle([px0, py0, px1, py1], fill=(150, 160, 175, 255)) cx = (px0 + px1) // 2 r = (px1 - px0) // 4 d.ellipse([cx - r, py0 + r // 2, cx + r, py0 + r // 2 + 2 * r], fill=(90, 95, 110, 255)) d.rectangle([px0 + r // 2, py1 - (py1 - py0) // 3, px1 - r // 2, py1], fill=(90, 95, 110, 255)) for i in range(5): y = int(ch * (0.34 + i * 0.11)) x1 = int(cw * rng.uniform(0.6, 0.95)) d.rectangle([int(cw * 0.38), y, x1, y + max(2, ch // 30)], fill=(60, 60, 60, 255)) return c def place(bg, cimg, cx, cy, angle): rot = cimg.rotate(angle, expand=True, resample=Image.BICUBIC) x0, y0 = int(cx - rot.width / 2), int(cy - rot.height / 2) bg.paste(rot, (x0, y0), rot) bbox = rot.getchannel("A").getbbox() # axis-aligned box of the visible card pixels bx0, by0, bx1, by1 = bbox[0] + x0, bbox[1] + y0, bbox[2] + x0, bbox[3] + y0 return max(0, bx0), max(0, by0), min(W, bx1), min(H, by1) def main(): ap = argparse.ArgumentParser() ap.add_argument("--out", default="synthetic") ap.add_argument("--clips", type=int, default=30) ap.add_argument("--frames", type=int, default=6) ap.add_argument("--negatives", type=int, default=12) ap.add_argument("--seed", type=int, default=8) ap.add_argument("--tar", default="DATASET.tar.gz") a = ap.parse_args() rng = random.Random(a.seed) img_dir = os.path.join(a.out, "MINIDATA", "images") lbl_dir = os.path.join(a.out, "MINIDATA", "labels") os.makedirs(img_dir, exist_ok=True) os.makedirs(lbl_dir, exist_ok=True) n = 0 for clip in range(a.clips): bg0 = background(rng) cimg = card(rng, rng.randint(140, 300)) cx, cy = rng.uniform(0.3, 0.7) * W, rng.uniform(0.3, 0.7) * H ang = rng.uniform(-25, 25) for f in range(a.frames): bg = bg0.copy() box = place(bg, cimg, cx + rng.uniform(-12, 12), cy + rng.uniform(-10, 10), ang + rng.uniform(-4, 4)) if rng.random() < 0.3: bg = bg.filter(ImageFilter.GaussianBlur(rng.uniform(0.5, 1.5))) stem = f"clip{clip:02d}_f{f:02d}" bg.save(os.path.join(img_dir, stem + ".jpg"), quality=88) bx0, by0, bx1, by1 = box with open(os.path.join(lbl_dir, stem + ".txt"), "w") as fh: fh.write(f"0 {(bx0 + bx1) / 2 / W:.6f} {(by0 + by1) / 2 / H:.6f} {(bx1 - bx0) / W:.6f} {(by1 - by0) / H:.6f}\n") n += 1 for i in range(a.negatives): stem = f"neg{i:02d}" background(rng).save(os.path.join(img_dir, stem + ".jpg"), quality=88) open(os.path.join(lbl_dir, stem + ".txt"), "w").close() n += 1 with tarfile.open(a.tar, "w:gz") as tar: tar.add(os.path.join(a.out, "MINIDATA"), arcname="MINIDATA") print(f"images={n} clips={a.clips} frames_per_clip={a.frames} negatives={a.negatives} tar={a.tar} size={os.path.getsize(a.tar)}") if __name__ == "__main__": main() - 실행한다.
.\.venv\Scripts\python.exe make_synthetic_idcards.py압축 파일 크기는 파일 시각 정보 때문에 실행마다 수십 바이트씩 달라질 수 있다. seed가 같으면 이미지와 라벨 내용은 같다.images=192 clips=30 frames_per_clip=6 negatives=12 tar=DATASET.tar.gz size=2716385 synthetic\MINIDATA\images\clip03_f00.jpg를 열어 카드가 보이는지 본다. 같은 이름의labels\clip03_f00.txt에는0 중심x 중심y 너비 높이한 줄이 있어야 한다. 카드가 없는neg00~neg11은 빈 라벨 파일이다.
압축 파일 안의 경로는 MINIDATA/images, MINIDATA/labels다. 저자의 split_dataset이 DATASET/MINIDATA/...를 읽으므로 이 구조는 건드리지 않는다.
B-3. S3에 업로드
아래 내용을
upload_dataset.py로 저장하고 실행한다. PC에서는 포트포워딩된127.0.0.1:9000으로 접근한다.import boto3 s3 = boto3.client("s3", endpoint_url="http://127.0.0.1:9000", aws_access_key_id="minio", aws_secret_access_key="minio123") names = [b["Name"] for b in s3.list_buckets()["Buckets"]] print("before:", names) if "ch08-datasets" not in names: s3.create_bucket(Bucket="ch08-datasets") s3.upload_file("DATASET.tar.gz", "ch08-datasets", "DATASET.tar.gz") print([(o["Key"], o["Size"]) for o in s3.list_objects_v2(Bucket="ch08-datasets")["Contents"]]).\.venv\Scripts\python.exe upload_dataset.py[('DATASET.tar.gz', 2716385)]http://localhost:8888/buckets/ch08-datasets/ 에서 파일을 확인한다.
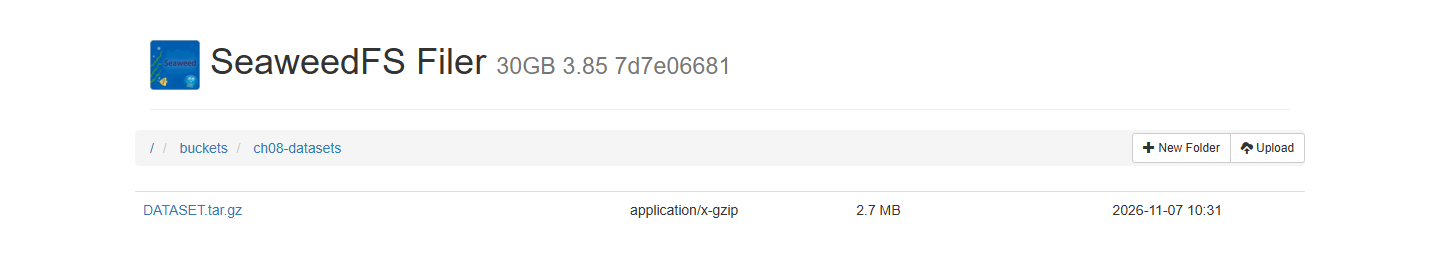
이 위치가 전체 그림 ①의 데이터셋 URI다. 실제 프로젝트라면 같은 이름으로 덮어쓰지 말고 날짜나 해시를 넣은 경로로 버전을 남겨야 한다. 그래야 학습 기록과 데이터를 다시 이을 수 있다.
C. 저자 코드 수정, 컴파일과 업로드
②에 해당하는 파이프라인 정의를 지금 환경에서 돌아가게 고치고 KFP에 올린다.
C-1. 고칠 곳
저자 파일을 복사해서 고친다. 원본은 비교용으로 남겨 둔다.
Copy-Item object-detection-project\training_and_validation_pipeline.py ch08_pipeline.py| 고친 곳 | 이유 | 확인한 증상 |
|---|---|---|
download_dataset | 다운로드 주소 404 | B-1의 HTTP/1.1 404 |
split_dataset 짝짓기 | 두 glob 목록을 위치로 짝지음 | D-4의 191/192 pairs have different stems |
split_dataset 끝의 출력 | 인접 프레임 누수를 숫자로 확인 | D-4의 val clips also in train: 18/18 |
apt-get 패키지 | trixie에 libgl1-mesa-glx 없음 | 아래 확인 명령 |
pip install 버전 | CUDA 휠과 NumPy 2.4 비호환 | A-3의 np.trapz 오류 |
imgsz, workers | CPU에서 끝나는 크기, 작은 /dev/shm 대비 | 학습 시간 |
| 학습 폴더 복사 | 학습 그림이 아티팩트 밖에 남음 | E-3에서 train_run 확인 |
| 파이프라인 이름과 자원 | 공유 클러스터에서 구분하고 사용량 제한 | ch08- 접두사 |
libgl1-mesa-glx가 사라진 것은 Docker로 바로 확인된다.
docker run --rm python:3.11-slim bash -c "apt-get update -qq >/dev/null && apt-get install -y --no-install-recommends libgl1-mesa-glx 2>&1 | tail -1"E: Package 'libgl1-mesa-glx' has no installation candidatedownload_dataset에서 함수 정의부터 압축 해제 직전까지를 S3에서 읽도록 바꾼다. 데코레이터와 압축 해제 부분은 그대로 둔다.Pod 안에서는def download_dataset(output_dataset: Output[Dataset], output_dir: str = "DATASET", s3_endpoint: str = "http://minio-service.kubeflow.svc.cluster.local:9000", bucket: str = "ch08-datasets", key: str = "DATASET.tar.gz"): # [ch08 fix] The author's Manning box URL now returns 404. # Read the same tar.gz layout (MINIDATA/images, MINIDATA/labels) from S3 instead. import os import tarfile import boto3 downloaded_file = "DATASET.gz" s3 = boto3.client("s3", endpoint_url=s3_endpoint, aws_access_key_id="minio", aws_secret_access_key="minio123") s3.download_file(bucket, key, downloaded_file) print(f"downloaded s3://{bucket}/{key} ({os.path.getsize(downloaded_file)} bytes)")localhost대신 클러스터 서비스 주소를 쓴다. 키를 코드에 적은 것은 로컬 실습이라서이고, 운영에서는 Secret으로 넘긴다.split_dataset의images,labels두 줄을 이름 기준 짝짓기로 바꾼다.raw_images = list(glob.glob(os.path.join(input_dataset.path, "DATASET", BASE_PATH, "images", "**"))) raw_labels = list(glob.glob(os.path.join(input_dataset.path, "DATASET", BASE_PATH, "labels", "**"))) # [ch08 fix] The author zips two independently globbed lists. glob order is not # guaranteed, so image i and label i may belong to different samples. stem = lambda p: os.path.splitext(os.path.basename(p))[0] mismatched = sum(stem(a) != stem(b) for a, b in zip(raw_images, raw_labels)) print(f"author-style zip(glob, glob): {mismatched}/{len(raw_images)} pairs have different stems") label_by_stem = {stem(p): p for p in raw_labels} images = sorted(p for p in raw_images if stem(p) in label_by_stem) labels = [label_by_stem[stem(p)] for p in images] print(f"paired by stem: {len(images)} samples, images without label: {len(raw_images) - len(images)}")- 같은 함수의 마지막 복사 반복문 뒤에 누수 확인 출력을 붙인다. 분할 규칙은 책 그대로 두고 결과만 드러낸다.
# [ch08 check] adjacent-frame leakage: frames of one clip landing in several splits clip = lambda p: os.path.basename(p).split("_")[0] train_clips = {clip(p) for p in x_train} val_clips = {clip(p) for p in x_val} test_clips = {clip(p) for p in x_test} print(f"split sizes train={len(x_train)} val={len(x_val)} test={len(x_test)}") print(f"val clips also in train: {len(val_clips & train_clips)}/{len(val_clips)}") print(f"test clips also in train: {len(test_clips & train_clips)}/{len(test_clips)}") TRAINING_SCRIPT안을 세 군데 고친다.parse_args()에--imgsz를 추가하고,model.train()의imgsz=640을imgsz=args.imgsz로 바꾸고workers=0을 넣는다.shutil.copy2(best_model_source, best_model_dest)다음에는 학습 폴더 복사를 붙인다.parser.add_argument('--imgsz', type=int, default=640, help='[ch08] image size (CPU lab uses 320)')# [ch08 fix] project=dirname(model_output) is outside the artifact folder, so plots, # results.csv and last.pt were never uploaded. Keep the run folder inside the Model artifact. shutil.copytree(os.path.join(os.path.dirname(args.model_output), args.model_name), os.path.join(args.model_output, "train_run"), dirs_exist_ok=True) print("model artifact contents:", sorted(os.listdir(args.model_output)))workers=0은 예방 조치다. Pod의 공유 메모리가 작아서 DataLoader 작업 프로세스가 죽는 일을 피하려는 것이고, 기본값으로 실제 실패하는지는 확인하지 않았다.train_model의 시그니처에imgsz: int = 640을 추가하고,ContainerSpec의 설치 줄을 바꾼다.apt-get install -y --no-install-recommends \ libgl1 \ libglib2.0-0 \ && rm -rf /var/lib/apt/lists/* && \ pip install --no-cache-dir \ --extra-index-url https://download.pytorch.org/whl/cpu \ ultralytics==8.3.40 \ torch==2.5.1+cpu \ torchvision==0.20.1+cpu \ numpy==1.26.4 \ opencv-python-headless==4.8.1.78 \ minio \ tqdm \ pyyaml && \python3 /train.py줄의 끝은--data-yaml "$7" \와--imgsz "$8"로 바꾸고,args리스트의data_yaml.path뒤에imgsz를 넣는다. 번호와 리스트 순서가 어긋나면 엉뚱한 값이 엉뚱한 옵션에 들어간다.validate_model의 시그니처에imgsz: int = 640을 추가하고model.val()의imgsz=640을imgsz=imgsz로 바꾼다.- 파이프라인 정의를 고친다.맨 아래
@dsl.pipeline( name="ch08-yolo-train-validate", description="Chapter 8 YOLO train/validate on a synthetic ID-card dataset (CPU)" ) def pipeline( epochs: int = 1, batch: int = 8, random_state: int = 42, yolo_model_name: str = "yolov8n_custom", imgsz: int = 320, dataset_bucket: str = "ch08-datasets" ): download_op = download_dataset(bucket=dataset_bucket) # split_op은 저자 코드와 같다 train_op = train_model( epochs=epochs, batch=batch, yolo_model_name=yolo_model_name, train_dataset=split_op.outputs["train_dataset"], validation_dataset=split_op.outputs["validation_dataset"], test_dataset=split_op.outputs["test_dataset"], imgsz=imgsz ) train_op.set_cpu_limit("4").set_memory_limit("6G") validate_op = validate_model( data_yaml=train_op.outputs["data_yaml"], model=train_op.outputs["model_output"], validation_dataset=split_op.outputs["validation_dataset"], imgsz=imgsz ) validate_op.set_cpu_limit("2").set_memory_limit("4G")package_path는'ch08_pipeline.yaml'로 바꾼다.
C-2. 컴파일
.\.venv\Scripts\python.exe ch08_pipeline.py
Select-String ch08_pipeline.yaml -Pattern "image:"
ch08_pipeline.yaml:172: image: python:3.11
ch08_pipeline.yaml:244: image: python:3.11
ch08_pipeline.yaml:312: image: python:3.11-slim
ch08_pipeline.yaml:357: image: ultralytics/ultralytics:8.0.194-cpu컴파일은 실행 명세만 만든다. 이미지를 받을 수 있는지, 패키지 설치가 성공하는지는 실행해 봐야 안다.
C-3. 이미지를 kind 노드에 미리 넣기
ultralytics/ultralytics:8.0.194-cpu는 압축 상태로 약 1.6GB다. 검증 작업이 이 이미지를 받느라 한참 멈춰 있지 않게 미리 받아 kind 노드에 넣어 둔다.
docker pull ultralytics/ultralytics:8.0.194-cpu
docker pull python:3.11-slim
docker pull python:3.11
kind load docker-image ultralytics/ultralytics:8.0.194-cpu python:3.11 --name book-env
docker save --platform linux/amd64 python:3.11-slim -o slim.tar
kind load image-archive slim.tar --name book-env
Remove-Item slim.tar
docker exec book-env-control-plane crictl images | Select-String "python|ultralytics"
Docker Desktop의 containerd 이미지 저장소를 쓰는 환경에서는 kind load docker-image가 content digest ... not found로 실패하는 이미지가 있었다. 그럴 때는 위의 python:3.11-slim처럼 docker save --platform linux/amd64로 한 플랫폼만 저장해 kind load image-archive로 넣는다. 마지막 명령에서 세 이미지가 보이면 된다. 이 단계를 건너뛰어도 Pod가 인터넷에서 직접 받지만 더 오래 걸린다.
C-4. 파이프라인 업로드
http://localhost:8080 에서 Pipelines → + Upload pipeline을 누른다.
Pipeline Name에
ch08-yolo-train-validate, 설명에Chapter 8 YOLO train and validate (CPU, synthetic ID cards)를 넣는다.Upload a file을 고르고 Choose file로
ch08_pipeline.yaml을 선택한다.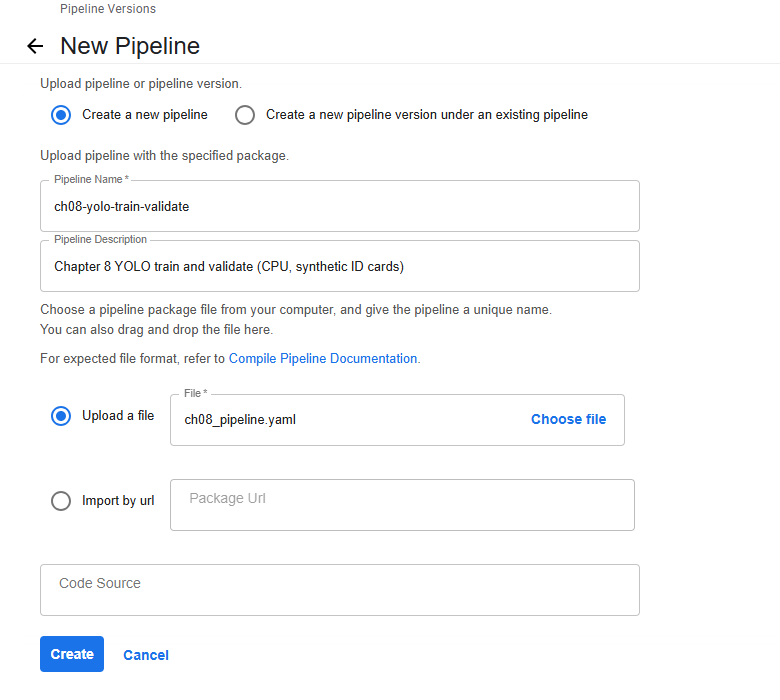
Create를 누르면 그래프가 나온다.
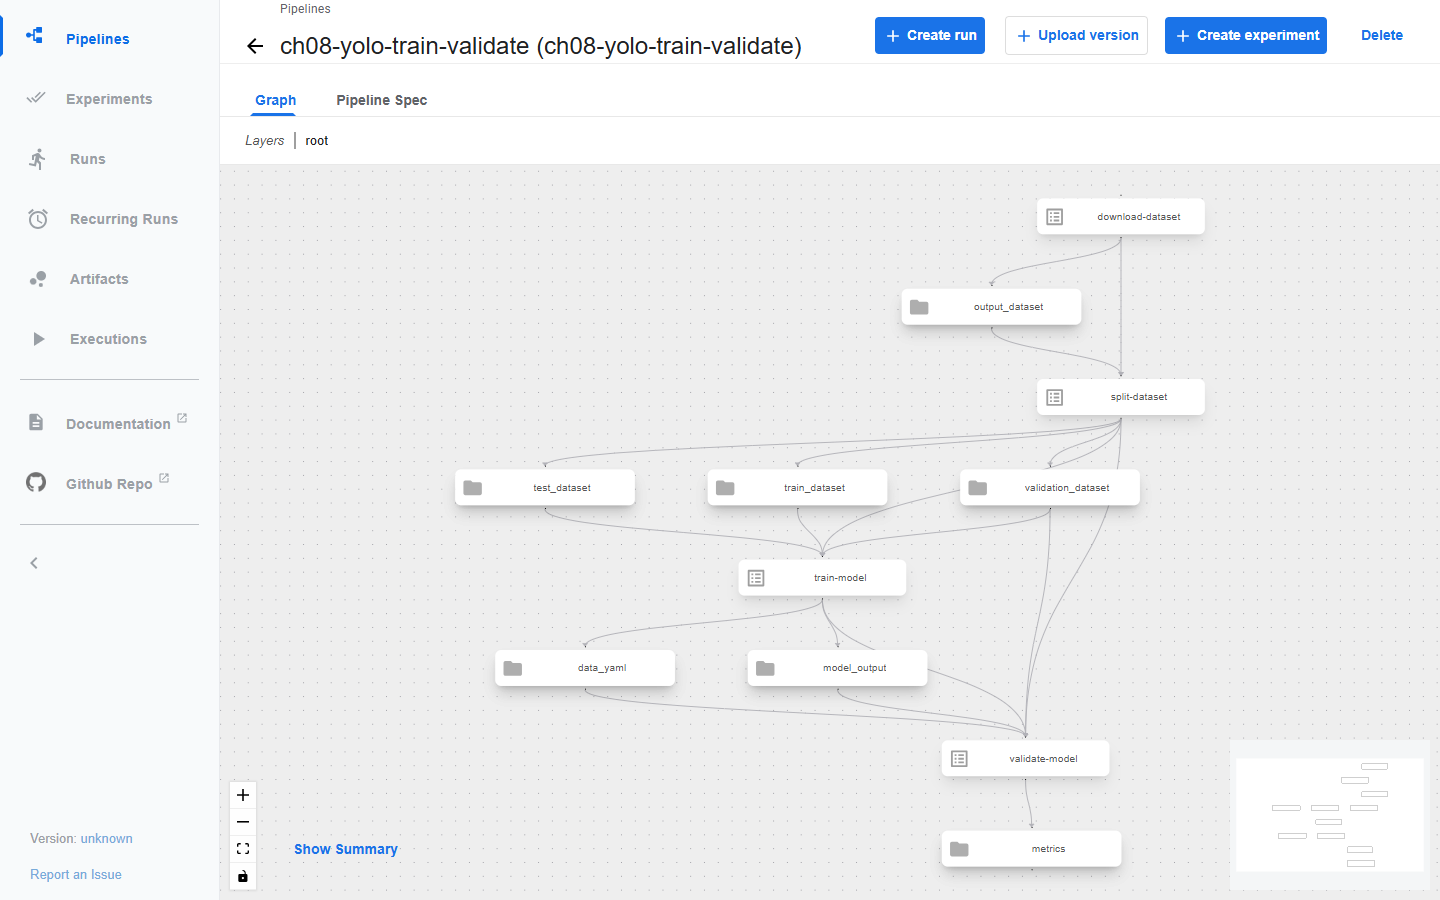
그래프에서 validation_dataset이 train-model과 validate-model 양쪽으로 이어진 선을 찾아보자. 책 그림 8.6이 말한 연결이다. 검증 작업이 학습이 쓴 data.yaml의 절대 경로를 같은 위치에 내려받으려면 이 선이 필요하다.
D. KFP 실행
파라미터를 넘겨 실행하고, 분할 아티팩트가 학습 작업으로 넘어가는 모습을 로그로 본다. 그림으로는 ②~⑤ 구간이다.
D-1. 실험 만들기
파이프라인 화면의 + Create experiment 또는 Experiments → + Create experiment에서 이름
ch08-id-card를 넣고 Next를 누른다.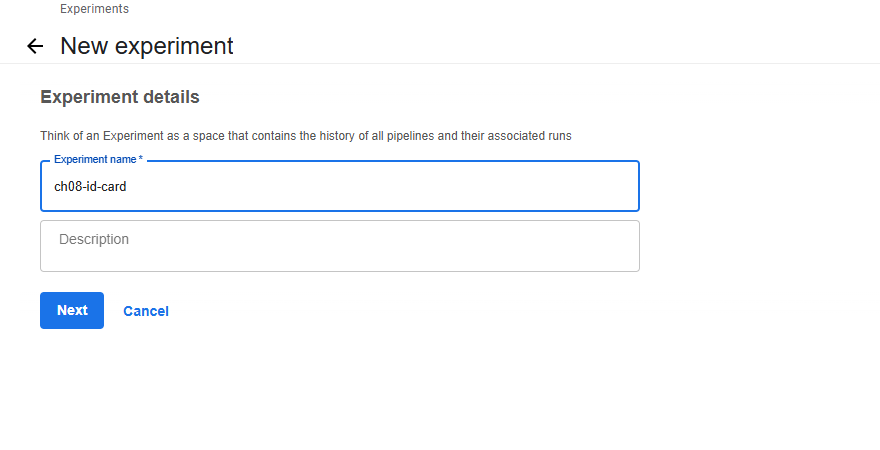
KFP 실험은 파이프라인 실행을 묶는 단위다. G 구간에서 MLflow 실험도 같은 이름으로 만들지만 둘은 서로 다른 기록이다.
D-2. 실행 파라미터
실행 화면에서 파이프라인과 실험이 채워졌는지 확인한다. 실험 목록에서 들어왔다면 Pipeline → Choose로
ch08-yolo-train-validate를 고른다.Run name에
ch08-yolo-e5-img320을 넣고 파라미터를 채운다.파라미터 값 책의 기본값 batch 88 dataset_bucket ch08-datasets없음 epochs 51 imgsz 320640 고정 random_state 4242 yolo_model_name yolov8n_custom같음 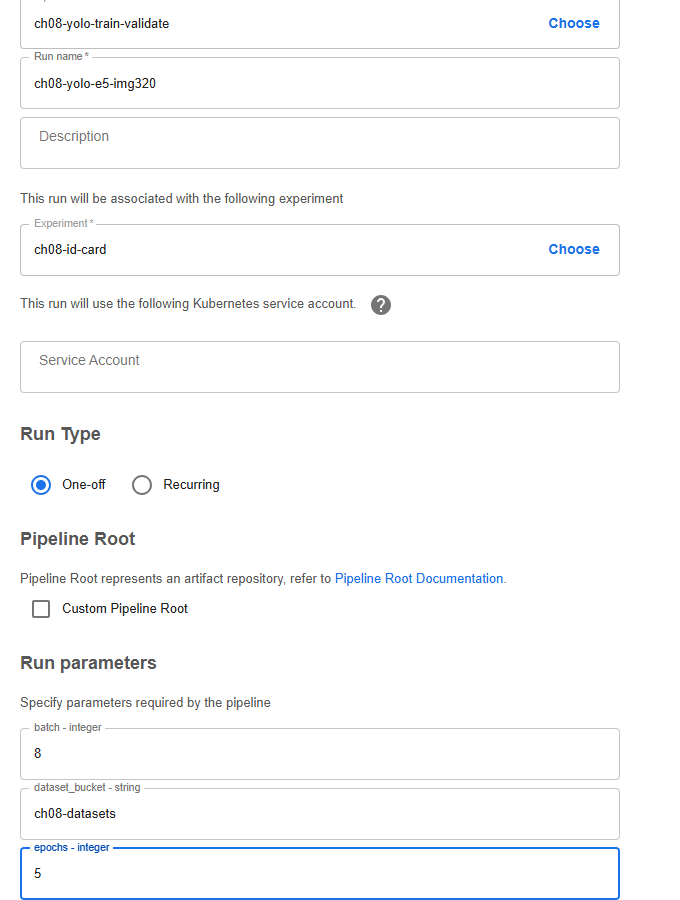
Start를 누른다.
책은 1 epoch를 권한다. 여기서는 CPU에 맞춰 320px로 줄인 대신 5 epoch로 늘렸다. 이번 실행에서 1 epoch는 약 1분 20초였다.
D-3. 실행 그래프
실행 상세 화면에서 네 작업이 차례로 초록색 체크가 되는지 본다. 이번 실행은 모두 17분 11초가 걸렸다.
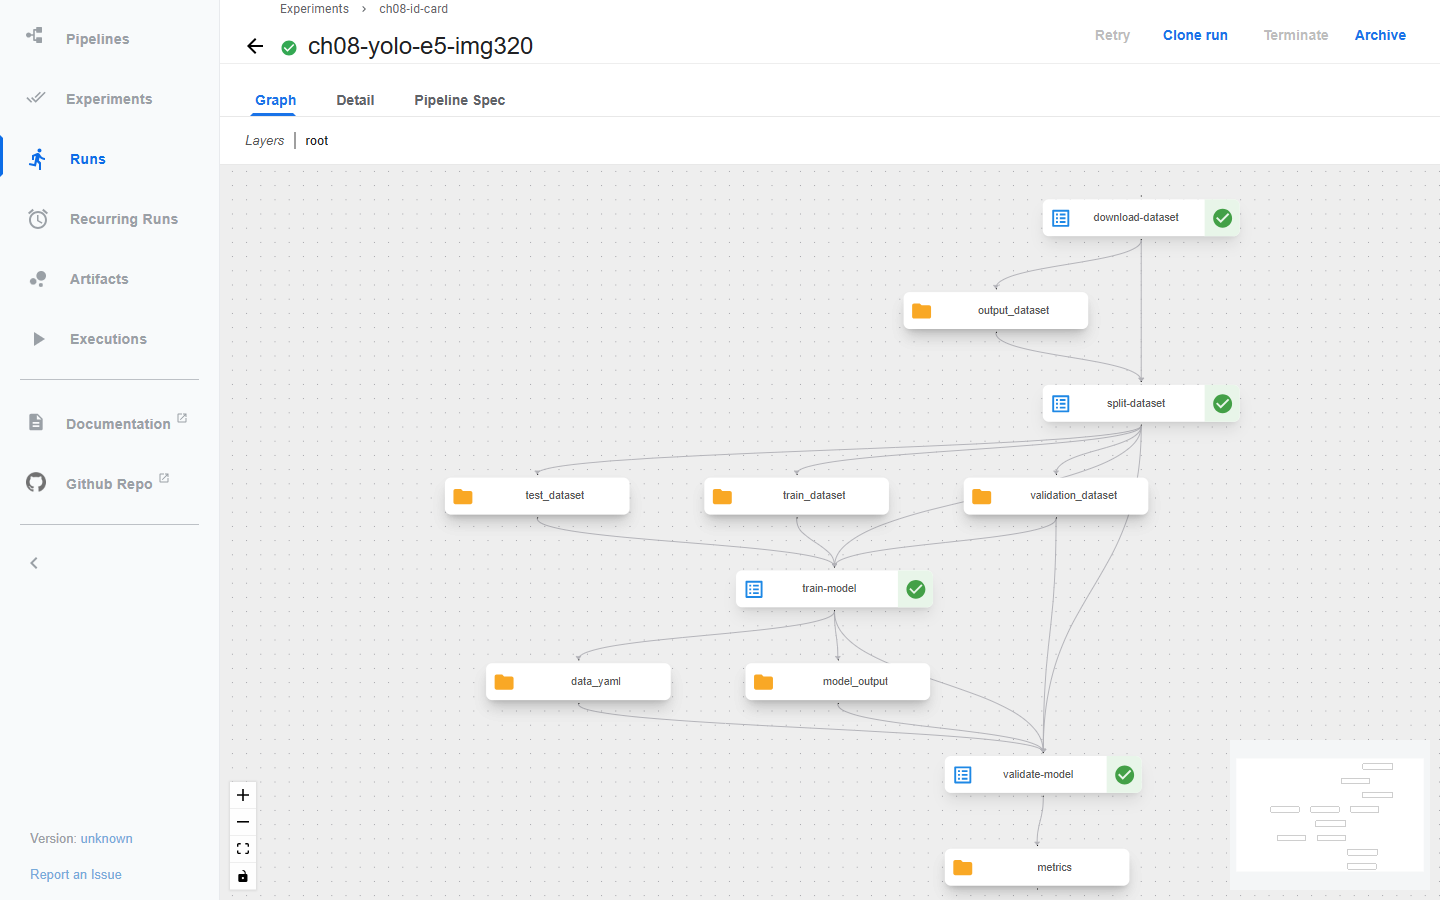
download-dataset을 눌러 Logs 탭에서downloaded s3://ch08-datasets/DATASET.tar.gz (2716385 bytes)를 찾는다. 전체 그림 ③이다.
초록색 체크는 각 Pod가 종료 코드 0으로 끝났다는 뜻이다. 다음 단계로 무엇이 넘어갔는지는 로그와 아티팩트를 봐야 안다.
D-4. 분할 로그에서 짝과 누수 확인
split-dataset을 누르고 Logs 탭에서author-style줄을 찾는다.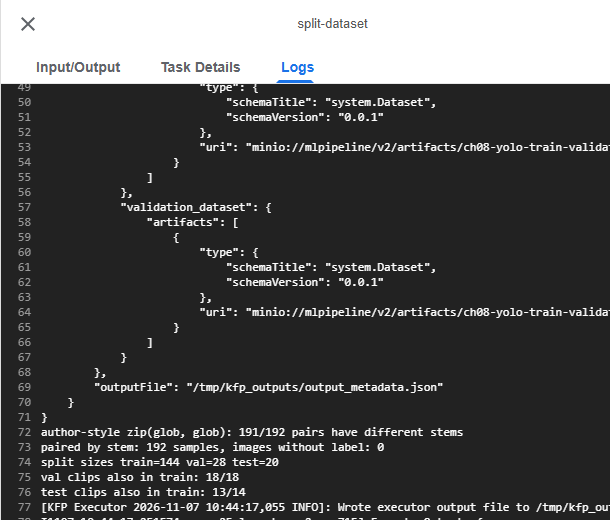
author-style zip(glob, glob): 191/192 pairs have different stems
paired by stem: 192 samples, images without label: 0
split sizes train=144 val=28 test=20
val clips also in train: 18/18
test clips also in train: 13/14
첫 줄이 말하는 바는 이렇다. 저자 코드를 그대로 썼다면 192쌍 중 191쌍이 서로 다른 표본의 이미지와 라벨로 묶였을 것이다. Pod의 파일 시스템에서 glob이 돌려주는 순서는 이름순이 아니다. 아래 두 줄은 무작위 프레임 분할의 결과다. validation의 clip은 전부, test는 14개 clip 중 13개가 train에도 들어갔다. 전체 그림 ④의 아티팩트가 바로 이 분할이다.
D-5. 학습 작업의 입력과 로그
train-model을 누르고 Input/Output 탭을 본다. Input Parameters의epochs 5,imgsz 320과 세 Dataset의minio://mlpipeline/...URI가 전체 그림 ⑤다.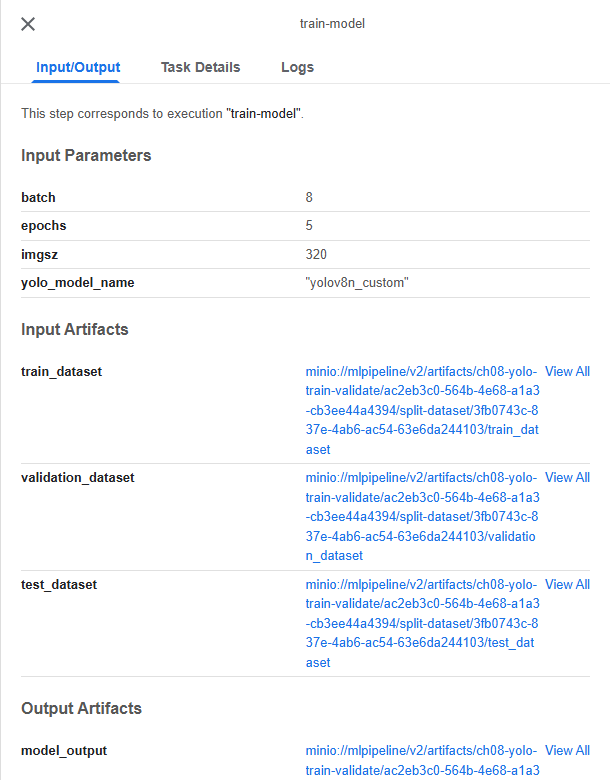
Logs 탭에서
5 epochs completed를 찾는다.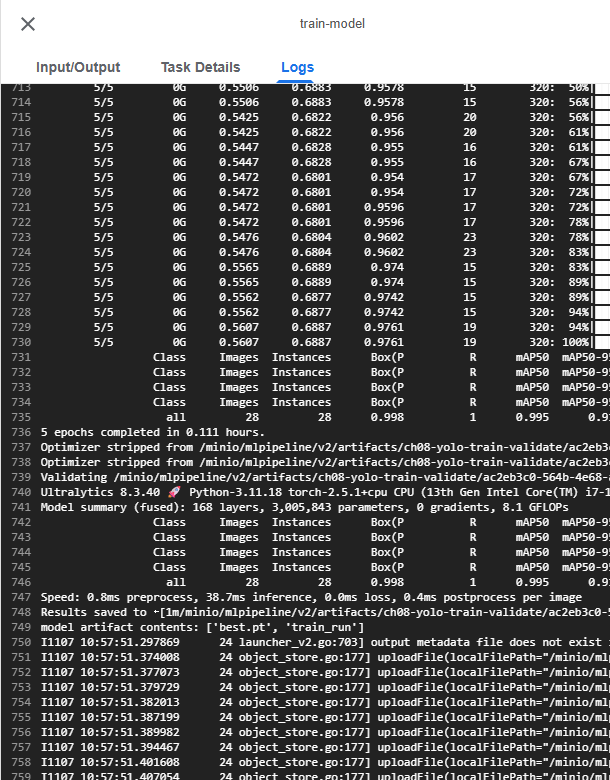
                 all         28         28      0.998          1      0.995      0.919
5 epochs completed in 0.111 hours.
model artifact contents: ['best.pt', 'train_run']
학습 Pod는 처음부터 끝까지 약 13분이 걸렸다. 그중 학습은 0.111시간(약 7분)이고, 나머지는 대부분 apt-get과 pip install이었다. 설치에 학습만큼 시간이 든 셈이다. 로그 앞부분의 optimizer: AdamW(lr=0.002, momentum=0.9)와 Downloading .../yolov8n.pt도 눈여겨볼 만하다. 사전학습 가중치를 매 실행마다 GitHub에서 받는다는 뜻이라, 인터넷이 막힌 클러스터라면 가중치도 이미지나 아티팩트로 넣어야 한다. 마지막 줄 all ... 0.995 0.919는 학습이 끝날 때 validation 분할로 계산한 값이고, E-1과 비교할 기준이 된다.
E. 검증 지표와 산출물 확인
학습이 남긴 가중치를 검증 작업이 다시 읽고, 지표가 KFP 기록에 붙는 모습을 본다.
E-1. 검증 작업 로그
validate-model을 누르고 Logs 탭에서Loading model from을 찾는다.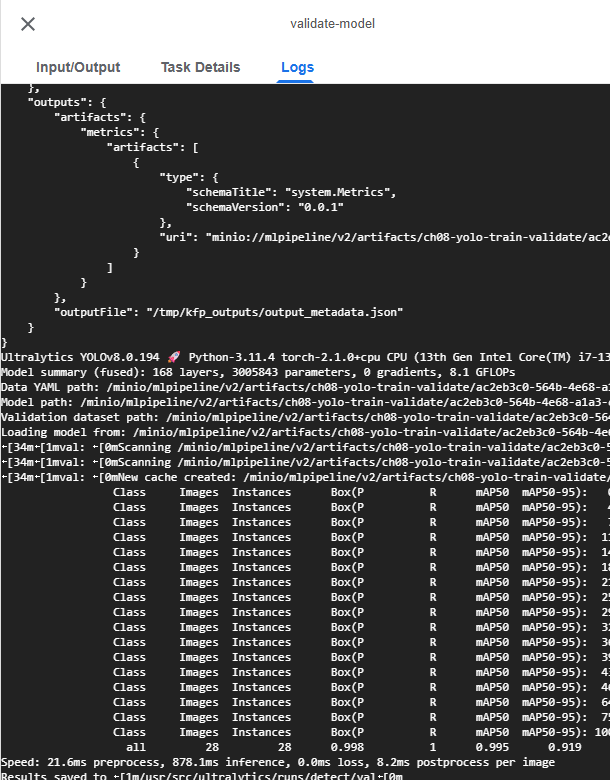
Ultralytics YOLOv8.0.194 🚀 Python-3.11.4 torch-2.1.0+cpu CPU
Loading model from: /minio/mlpipeline/v2/artifacts/ch08-yolo-train-validate/.../model_output/best.pt
                   all         28         28      0.998          1      0.995      0.919
검증 Pod는 학습 Pod와 다른 이미지에서 돌았지만 best.pt를 문제없이 읽었다. 저장한 가중치를 다른 환경에서 다시 로드할 수 있다는 뜻이고, 전체 그림 ⑦에 해당한다. 수치는 D-5 마지막 줄과 같다. 같은 가중치로 같은 validation 28장을 평가했으니 당연하고, 바로 그래서 독립적인 평가가 못 된다. 로그 끝의 Results saved to /usr/src/ultralytics/runs/detect/val은 컨테이너 안의 경로라 이 그림들은 Pod와 함께 사라진다.
E-2. Metrics 아티팩트
그래프 맨 아래
metrics아티팩트를 누르고 Visualization 탭을 연다.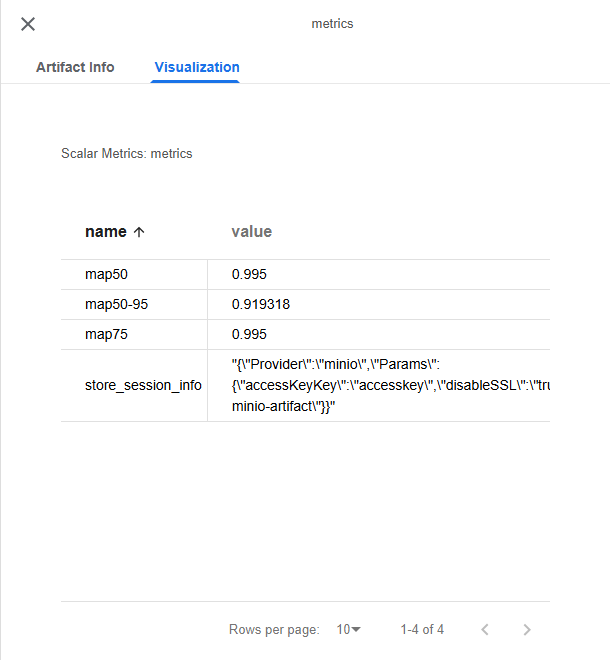
map50 0.995,map50-95 0.919318,map75 0.995가 보이면 전체 그림 ⑧까지 끝난 것이다.
store_session_info 행은 모델 지표가 아니다. KFP 2.4.1이 아티팩트 저장소 정보를 메타데이터에 함께 붙여서 생긴다. 책 그림 8.9와 달리 실행 목록에 지표 열은 붙지 않았다. KFP 2.4.1의 실험 화면에는 이름, 상태, 소요 시간, 파이프라인 버전만 나온다.
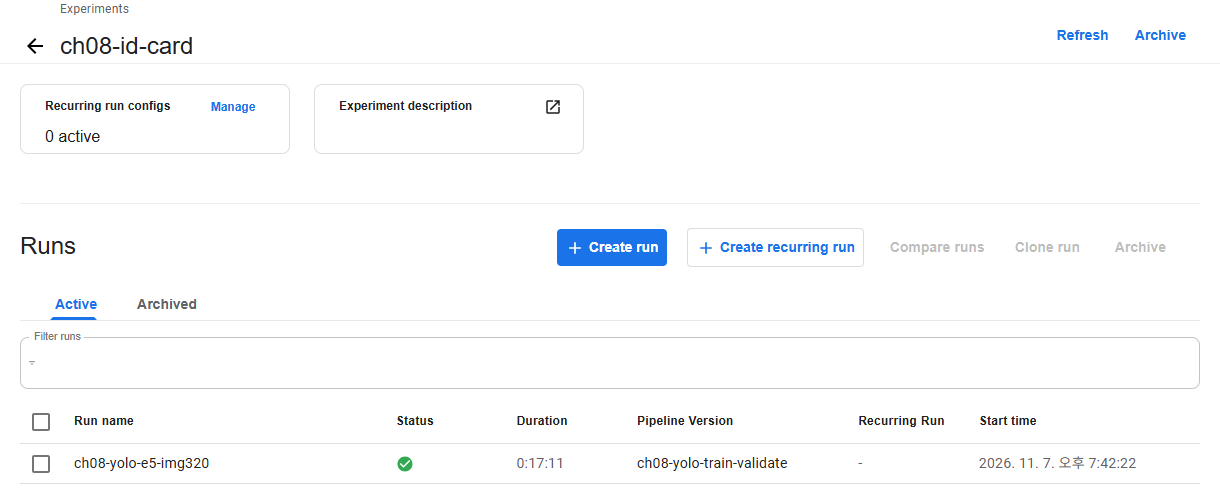
여러 실행의 지표는 실행을 골라 Compare runs에서 비교한다. 비교하기 전에 데이터와 분할이 같은지부터 봐야 지표 차이를 모델 차이로 읽을 수 있다.
E-3. 학습 산출물
http://localhost:8888/buckets/mlpipeline/v2/artifacts/ch08-yolo-train-validate/ 아래에서 실행 ID 폴더,
train-model, 실행 폴더,model_output/train_run순서로 들어간다. 전체 그림 ⑥이 남긴 파일이다.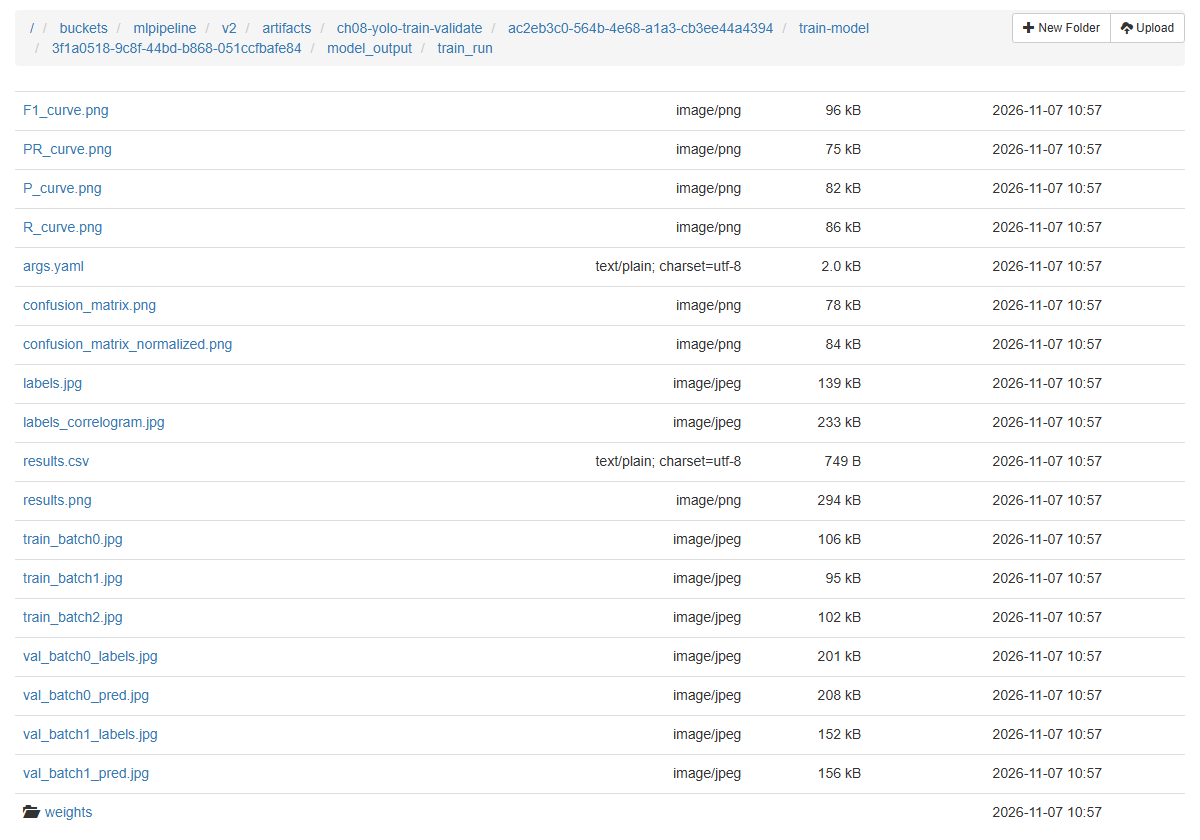
results.png를 열어 epoch별 손실과 지표를 본다.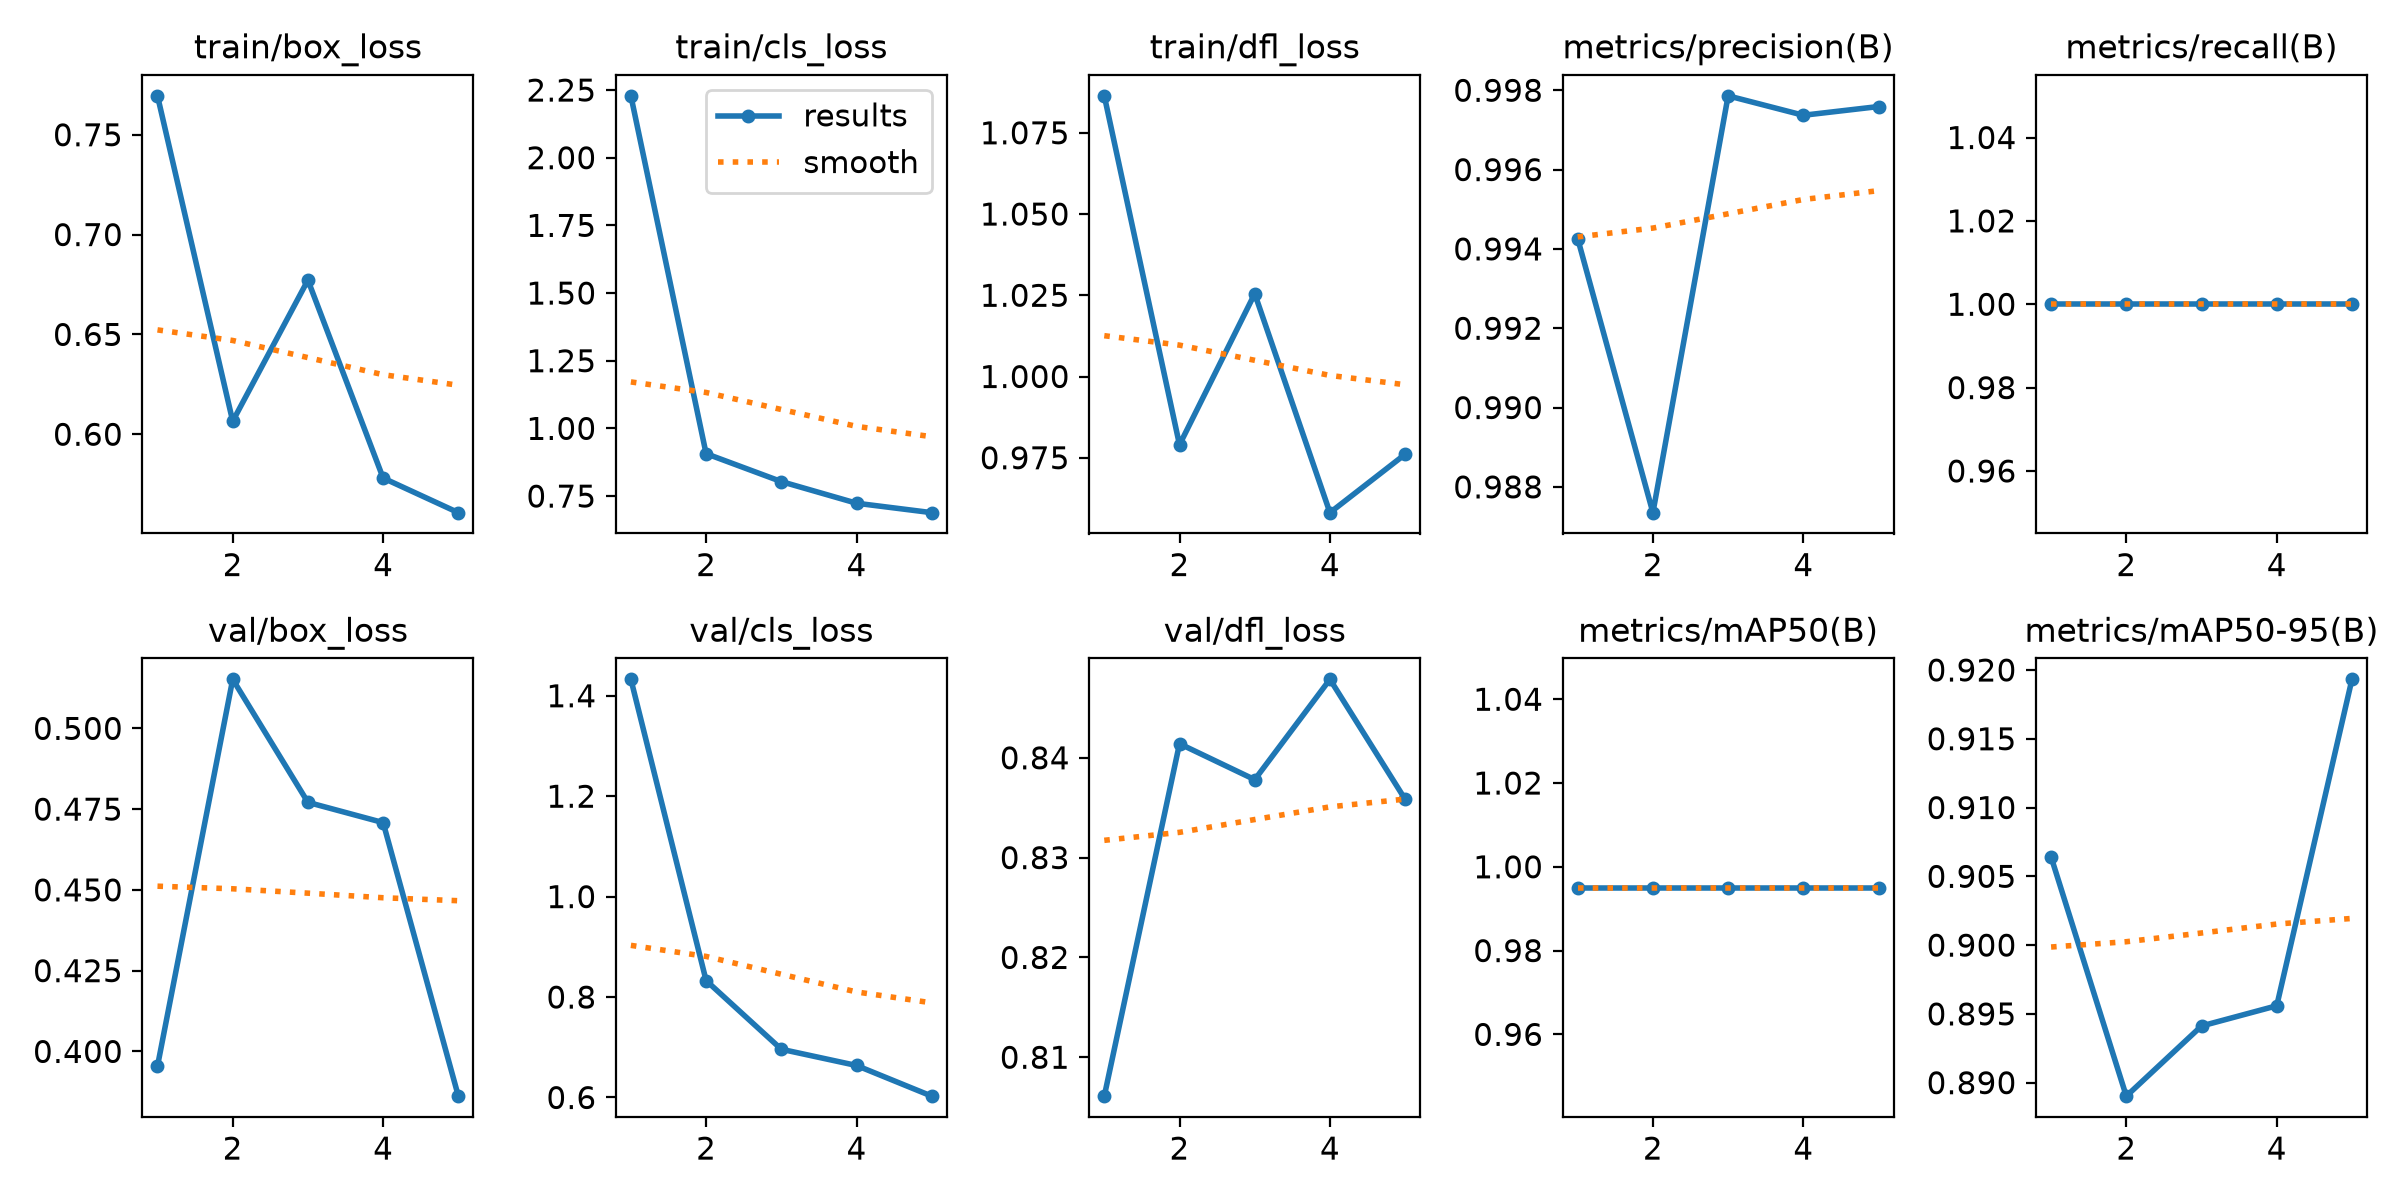
val_batch0_pred.jpg를 연다. 학습 중 validation 이미지에 대한 예측이다.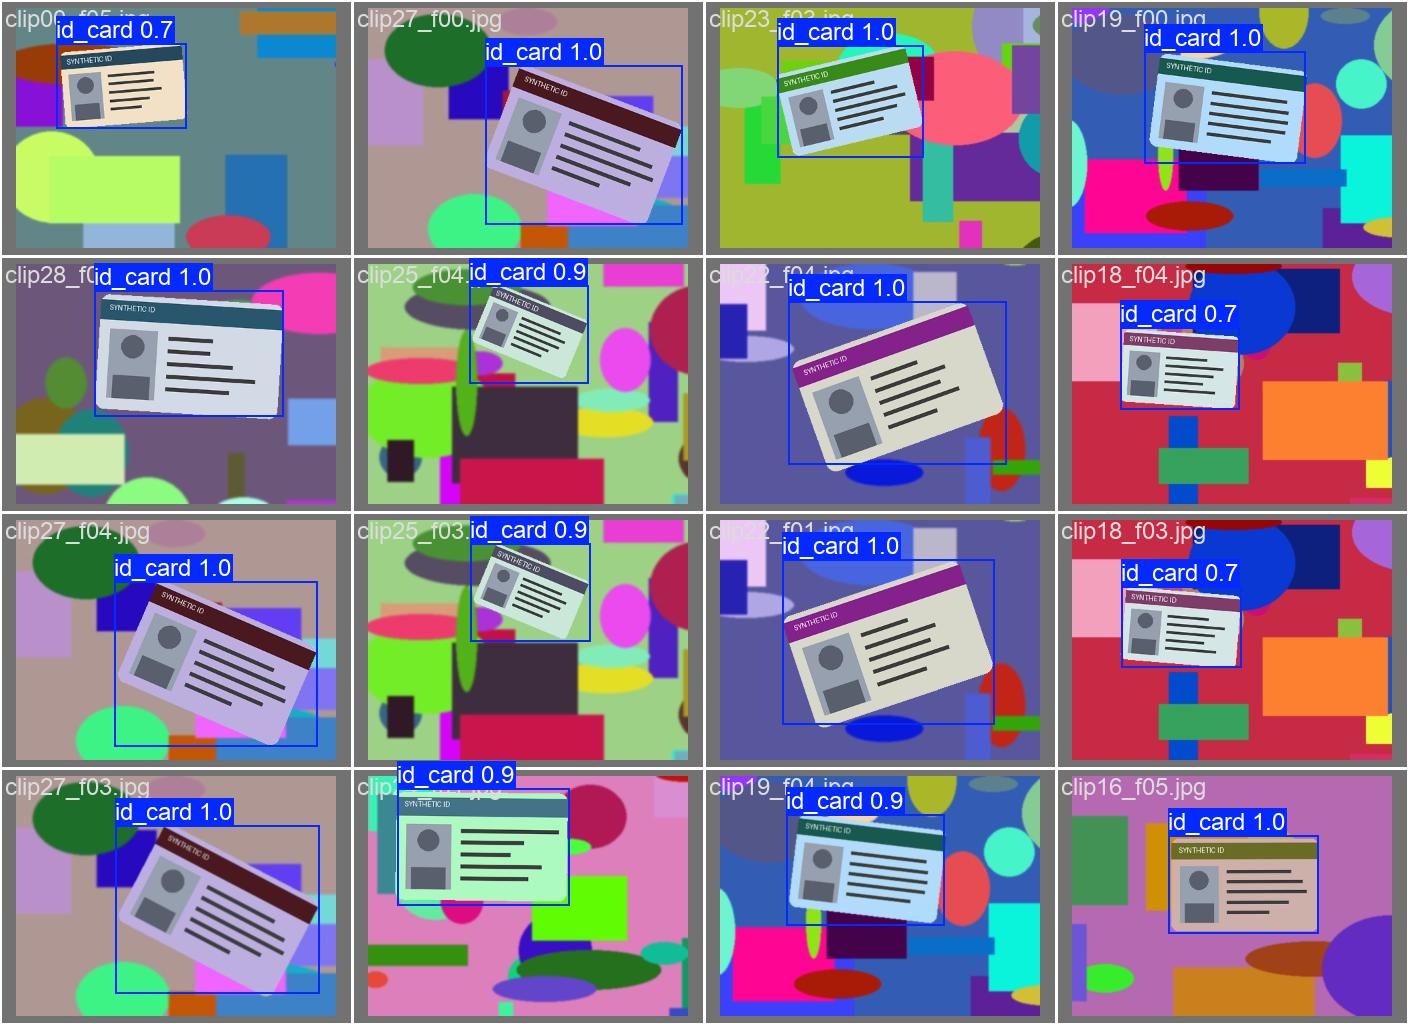
results.png를 보면 recall과 mAP50은 첫 epoch부터 거의 최대값이다. mAP50-95만 0.89~0.92 사이에서 움직인다. 카드를 찾는 일은 처음부터 쉬웠고, 상자 경계의 정확도만 조금씩 바뀌었다는 뜻이다. 다만 점 5개로 그린 곡선이라 추세를 말하기는 어렵다. 예측 샘플에는 clip27_f00, clip27_f03, clip27_f04처럼 같은 카드와 배경의 프레임이 반복된다. D-4의 val clips also in train: 18/18이 눈에 보이는 장면이다. 이 폴더가 남은 것은 C-1의 4번을 고쳤기 때문이다. 저자 코드 그대로라면 model_output에는 best.pt 하나만 있다.
F. 수동 검토
전체 그림의 ⑨, 수동 검토다. 책 8.1.7처럼 가중치를 PC로 내려받아, 지표를 계산한 데이터에 없던 조건에서 시험한다.
F-1. 가중치 내려받기
책은 UI의 Output artifacts에서 압축 파일을 내려받는다. 여기서는 폴더 단위 아티팩트를 한 번에 받으려고 S3에서 직접 받았다.
- 아래 내용을
download_artifacts.py로 저장한다."""Download the train-model artifacts of one KFP run from the pipeline root (mlpipeline bucket).""" import os, sys, boto3 run_id = sys.argv[1] s3 = boto3.client("s3", endpoint_url="http://127.0.0.1:9000", aws_access_key_id="minio", aws_secret_access_key="minio123") prefix = f"v2/artifacts/ch08-yolo-train-validate/{run_id}/train-model/" n = 0 for page in s3.get_paginator("list_objects_v2").paginate(Bucket="mlpipeline", Prefix=prefix): for o in page.get("Contents", []): rel = o["Key"].split("/train-model/", 1)[1].split("/", 1)[1] # drop execution id dest = os.path.join("kfp_artifacts", rel) os.makedirs(os.path.dirname(dest), exist_ok=True) s3.download_file("mlpipeline", o["Key"], dest) n += 1 print(f"downloaded {n} files to kfp_artifacts") for root in ["kfp_artifacts/model_output", "kfp_artifacts/data_yaml"]: print(root, sorted(os.listdir(root))) print(open("kfp_artifacts/data_yaml/data.yaml").read()) - KFP 실행 상세 화면 주소 끝의 실행 ID를 넣어 실행한다.
.\.venv\Scripts\python.exe download_artifacts.py ac2eb3c0-564b-4e68-a1a3-cb3ee44a4394downloaded 22 files to kfp_artifacts kfp_artifacts/model_output ['best.pt', 'train_run'] kfp_artifacts/data_yaml ['data.yaml'] names: 0: id_card nc: 1 test: /minio/mlpipeline/v2/artifacts/ch08-yolo-train-validate/ac2eb3c0-.../split-dataset/.../test_dataset/images train: /minio/mlpipeline/v2/artifacts/ch08-yolo-train-validate/ac2eb3c0-.../split-dataset/.../train_dataset/images val: /minio/mlpipeline/v2/artifacts/ch08-yolo-train-validate/ac2eb3c0-.../split-dataset/.../validation_dataset/images
data.yaml의 경로는 Pod 안에서만 의미가 있다. PC에서 이 파일로 model.val()을 돌리면 경로가 없어 실패한다. 다시 평가하려면 분할 아티팩트도 내려받고 경로를 바꿔야 한다. 학습 설정을 아티팩트로 남겼어도 그 안의 경로가 실행 환경에 묶여 있으면 재현 가능한 기록이라고 하기 어렵다.
F-2. 사전학습 모델과 학습 모델 비교
책 Listing 8.15와 8.16은 cv2.imshow로 한 장씩 띄운다. 여기서는 창 대신 결과 이미지를 저장하게 바꿨다.
학습에 쓰지 않은 표본을 만든다. B-2의 스크립트를 다른 seed로 돌려 새 clip 4개와 카드 없는 이미지 2장을
samples에 모은다..\.venv\Scripts\python.exe make_synthetic_idcards.py --out holdout --clips 4 --frames 1 --negatives 2 --seed 2026 --tar holdout.tar.gz mkdir samples; Copy-Item holdout\MINIDATA\images\*.jpg samples\아래 내용을
review.py로 저장한다."""8.1.7 manual review. Saves plotted images instead of cv2.imshow (no GUI needed).""" import glob, os, sys import cv2 from ultralytics import YOLO weights = sys.argv[1] if len(sys.argv) > 1 else "yolov8n.pt" out = sys.argv[2] if len(sys.argv) > 2 else "review_out" os.makedirs(out, exist_ok=True) model = YOLO(weights) for file in sorted(glob.glob("samples/*.jpg")): result = model(cv2.imread(file), imgsz=320, verbose=False) r = result[0] names = [f"{r.names[int(c)]}:{float(s):.2f}" for c, s in zip(r.boxes.cls, r.boxes.conf)] print(os.path.basename(file), names if names else "no detection") cv2.imwrite(os.path.join(out, os.path.basename(file)), r.plot())사전학습 가중치와 학습한 가중치로 각각 실행한다.
.\.venv\Scripts\python.exe review.py yolov8n.pt review_pretrained
.\.venv\Scripts\python.exe review.py kfp_artifacts\model_output\best.pt review_trained
clip00_f00.jpg ['traffic light:0.34'] clip01_f00.jpg no detection clip02_f00.jpg no detection clip03_f00.jpg no detection neg00.jpg no detection neg01.jpg ['chair:0.33']clip00_f00.jpg ['id_card:0.95'] clip01_f00.jpg ['id_card:1.00'] clip02_f00.jpg ['id_card:0.86'] clip03_f00.jpg ['id_card:1.00'] neg00.jpg no detection neg01.jpg no detection두 폴더의 이미지를 나란히 놓고 본다.
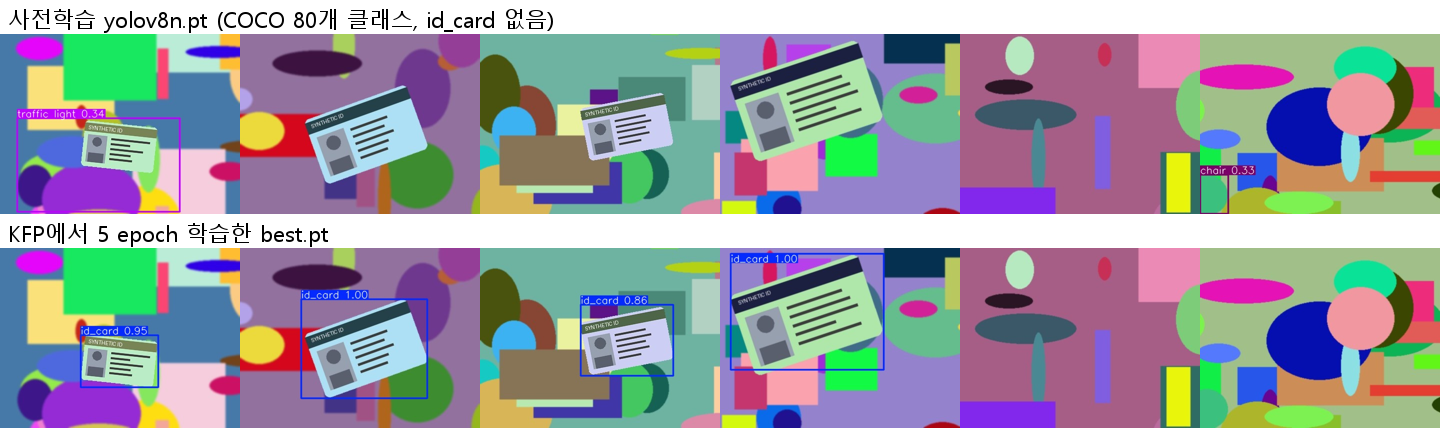
사전학습 YOLOv8n은 COCO의 80개 클래스만 안다. 그래서 카드 주변을 traffic light 0.34로 잡거나 아무것도 찾지 못했다. 책의 그림에서 카드를 book 0.28로 잡은 것과 같은 현상이다. 학습한 가중치는 새 clip의 카드 네 장을 0.86~1.00으로 찾았고, 카드 없는 두 장에서는 아무것도 찾지 않았다. 책이 말하는 “학습은 동작한다"는 확인은 여기까지로 충분하다.
F-3. 학습 데이터에 없던 조건 시험
아래 내용을
stress_review.py로 저장하고 실행한다. 같은 표본을 90도 회전, 강한 흐림, 작은 카드, 어두운 조명으로 바꾼다."""Stress cases for manual review: transformations the training data never showed.""" import os from PIL import Image, ImageFilter import cv2 from ultralytics import YOLO os.makedirs("stress", exist_ok=True) src = Image.open("samples/clip01_f00.jpg") cases = { "rot90": src.rotate(90, expand=True), "blur8": src.filter(ImageFilter.GaussianBlur(8)), "small": Image.new("RGB", src.size, (128, 128, 128)), "dark": src.point(lambda v: int(v * 0.25)), } cases["small"].paste(src.resize((src.width // 4, src.height // 4)), (200, 150)) m = YOLO("kfp_artifacts/model_output/best.pt") for k, im in cases.items(): p = f"stress/{k}.jpg"; im.save(p) r = m(cv2.imread(p), imgsz=320, verbose=False)[0] print(k, [f"{float(s):.2f}" for s in r.boxes.conf] or "no detection") cv2.imwrite(f"stress/{k}_pred.jpg", r.plot()).\.venv\Scripts\python.exe stress_review.pyrot90 ['0.98'] blur8 no detection small no detection dark no detectionstress폴더의*_pred.jpg를 연다.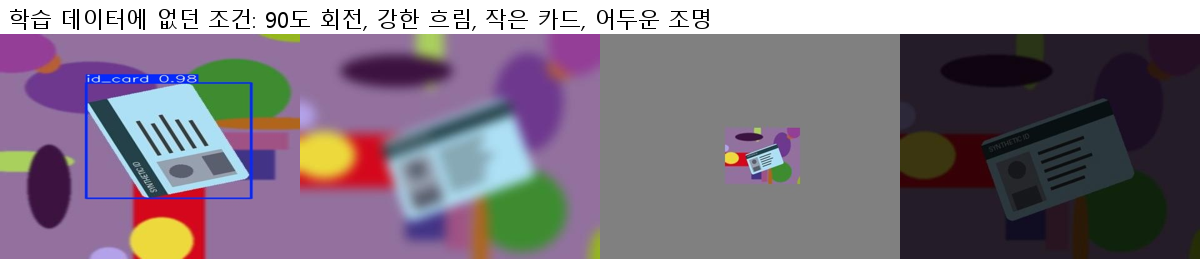
map50이 0.995인 모델이 네 조건 중 세 개에서 카드를 놓쳤다. 학습 데이터의 흐림은 약했고, 카드 크기는 140~300px였고, 조명 변화는 없었다. 검증 분할도 같은 분포에서 나왔으니 지표에는 이 실패가 잡힐 수 없었다. 수동 검토가 남기는 것은 이런 실패 목록이다. 이 목록이 다음 데이터 수집과 세부 평가 집단의 근거가 된다.
F-4. 무작위 분할과 clip 분할 비교
같은 192장을 두 방식으로 나눠 같은 조건(5 epoch, 320px, seed 42)으로 로컬에서 학습했다. 하나는 저자 방식의 프레임 단위 무작위 분할로, sklearn의 train_test_split을 저자와 같은 비율로 두 번 적용했다. 다른 하나는 clip 단위 분할로, clip 이름 목록을 seed 42로 섞어 앞 75%를 train, 다음 15%를 validation으로 썼다. 파이프라인 밖의 보조 실험이라 스크립트는 생략한다.
| 분할 | train | validation | train에도 있는 validation clip | map50 | map50-95 |
|---|---|---|---|---|---|
| 프레임 단위 무작위 | 144 | 28 | 18 | 0.995 | 0.928 |
| clip 단위 | 131 | 36 | 0 | 0.995 | 0.928 |
두 방식의 차이는 보이지 않았다. 앞의 누수 설명대로 합성 데이터가 너무 쉬워서 처음 보는 clip도 거의 완벽하게 찾는다. 그러니 누수가 점수에 영향을 주지 않는다고 결론 낼 수는 없다. 더 중요한 것은 F-3에서 분포 밖 조건의 실패가 나왔다는 사실이다. 같은 분포에서 나눈 검증만으로는 일반화를 판단할 수 없다. 실제 촬영 데이터로 비교하면 차이가 날 수 있지만, 이 글에서는 해 보지 않았다.
G. 보충: MLflow 기록과 등록 결정
마지막 ⑩은 책 8장의 범위 밖이다. 9장에서 다룰 MLflow 연결을 미리 써서 검증 결과를 등록 결정까지 잇는다.
G-1. 실행 기록 남기기
아래 내용을
log_to_mlflow.py로 저장한다. KFP 실행 ID, 데이터 위치, 학습 설정과 지표, 수동 검토 결과를 한 run에 모은다."""Record one KFP training run in MLflow and register it with an explicit release decision.""" import csv, os, sys, yaml import mlflow from mlflow import MlflowClient os.environ.setdefault("MLFLOW_S3_ENDPOINT_URL", "http://127.0.0.1:9000") os.environ.setdefault("AWS_ACCESS_KEY_ID", "minio") os.environ.setdefault("AWS_SECRET_ACCESS_KEY", "minio123") mlflow.set_tracking_uri("http://127.0.0.1:5000") mlflow.set_experiment("ch08-id-card") kfp_run_id = sys.argv[1] art = "kfp_artifacts/model_output/train_run" args = yaml.safe_load(open(f"{art}/args.yaml")) kfp_metrics = {"map50": 0.995, "map50_95": 0.919318, "map75": 0.995} # validate-model Metrics artifact of this run stress = {"rot90": 1, "blur8": 0, "small": 0, "dark": 0} # stress_review.py result with mlflow.start_run(run_name=f"kfp-{kfp_run_id[:8]}") as run: mlflow.set_tags({"kfp_run_id": kfp_run_id, "dataset_uri": "s3://ch08-datasets/DATASET.tar.gz", "dataset_note": "synthetic ID-card-like images, frame-level random split", "author_code": "practical-mlops/object-detection-project@c6afb11"}) mlflow.log_params({k: args[k] for k in ["model", "epochs", "batch", "imgsz", "optimizer", "seed"]}) for row in csv.DictReader(open(f"{art}/results.csv")): row = {k.strip(): v for k, v in row.items()} step = int(row["epoch"]) mlflow.log_metrics({"train_box_loss": float(row["train/box_loss"]), "val_box_loss": float(row["val/box_loss"]), "val_map50_95_epoch": float(row["metrics/mAP50-95(B)"])}, step=step) mlflow.log_metrics({f"kfp_val_{k}": v for k, v in kfp_metrics.items()}) mlflow.log_metric("stress_detect_rate", sum(stress.values()) / len(stress)) mlflow.log_artifacts(art, artifact_path="train_run") mlflow.log_artifact("kfp_artifacts/data_yaml/data.yaml", artifact_path="config") run_id = run.info.run_id c = MlflowClient() name = "ch08-id-card-detector" try: c.create_registered_model(name, description="Chapter 8 lab model (synthetic data, CPU, 5 epochs)") except Exception: pass mv = c.create_model_version(name, source=f"runs:/{run_id}/train_run/weights", run_id=run_id, tags={"kfp_val_map50_95": "0.919", "manual_review": "fail: blur, small, dark", "release_decision": "hold"}) print("mlflow run_id:", run_id) print("registered:", name, "version", mv.version, "status", mv.status)Windows 콘솔에서 MLflow가 출력하는 이모지 때문에 실패하지 않게 UTF-8을 지정하고 실행한다.
$env:PYTHONIOENCODING = "utf-8"
.\.venv\Scripts\python.exe log_to_mlflow.py ac2eb3c0-564b-4e68-a1a3-cb3ee44a4394
mlflow run_id: 74f605c4bb544d50bf88abf3500c587b registered: ch08-id-card-detector version 1 status READYhttp://localhost:5000 에서 실험
ch08-id-card의 runkfp-ac2eb3c0을 연다. Tags의kfp_run_id가 KFP 실행과 이 기록을 잇는다.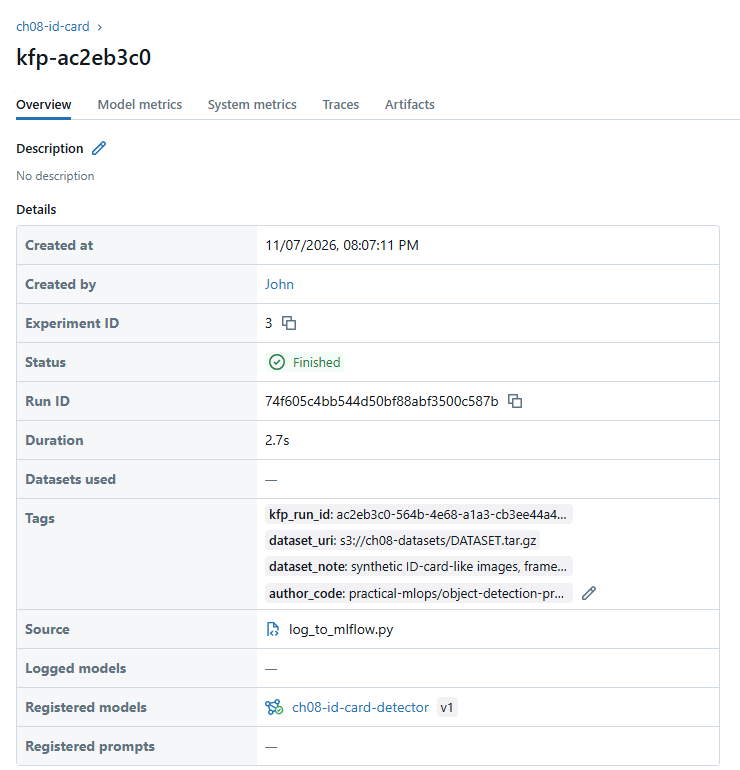
Model metrics 탭에서 KFP 검증 지표와
stress_detect_rate 0.25를 함께 본다.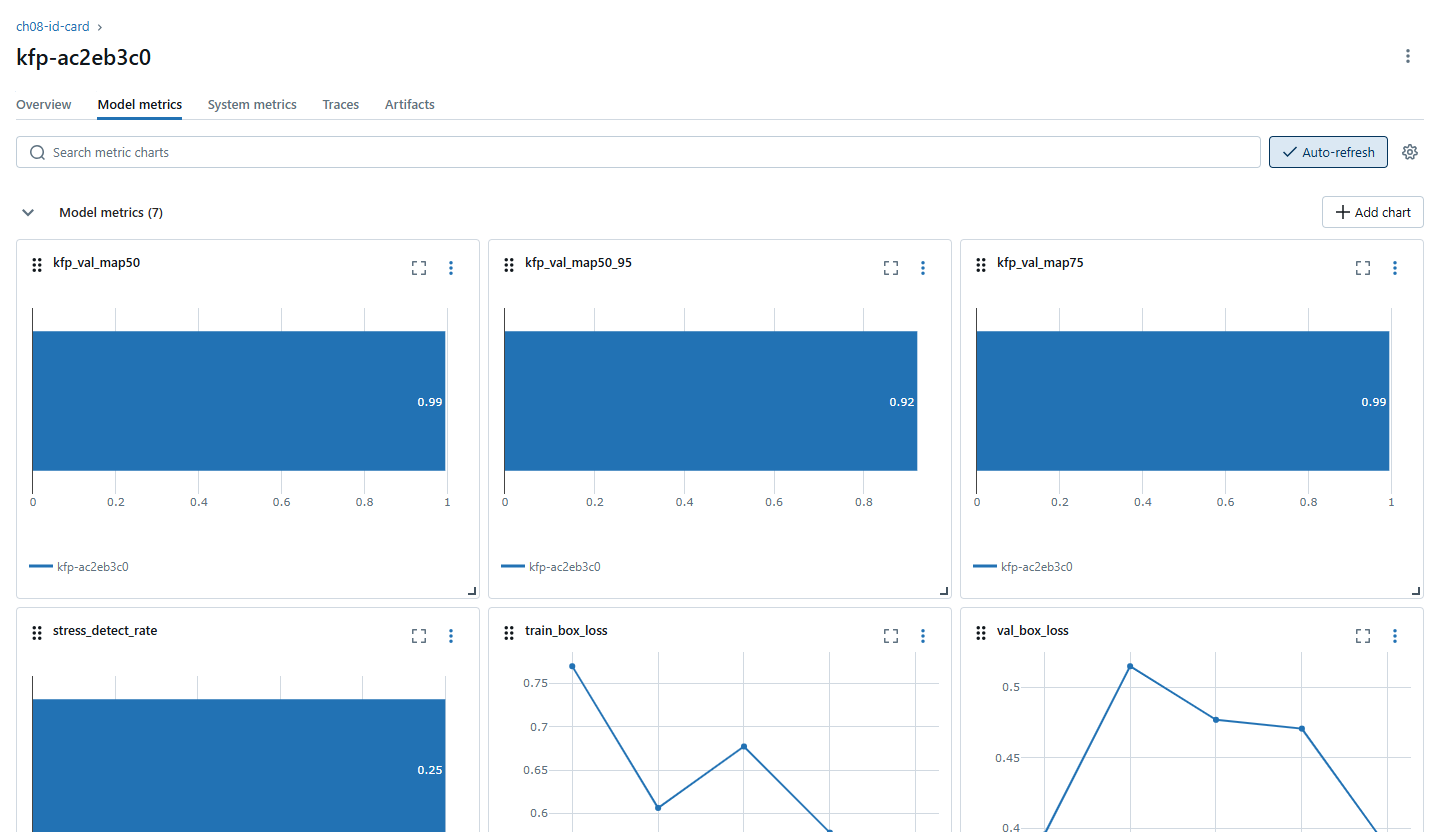
PYTHONIOENCODING 없이 돌리면 run을 끝내는 단계에서 UnicodeEncodeError: 'cp949' codec can't encode character가 나고, run이 RUNNING 상태로 남는다. 처음에 그렇게 남은 run은 지우고 다시 실행했다.
G-2. 등록 결정 확인
Models → ch08-id-card-detector → Version 1을 연다. 새 모델 레지스트리 UI를 안내하는 창이 뜨면 닫는다.
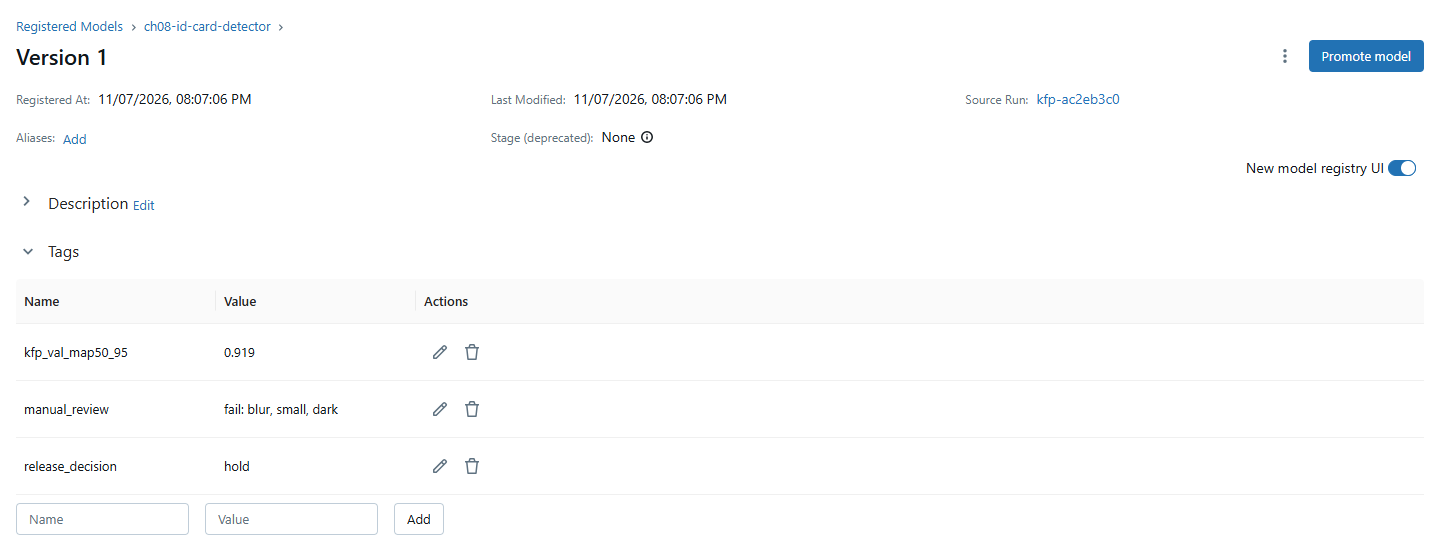
release_decision hold와manual_review fail: blur, small, dark태그를 확인한다. Aliases는 비워 둔다.
모델을 등록했다는 것은 이 가중치를 이름과 버전으로 찾을 수 있게 됐다는 뜻까지다. 서비스에 써도 된다는 허락은 아니다. 10장의 서빙이 champion 같은 alias로 모델을 찾는다면, alias를 붙이는 순간이 곧 출시 결정이다. 이번 버전은 지표는 높지만 수동 검토에서 실패 조건이 나왔으므로 보류로 남겼다. 실제 운영이라면 결정한 사람과 근거 문서도 함께 남긴다.
H. 오류 대응과 정리
H-1. 이번 실행에서 만난 오류
| 증상 | 원인 | 대응 |
|---|---|---|
manning.box.com 다운로드 404 | 원래 데이터 공유 종료 | B 구간의 합성 데이터와 S3 다운로드 |
Package 'libgl1-mesa-glx' has no installation candidate | python:3.11-slim이 Debian trixie로 바뀜 | libgl1로 교체 |
module 'numpy' has no attribute 'trapz' | NumPy 2.4에서 함수 제거, Ultralytics 8.3.40이 사용 | numpy==1.26.4 고정 |
학습 Pod의 pip가 오래 멈춤 | 버전 미고정 패키지의 의존성 탐색 | 버전 고정, 가능하면 의존성을 담은 이미지 사용 |
kind load docker-image의 content digest ... not found | 다중 플랫폼 이미지 인덱스 | docker save --platform linux/amd64 후 kind load image-archive |
| docker.io의 TLS handshake timeout | 네트워크 일시 오류 | docker pull 재시도 |
MLflow 기록 중 cp949 UnicodeEncodeError | Windows 콘솔 인코딩 | $env:PYTHONIOENCODING = "utf-8", 남은 RUNNING run 삭제 |
| MLflow 모델 화면이 회색으로 가려짐 | 새 레지스트리 UI 안내 창 | 창의 닫기 버튼 |
H-2. 실패한 작업에서 확인할 것
| 실패 위치 | 확인할 것 |
|---|---|
download-dataset의 NoSuchBucket, NoSuchKey | B-3의 버킷과 파일 이름, dataset_bucket 파라미터 |
split-dataset의 ValueError | 압축 파일 안의 MINIDATA/images, MINIDATA/labels 구조 |
train-model의 ImportError: libGL.so.1 | apt-get 단계의 패키지 이름과 그 이전 오류 |
train-model의 FileNotFoundError: .../weights/best.pt | 학습 로그 앞부분의 데이터 경로와 라벨 수 |
| validate-model의 경로 오류 | validation_dataset 입력을 지우지 않았는지 |
validate-model의 ErrImagePull | C-3의 이미지 적재 |
H-3. 정리
이 실습이 만든 리소스는 모두 ch08 접두사를 쓴다. 다른 장의 실습과 같은 클러스터를 쓴다면 아래 항목만 지운다.
- KFP: Runs에서
ch08-yolo-e5-img320을 Archive하고, Experiments의ch08-id-card를 보관하고, Pipelines에서ch08-yolo-train-validate를 삭제한다. - 저장소의 데이터와 실행 아티팩트를 지운다.
.\.venv\Scripts\python.exe -c "import boto3; s3=boto3.resource('s3',endpoint_url='http://127.0.0.1:9000',aws_access_key_id='minio',aws_secret_access_key='minio123'); b=s3.Bucket('ch08-datasets'); b.objects.all().delete(); b.delete(); s3.Bucket('mlpipeline').objects.filter(Prefix='v2/artifacts/ch08-yolo-train-validate/').delete()" - MLflow: 모델
ch08-id-card-detector를 삭제하고 실험ch08-id-card를 삭제한다. - PC의
ch08폴더를 지운다. 클러스터 전체를 지우려면 4~5장 글의 정리 단계처럼python bookenv.py down을 실행한다.