책 1~13장 순차 실습 가이드
개념은 챕터 해설에서 다루고, 이 가이드에는 손으로 따라 하는 부분만 모았다. 『Machine Learning Platform Engineering』 1~13장 순서대로 환경을 만들고, 데이터와 모델을 준비하고, 서비스를 띄우고, 변경을 평가한다. 앞 단계가 남긴 파일을 다음 단계가 입력으로 쓰므로 순서를 건너뛰면 막힌다.
기준은 독립 실습 저장소 ml-platform-engineering-labs의 고정 커밋 ff23b38f88d88268216e2985ff5b6ed0c3defb8c이다. 책의 저자 코드를 kind 클러스터에서 그대로 돌린 기록은 장별 실습 기록에 따로 있고, 이 가이드는 같은 개념을 작은 데이터로 1장부터 13장까지 끊김 없이 이어 붙인 판이다. 본문의 출력과 화면은 Windows 11, Docker Desktop 4.67.0, kind book-env 클러스터에서 새 작업 폴더를 만들어 명령을 위에서부터 다시 실행한 결과다. 외부 유료 LLM, DeepEval과 Langfuse 연결은 돌리지 않았다. 실행한 것과 남은 것은 구현과 검증 범위에 정리했다.
출력의 개인 경로는 C:\Users\<사용자>\... 또는 ...\로 줄였다. 실행 ID, 해시, 점수는 실행마다 달라진다. 형식과 판정이 같으면 정상이다.
준비사항
표의 위에서부터 설치하고 확인 명령을 돌린다. 명령은 모두 Windows PowerShell 7 기준이다. 설치한 뒤에는 새 PowerShell 창을 열어야 PATH가 반영된다.
| 항목 | 필요한 구간 | 설치 | 확인 |
|---|---|---|---|
| Git | 전체 | winget install --id Git.Git -e | git --version |
| uv | 전체 | winget install --id astral-sh.uv -e | uv --version |
| Python 3.12 | 전체 | uv python install 3.12 | uv python find 3.12 |
| Docker Desktop (Linux 엔진) | 3장, 5장 | winget install --id Docker.DockerDesktop -e | docker version |
| kind v0.27.0 | 3장, 5장 | 아래 다운로드 명령 | kind version |
| kubectl | 3장, 5장 | Docker Desktop에 포함, 또는 winget install --id Kubernetes.kubectl -e | kubectl version --client |
| Node.js LTS | 13장 Promptfoo | winget install --id OpenJS.NodeJS.LTS -e | node --version |
winget은 최신판을 설치한다. 2026년 11월 기준으로는 uv 0.13.7, Docker Desktop 4.98.0, Node.js 26.13.0이 깔리는데, 이 가이드를 검증한 버전(uv 0.12.3, Docker Desktop 4.67.0, Node.js 24.12.0)보다 새롭다. 의존성은 uv.lock과 promptfoo@0.125.0이 고정하므로 그대로 진행해도 된다. 출력 형식이 달라 보이면 통과 여부, 종료 코드, 개수 같은 판정 값만 비교한다.
0-1. Git과 uv를 확인한다
터미널 A, 아무 폴더. Git은 실습 코드를 고정 커밋으로 받고, uv는 Python과 가상환경을 잠금 파일 그대로 설치한다.
git --version
uv --version
실제 출력:
git version 2.47.1.windows.1
uv 0.12.3 (507230998 2026-08-07 x86_64-pc-windows-msvc)
winget을 쓸 수 없으면 uv는 powershell -ExecutionPolicy ByPass -c "irm https://astral.sh/uv/install.ps1 | iex"로 설치한다.
0-2. Python 3.12를 uv로 설치한다
터미널 A, 홈 폴더. 실습 저장소가 허용하는 버전은 >=3.11,<3.13이다. 시스템 Python이나 Conda 환경 대신 uv가 관리하는 3.12를 쓴다. 의존성 오류가 나더라도 3.13 이상으로 올려서 피하면 안 된다.
Set-Location $HOME
uv python install 3.12
uv python find 3.12
실제 출력(마지막 줄):
C:\Users\<사용자>\AppData\Roaming\uv\python\cpython-3.12-windows-x86_64-none\python.exe0-3. Docker Desktop의 Linux 엔진을 켠다
터미널 A. 3장과 5장에서 kind 클러스터와 파이프라인 이미지를 만들 때 쓴다. Docker Desktop 설정의 Resources에서 메모리를 8GB 이상 주고, WSL 2 기반 엔진을 쓴다. 트레이 아이콘이 Engine running으로 바뀌면 시작한다.
docker version --format "Client {{.Client.Version}} / Server {{.Server.Version}} {{.Server.Os}}/{{.Server.Arch}}"
docker info --format "{{.OSType}} {{.NCPU}} CPU"
실제 출력:
Client 29.3.1 / Server 29.3.1 linux/amd64
linux 16 CPU
Server 정보 없이 dockerDesktopLinuxEngine 연결 오류가 나오면 엔진이 꺼진 상태다. 이대로는 3장과 5장의 클러스터 단계를 진행할 수 없다.
0-4. kind와 kubectl을 준비한다
터미널 A. 클러스터 저장소는 kind v0.27.0에 맞춰 검증했다. 버전이 다르면 노드 이미지와 설치 스크립트가 어긋날 수 있다.
New-Item -ItemType Directory -Path "$HOME\bin" -Force | Out-Null
curl.exe -Lo "$HOME\bin\kind.exe" https://kind.sigs.k8s.io/dl/v0.27.0/kind-windows-amd64
$env:PATH = "$HOME\bin;$env:PATH"
kind version
kubectl version --client
실제 출력:
kind v0.27.0 go1.23.6 windows/amd64
Client Version: v1.34.1
Kustomize Version: v5.7.1$HOME\bin을 Windows 환경 변수 설정에서 사용자 PATH에 넣어 두면 새 터미널마다 다시 지정할 필요가 없다. kubectl은 Docker Desktop 설치 폴더(C:\Program Files\Docker\Docker\resources\bin)에 함께 들어 있다.
0-5. Node.js를 확인한다
터미널 A. 13장의 Promptfoo만 Node.js를 쓴다. 패키지는 실행할 때 npm exec로 받으므로 전역 설치는 하지 않는다.
node --version
npm --version
실제 출력:
v24.12.0
11.6.2
0-6. 디스크, 메모리, 네트워크와 시간을 확보한다
| 항목 | 검증 실행의 값 | 권장 |
|---|---|---|
| 가상환경 4개 | base 0.55GB, tools 0.72GB, bento 0.58GB, vision 1.75GB | uv 캐시를 포함해 10GB 여유 |
실습 이미지 book-labs:ff23b38 | 디스크 1.14GB, 내용 254MB | Docker 디스크 여유 5GB |
kind book-env 클러스터 | KFP, MinIO, MySQL, PostgreSQL, Redis, MLflow | Docker 메모리 8GB, 디스크 40GB |
| 메모리 | 64GB 노트북에서 실행 | 16GB 이상 |
| 시간 | uv 동기화 환경당 10~30초(캐시 있음), 이미지 빌드 약 3분, KFP 실행 약 2분, YOLO 10 epoch 41초(i7-1360P CPU) | 처음 설치는 패키지 다운로드로 수십 분 |
실습 중에 접속하는 곳은 PyPI, GitHub, docker.io, ghcr.io, Ultralytics 자산(yolov8n.pt, Arial.ttf), GroupLens와 npm 레지스트리다. docker.io에서 TLS 시간 초과가 나면 같은 명령을 한 번 더 실행하면 된다. 회사 프록시 뒤라면 HTTPS_PROXY부터 설정한다.
0-7. 선택 자격 증명은 지금 준비하지 않는다
Azure OpenAI나 Gemini 같은 외부 생성 모델, DeepEval의 판정 모델, Langfuse 키는 기본 경로에서 쓰지 않는다. 나중에 연결한다면 키는 현재 터미널의 환경 변수로만 넘기고 저장소나 명령 기록에는 남기지 않는다.
완료 확인
-
git,uv,kind,kubectl,node가 버전을 출력한다. -
uv python find 3.12가 uv 관리 인터프리터를 가리킨다. -
docker version에Server ... linux/amd64가 나온다. - 디스크 여유가 50GB 이상이다(클러스터 포함).
진행 지도
창은 세 가지를 쓴다. A는 명령을 입력하는 작업 터미널이다. B는 API, UI, 포트포워딩처럼 켜 두는 프로세스를 돌리는 서버 터미널이고, 단계가 끝나면 그 창에서 Ctrl+C로 끈다. C는 화면을 확인하는 브라우저다. 서버는 모두 127.0.0.1에만 연다.
| 단계 | 장 | 터미널 | 입력 | 산출물 | 확인 방법 |
|---|---|---|---|---|---|
| 0 | 준비 | A | 설치 명령 | 도구와 Python 3.12 | 각 --version |
| 1 | 1장 | A | 저장소 고정 커밋 | book-env-base 환경 | ml-labs --help |
| 2 | 2장 | A | 없음 | smoke 후보 3개와 보고서 | registered 3개 |
| 3 | 3장 | A, B(포트포워딩), C | ml-platform-book-env | kind book-env, 8080/5000/8888 | bookenv.py status, KFP 화면 |
| 4 | 4장 | A, B(MLflow 5001), C | 합성 평점 | models:/book-movie/1, Feast 저장소 | MLflow 화면, 온라인 조회 |
| 5 | 5장 | A, C | 4장 코드 | 파이프라인 YAML, book-labs:ff23b38, KFP run | KFP 그래프 3개 작업 성공 |
| 6 | 6장 | A, B(8000, 3000), C | 4장 후보 | FastAPI 응답, Bento | Swagger 응답 |
| 7 | 7장 | A | 합성 카드, MovieLens zip | 카드 데이터, MovieLens 변환 | manifest.json |
| 8 | 8장 | A, C | 카드 데이터 | 색상 기준선, YOLO best.pt, 등록 | results.png, MLflow |
| 9 | 9장 | A, C | 새 seed 평점 | 선택 후보, book-movie-selected | 선택 표, MLflow |
| 10 | 10장 | A, B(8000, 8002), C | 선택 후보, YOLO 후보 | 출시 기록, 배치 결과 | release_id, reused, backend |
| 11 | 11장 | A, C | 10장 서버, 평점 | /metrics, drift.html, 통합 증거 | 카운터, 보고서, evidence.json |
| 12 | 12장 | A | 데모 문서 | RAG v1 후보와 출시 저장소 | 인용과 no_grounding |
| 13 | 13장 | A, B(8003), C | v1 후보 | 거절된 후보, v2, 복구, Promptfoo | HTTP release_id 비교, 3 passed |
새 터미널마다 붙여 넣는 머리말
PowerShell 변수와 환경 변수는 창마다 따로 있다. A나 B 터미널을 새로 열면 아래부터 붙여 넣고, 단계마다 지정한 UV_PROJECT_ENVIRONMENT로 바꾼다.
Set-Location $HOME\ml-labs-book\ml-platform-engineering-labs
$W = ".ml-labs\book-01"
$env:UV_PROJECT_ENVIRONMENT = ".ml-labs\book-env-base"
Remove-Item Env:MLFLOW_TRACKING_URI -ErrorAction SilentlyContinueMLFLOW_TRACKING_URI를 지우는 것은 다른 프로젝트에서 설정해 둔 원격 MLflow로 이 실습 기록이 새지 않게 하려는 것이다. 지우고 나면 실습 코드가 정한 로컬 SQLite Tracking DB에 기록한다.
환경을 네 개로 나눈다
책의 원본 경로와 이 독립 구현은 의존성이 다르다. 책 4~5장의 서버용 MLflow는 3.0.0이고 이 가이드는 2.16.2를 쓰므로 한 환경에 섞지 않는다. 대신 같은 소스와 uv.lock에서 extra만 바꿔 환경 네 개를 만든다. extra끼리 충돌하기 때문에 uv sync --all-extras는 쓸 수 없다.
| 환경 경로 | 사용하는 장 | 설치할 extra |
|---|---|---|
.ml-labs\book-env-base | 1, 2, 4, 6, 7, 9, 10, 12, 13장 | dev |
.ml-labs\book-env-tools | 4장 Feast, 5장 KFP, 11장 Evidently | dev, feast, pipeline, monitor |
.ml-labs\book-env-bento | 6장 BentoML | dev, bento |
.ml-labs\book-env-vision | 8장, 10장 YOLO | dev, vision |
1장. 환경과 실행 출처를 준비한다
1장에서는 어떤 Python과 어떤 코드로 실행하는지부터 고정한다. GPU나 클라우드 계정은 아직 필요 없다.
1-1. 실습 저장소를 고정 커밋으로 받는다
터미널 A, 홈 폴더. 가이드의 명령과 출력은 아래 커밋 기준이다. 최신 main에서는 명령이나 출력이 달라질 수 있다.
New-Item -ItemType Directory -Path "$HOME\ml-labs-book" -Force | Out-Null
Set-Location "$HOME\ml-labs-book"
git clone https://github.com/johklo/ml-platform-engineering-labs.git
Set-Location ml-platform-engineering-labs
git checkout --detach ff23b38f88d88268216e2985ff5b6ed0c3defb8c
git rev-parse HEAD
실제 출력(마지막 줄):
ff23b38f88d88268216e2985ff5b6ed0c3defb8c코드를 고치고 싶다면 브랜치를 따로 만들어 커밋으로 남긴다. 그래야 고친 코드의 결과가 원래 커밋의 결과와 섞이지 않는다.
1-2. 기본 환경을 만든다
터미널 A, ml-platform-engineering-labs. 기본 환경은 데이터 준비, 추천, API와 로컬 RAG에 쓴다. --locked는 uv.lock과 다른 버전을 설치하지 못하게 막는다.
$W = ".ml-labs\book-01"
$env:UV_PROJECT_ENVIRONMENT = ".ml-labs\book-env-base"
Remove-Item Env:MLFLOW_TRACKING_URI -ErrorAction SilentlyContinue
uv sync --locked --python 3.12 --extra dev
uv run --locked --extra dev python --version
uv run --locked --extra dev ml-labs --help
실제 출력(캐시가 있는 상태에서 다시 실행):
Resolved 367 packages in 2ms
Checked 86 packages in 33ms
Python 3.12.12
usage: ml-labs [-h]
               {cards,movies,rag,register,serve,smoke,release,batch,exercise,azure,tools}
               ...

Run reproducible local ML platform labs; cloud resources are never created.
처음이라면 패키지를 내려받아 설치하는 줄이 더 나온다. ml-labs를 찾지 못하면 UV_PROJECT_ENVIRONMENT를 지정한 그 창에서 실행했는지 본다.
1-3. 나머지 세 환경을 미리 만든다
터미널 A, 같은 폴더. 장마다 환경을 바꿔 쓰니 한꺼번에 만들어 둔다. 마지막 줄에서 기본 환경으로 돌아온다.
$env:UV_PROJECT_ENVIRONMENT = ".ml-labs\book-env-tools"
uv sync --locked --python 3.12 --extra dev --extra feast --extra pipeline --extra monitor
$env:UV_PROJECT_ENVIRONMENT = ".ml-labs\book-env-bento"
uv sync --locked --python 3.12 --extra dev --extra bento
$env:UV_PROJECT_ENVIRONMENT = ".ml-labs\book-env-vision"
uv sync --locked --python 3.12 --extra dev --extra vision
$env:UV_PROJECT_ENVIRONMENT = ".ml-labs\book-env-base"
Get-ChildItem .ml-labs -Directory -Filter "book-env-*" | Select-Object Name
실제 출력(마지막 명령):
Name
----
book-env-base
book-env-bento
book-env-tools
book-env-vision
uv 캐시가 있을 때 동기화는 base 11초, tools 13초, bento 12초, vision 29초였다. vision은 PyTorch CPU 빌드를 받기 때문에 처음 설치할 때 가장 오래 걸린다.
완료 확인
-
git rev-parse HEAD가ff23b38f...다. -
python --version이Python 3.12.x다. -
.ml-labs아래에book-env-*폴더가 네 개 있다.
2장. 생애주기를 작은 실행으로 확인한다
도구를 하나씩 보기 전에 데이터 준비, 후보 생성, 평가, 등록이 한 번에 이어지는지부터 본다.
2-1. 세 프로젝트를 한 번에 실행한다
터미널 A, 기본 환경. smoke는 카드 탐지 기준선, 영화 추천, 문서 검색 세 프로젝트를 각각 준비부터 등록까지 돌린다. 결과는 $W\smoke 아래에만 쓴다.
uv run --locked --extra dev ml-labs smoke --work "$W\smoke"실제 출력(마이그레이션 로그를 줄이고 앞뒤만 남김):
2026/11/07 20:26:56 INFO mlflow.store.db.utils: Creating initial MLflow database tables...
2026/11/07 20:26:57 INFO mlflow.tracking.fluent: Experiment with name 'ml-platform-labs' does not exist. Creating a new experiment.
Successfully registered model 'ml-labs-cards'.
Created version '1' of model 'ml-labs-cards'.
Successfully registered model 'ml-labs-movies'.
Created version '1' of model 'ml-labs-movies'.
Successfully registered model 'ml-labs-rag'.
Created version '1' of model 'ml-labs-rag'.
{
  "cards": { "task": "cards", "passed": true, ... },
  "movies": { "task": "movies", "passed": true, ... },
  "rag": { "task": "rag", "passed": true, "answer_mode": "extractive_offline", ... },
  "registered": [
    "models:/ml-labs-cards/1",
    "models:/ml-labs-movies/1",
    "models:/ml-labs-rag/1"
  ]
}
Failed to resolve installed pip version 경고는 uv 환경에 pip가 없어서 MLflow가 내는 것이고 결과와는 무관하다. 기존 데이터가 있는 폴더라는 오류가 나오면 지우지 말고 $W = ".ml-labs\book-02"처럼 새 폴더로 다시 시작한다.
2-2. 후보 명세와 평가 보고서를 읽는다
터미널 A. candidate.json은 모델 파일 자체가 아니다. 원천 run, 모델 URI, 데이터 지문을 이어 주는 명세이고, 평가 보고서는 이 후보에 묶인다.
Get-Content "$W\smoke\runs\movies\candidate.json"
Get-ChildItem "$W\smoke" | Select-Object Name
실제 출력(일부):
{
  "task": "movies",
  "run_id": "16fefc79d7094604876f9e5a36d8c924",
  "model_uri": "runs:/16fefc79d7094604876f9e5a36d8c924/model",
  "tracking_uri": "sqlite:///C:/Users/<사용자>/.../.ml-labs/book-01/smoke/tracking/tracking.db",
  "dataset": {
    "dataset": "synthetic-movies",
    "seed": 42,
    "rows": 432,
    "sha256": "6bb44545d72777952854f09ac4c22213a63fc8098cf9f664e690efce5e374910",
    ...
  },
  "metrics": {
    "validation_rmse": 0.4885255171433486,
    "baseline_rmse": 0.730372280846849,
    ...
  },
  "registered_model": "ml-labs-movies",
  "registered_version": "1",
  "registered_alias": "champion",
  "registered_uri": "models:/ml-labs-movies/1"
}

Name
----
data
reports
runs
trackingregistered_uri는 models:/이름/숫자처럼 구체 버전을 포함해야 한다. 별칭 champion만 기록하면 나중에 어떤 버전이었는지 다시 찾을 수 없다.
여기서 카드 모델은 색상 규칙 기준선이고, 문서 응답은 검색한 문장을 인용할 뿐이다. 세 프로젝트가 모두 통과해도 YOLO 학습과 LLM 생성은 아직 남아 있다.
완료 확인
-
registered에 세 모델 URI가 나온다. -
$W\smoke에data,reports,runs,tracking이 생겼다.
3장. 로컬 실행과 클러스터 실행을 구분한다
지금까지는 모두 로컬 Python 프로세스였다. 3장에서는 책 4~5장이 쓰는 플랫폼(KFP, S3 호환 저장소, MLflow, Redis)을 kind 클러스터에 올리고, 5장에서 쓸 접속을 열어 둔다. 전체 Kubeflow와 Notebooks까지 설치하지는 않는다.
3-1. 엔진과 클라이언트를 확인한다
터미널 A. 0-3, 0-4에서 본 도구를 클러스터 작업 직전에 한 번 더 확인한다. 엔진이 중간에 멈추면 이미지 빌드와 KFP 실행이 함께 실패한다.
docker version --format "Client {{.Client.Version}} / Server {{.Server.Version}} {{.Server.Os}}/{{.Server.Arch}}"
kind version
kubectl version --client
실제 출력:
Client 29.3.1 / Server 29.3.1 linux/amd64
kind v0.27.0 go1.23.6 windows/amd64
Client Version: v1.34.1
Kustomize Version: v5.7.1
3-2. 클러스터 저장소를 받고 사전 점검한다
터미널 A, $HOME\ml-labs-book. 클러스터 설치 스크립트는 별도 저장소 ml-platform-book-env에 있다. 표준 라이브러리만 쓰므로 uv의 Python 3.12로 바로 실행한다.
Set-Location "$HOME\ml-labs-book"
git clone https://github.com/johklo/ml-platform-book-env.git
Set-Location ml-platform-book-env
uv run --no-project --python 3.12 python bookenv.py check
실제 출력:
docker   C:\Program Files\Docker\Docker\resources\bin\docker.EXE
kind     C:\Users\<사용자>\...\bin\kind.EXE
kubectl  C:\Program Files\Docker\Docker\resources\bin\kubectl.EXE
git      C:\Program Files\Git\cmd\git.EXE
$ C:\Program Files\Docker\Docker\resources\bin\docker.EXE info --format Docker {{.ServerVersion}}
Docker 29.3.1
All required tools are available.
3-3. 클러스터를 만든다
터미널 A, ml-platform-book-env. kind 클러스터를 만들고 KFP standalone 2.4.1, S3 호환 저장소, PostgreSQL, Redis와 MLflow를 설치한다. 이미지가 캐시돼 있으면 8분 정도, 처음이면 20분 넘게 걸린다.
uv run --no-project --python 3.12 python bookenv.py upThe environment is ready. Next: python bookenv.py forward가 나오면 끝이다. 설치 도중 metadata-grpc-deployment와 ml-pipeline이 몇 번 재시작하는데, MySQL이 늦게 떠서 생기는 일이라 기다리면 된다. 시간 초과가 나면 같은 명령을 다시 실행한다. 기존 클러스터에서 이어서 설치한다. 본문은 같은 스크립트로 미리 만든 book-env 클러스터를 재사용해서 up 출력이 없다.
3-4. 포트포워딩을 켜 둔다
터미널 B, ml-platform-book-env. 클러스터 서비스를 로컬 포트로 연다. 이 창은 5장이 끝날 때까지 열어 둔다. Pod가 재시작되면 스크립트가 터널을 다시 잇는다.
Set-Location "$HOME\ml-labs-book\ml-platform-book-env"
uv run --no-project --python 3.12 python bookenv.py forward| 주소 | 서비스 |
|---|---|
http://127.0.0.1:8080 | KFP UI와 API |
http://127.0.0.1:5000 | 책 실습용 클러스터 MLflow 3.0.0 |
http://127.0.0.1:8888/buckets/ | S3 호환 저장소 화면 |
127.0.0.1:9000, 127.0.0.1:6379 | S3 API, Redis |
5000번은 클러스터 MLflow가 쓰므로 4장의 로컬 MLflow UI는 5001번에서 연다.
3-5. Pod 상태와 KFP 화면을 확인한다
터미널 A, ml-platform-book-env. 클러스터를 만든 직후에는 플랫폼 Pod가 아직 뜨는 중일 수 있어서 상태를 직접 본다.
uv run --no-project --python 3.12 python bookenv.py status실제 출력(다른 실습이 남긴 완료 Pod는 생략):
== kubeflow
NAME                                                READY   STATUS      RESTARTS      AGE
cache-deployer-deployment-67b7ff8785-jvwl9          1/1     Running     0             89m
cache-server-fb5bc88b7-cjz89                        1/1     Running     0             89m
metadata-envoy-deployment-7964b7b586-9nmcn          1/1     Running     0             89m
metadata-grpc-deployment-66b7d897b4-xt9b9           1/1     Running     7 (82m ago)   89m
metadata-writer-76899549df-bqvxx                    1/1     Running     3 (78m ago)   89m
minio-76d4b8f979-bzk5t                              1/1     Running     0             73m
ml-pipeline-794c8cd8b7-z895t                        1/1     Running     7 (77m ago)   89m
ml-pipeline-persistenceagent-68b6c7fddf-zjqt4       1/1     Running     4 (76m ago)   89m
ml-pipeline-scheduledworkflow-7f8667b76b-sgv96      1/1     Running     0             89m
ml-pipeline-ui-649594d7f4-nb58r                     1/1     Running     0             89m
ml-pipeline-viewer-crd-79d4555d8f-tbgzh             1/1     Running     0             89m
ml-pipeline-visualizationserver-6b9c885665-sqptc    1/1     Running     0             89m
mysql-75d57bbfbf-pdfvh                              1/1     Running     0             89m
workflow-controller-5cb6757498-l2vzd                1/1     Running     0             89m

== mlflow
NAME                                READY   STATUS    RESTARTS   AGE
mlflow-deployment-d9f8c7688-7njm8   1/1     Running   0          74m

== postgres
NAME                                           READY   STATUS    RESTARTS   AGE
postgres-release-postgresql-546c65b4db-nbmzd   1/1     Running   0          89m

== redis
NAME                                       READY   STATUS    RESTARTS   AGE
redis-deployment-master-68886f9c8f-mtjxh   1/1     Running   0          89m
브라우저 C. http://127.0.0.1:8080을 연다. 왼쪽에 Pipelines, Experiments, Runs 메뉴가 보이면 KFP UI가 준비된 것이다. 5장의 실행 그래프가 이 화면에 나타난다. 화면이 비어 있으면 ml-pipeline Pod가 Running인지 다시 본다.
책 4~5장의 원본 노트북 실습은 4~5장 환경 설명을 따른다. 이 가이드는 같은 클러스터에서 독립 구현 파이프라인을 돌린다.
완료 확인
-
bookenv.py check가All required tools are available.로 끝난다. -
status의 kubeflow, mlflow, postgres, redis Pod가 모두Running이다. - 터미널 B의 포트포워딩이 켜져 있고
http://127.0.0.1:8080이 열린다.
4장. 실험, 평가와 등록을 연결한다
책은 이 장에서 소득 분류 모델을 다룬다. 여기서는 작은 추천 데이터로 같은 일을 한다. 실험을 기록하고, 평가를 통과한 후보만 등록하고, 피처를 시점에 맞게 꺼내는 일이다. 소득 분류 원본은 4~5장 실행 참조에 따로 정리했다.
4-1. 평점 데이터를 준비한다
터미널 A, ml-platform-engineering-labs, 기본 환경. 사용자 48명과 영화 32편의 합성 평점을 만들고 사용자별 시간순으로 학습, 검증, 테스트를 나눈다.
$W = ".ml-labs\book-01"
$env:UV_PROJECT_ENVIRONMENT = ".ml-labs\book-env-base"
uv run --locked --extra dev ml-labs movies prepare --output "$W\data\movies"
실제 출력:
{
  "result": ".ml-labs\\book-01\\data\\movies"
}
4-2. 학습하고 MLflow에 기록한다
터미널 A. rank 4 SVD 추천 모델을 학습하고 파라미터, 검증 지표와 모델을 같은 run에 남긴다.
uv run --locked --extra dev ml-labs movies train --data "$W\data\movies" --output "$W\runs\movies" --work "$W\tracking" --rank 4실제 출력(마이그레이션 로그 생략):
2026/11/07 20:29:01 INFO mlflow.store.db.utils: Creating initial MLflow database tables...
2026/11/07 20:29:03 INFO mlflow.tracking.fluent: Experiment with name 'ml-platform-labs' does not exist. Creating a new experiment.
{
  "result": ".ml-labs\\book-01\\runs\\movies\\candidate.json"
}
4-3. 평가를 통과한 후보만 등록한다
터미널 A. 평가는 검증 RMSE와 인기 기준선 대비 순위 지표를 먼저 보고, 통과해야 테스트 분할을 연다. 등록에는 통과 보고서가 필요하다.
uv run --locked --extra dev ml-labs movies evaluate --candidate "$W\runs\movies\candidate.json" --data "$W\data\movies" --report "$W\reports\movies.json"
$LASTEXITCODE
uv run --locked --extra dev ml-labs register --candidate "$W\runs\movies\candidate.json" --report "$W\reports\movies.json" --name book-movie
(Get-Content "$W\runs\movies\candidate.json" -Raw | ConvertFrom-Json).registered_uri
실제 출력(평가 결과는 판정 부분만 남김):
{
  "result": {
    "task": "movies",
    "passed": true,
    "max_validation_rmse": 1.5,
    ...
    "observed_validation_rmse": 0.6722079292983877,
    "ranking_gate": {
      "min_ndcg_lift": null,
      "observed_lift": 0.32112089644232705,
      "passed": true
    },
    "test_policy": "Test split was scored only after the validation gate."
  }
}
0
Successfully registered model 'book-movie'.
Created version '1' of model 'book-movie'.
models:/book-movie/1$LASTEXITCODE가 0이 아니면 등록으로 넘어가지 않는다.
4-4. MLflow 화면에서 run과 등록 모델을 확인한다
터미널 B, 기본 환경. 로컬 Tracking DB를 읽는 MLflow UI를 5001번에 띄운다. 5000번은 3장의 클러스터 MLflow다.
Set-Location $HOME\ml-labs-book\ml-platform-engineering-labs
$W = ".ml-labs\book-01"
$env:UV_PROJECT_ENVIRONMENT = ".ml-labs\book-env-base"
$db = (Resolve-Path "$W\tracking\tracking.db").Path.Replace('\', '/')
uv run --locked --extra dev mlflow ui --backend-store-uri "sqlite:///$db" --host 127.0.0.1 --port 5001
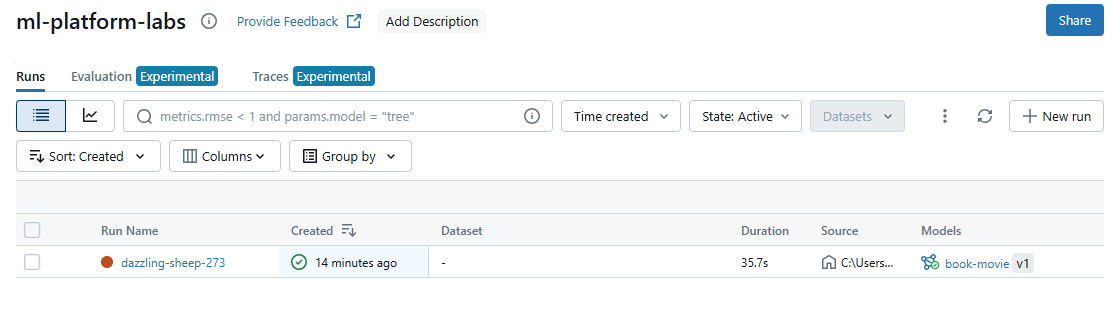
브라우저 C. http://127.0.0.1:5001에서 Experiments의 ml-platform-labs를 연다. run 하나가 있고 Models 열에 book-movie v1이 붙어 있다.
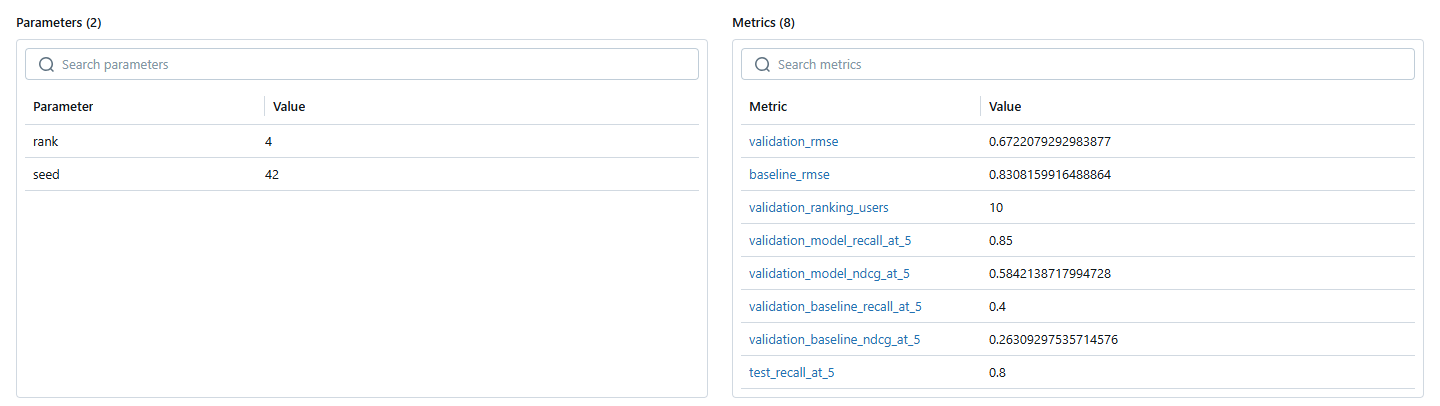
run 이름을 누르고 Overview 아래로 내리면 파라미터 rank=4, seed=42와 검증 지표가 보인다. test_recall_at_5는 평가가 통과한 뒤에만 기록된다.
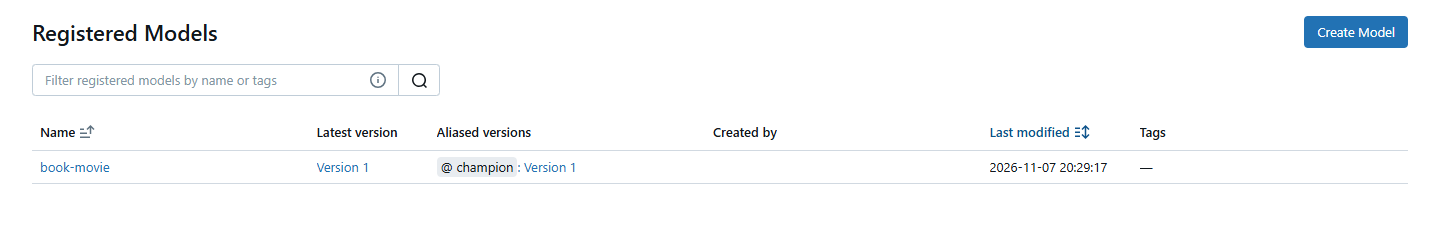
상단 Models 메뉴에서 등록 모델과 별칭을 확인한다. 처음 열 때 새 Model Registry UI 안내 창이 뜨면 닫는다.
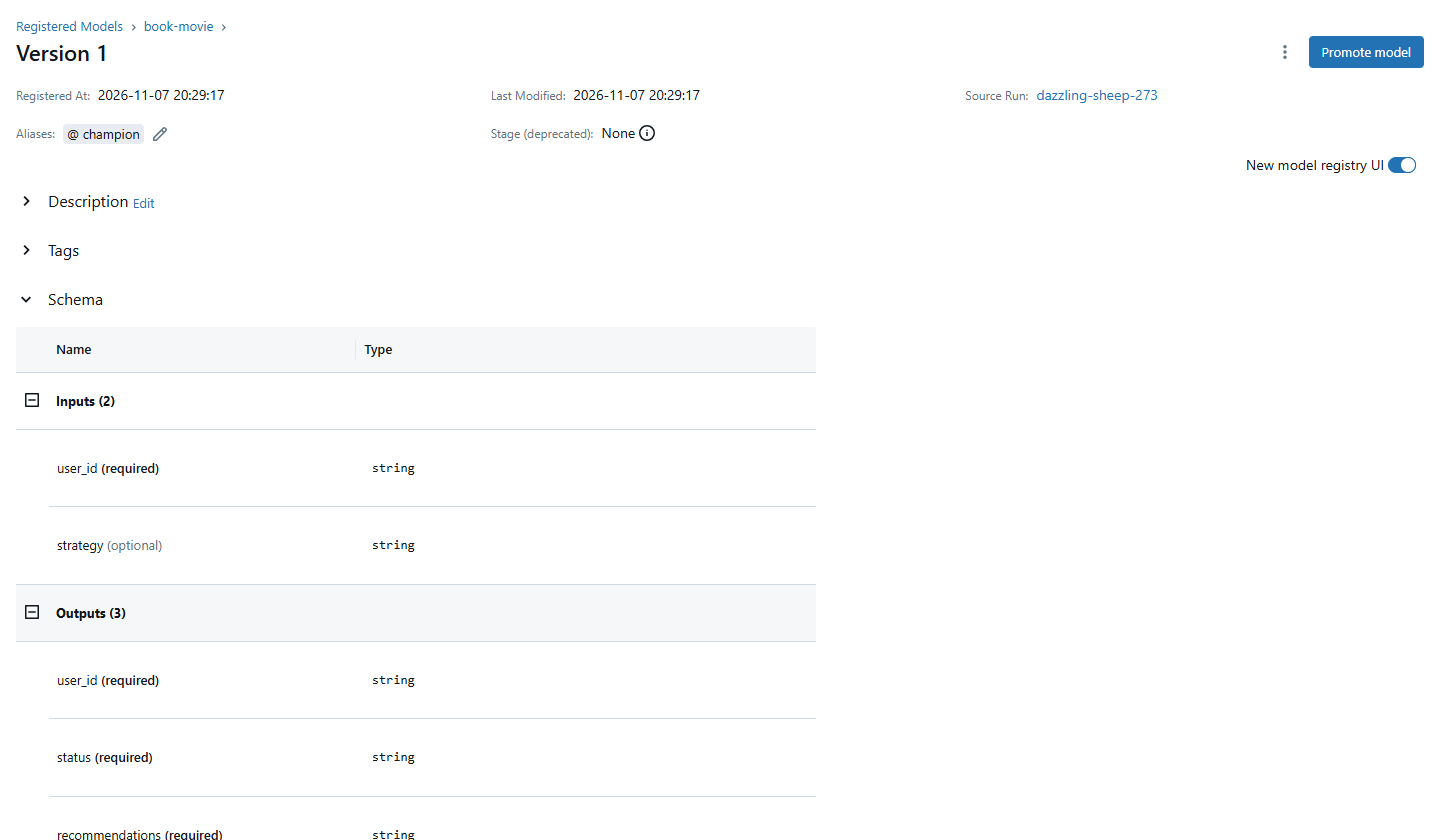
Version 1을 누르면 원천 run과 입력, 출력 스키마가 보인다. 서빙 API가 지켜야 할 계약이 이 스키마다.
SQLite에는 메타데이터만 있고 모델 파일은 아티팩트 폴더($W\tracking)에 따로 있다. DB만 복사하면 모델은 따라오지 않는다. UI는 9장까지 켜 두고 필요할 때 새로고침하면 된다.
4-5. 평가를 일부러 실패시킨다
터미널 A, 기본 환경. RMSE 기준을 0.01로 낮춰 일부러 거절되게 만든다. 거절 보고서는 다른 파일에 써서 정상 보고서를 덮지 않는다.
uv run --locked --extra dev ml-labs movies evaluate --candidate "$W\runs\movies\candidate.json" --data "$W\data\movies" --report "$W\reports\movies-rejected.json" --max-rmse 0.01
$LASTEXITCODE
uv run --locked --extra dev ml-labs register --candidate "$W\runs\movies\candidate.json" --report "$W\reports\movies-rejected.json" --name must-not-register
$LASTEXITCODE
실제 출력:
ml-labs: error: Model validation gate rejected candidate; report: .ml-labs\book-01\reports\movies-rejected.json
2
ml-labs: error: Registry promotion requires a passing movies evaluation report.
2
평가와 등록이 둘 다 종료 코드 2로 실패하면 맞게 된 것이다. 다만 이 거절 평가는 같은 run의 validation_passed 태그를 false로 바꾸고, evaluation/validation.json도 거절 보고서로 덮는다. 이미 등록한 book-movie 버전 1은 그대로다. run 태그는 마지막 평가만 보여 주므로 출시 판단은 보고서 파일과 등록 버전을 기준으로 한다.
4-6. Feast로 정의를 등록하고 과거 시점을 조회한다
터미널 A, tools 환경. 같은 평점에서 사용자 피처(평균 평점, 평점 수)를 만들고 실제 Feast 저장소에 정의를 등록한다. Feast는 UI 없이 CLI 출력으로 확인한다.
$env:UV_PROJECT_ENVIRONMENT = ".ml-labs\book-env-tools"
uv run --locked --extra feast ml-labs tools feast init --data "$W\data\movies" --output "$W\feast"
uv run --locked --extra feast ml-labs tools feast run --repo "$W\feast" --action apply
uv run --locked --extra feast ml-labs tools feast run --repo "$W\feast" --action historical --user-id u007
실제 출력(경고 줄을 줄임):
Uninstalled 1 package in 17ms
Installed 1 package in 48ms
{
  "repo": ".ml-labs\\book-01\\feast"
}
WARNING:root:Cannot use sqlite_vec for vector search
{
  "action": "apply",
  "dataset_sha256": "9acf3ae528740f8e99f986e3eba5e69377ab04fcdeef77f351338415e8aa5f1b",
  "status": "applied"
}
{
  "action": "historical",
  "user_id": "u007",
  "rows": [
    { "event_timestamp": "2024-12-31T00:00:00+00:00", "average_rating": null, "ratings_count": null,
      "returned_by_feast": false, "point_in_time_correct": true },
    { "event_timestamp": "2025-01-01T00:00:00+00:00", "average_rating": 2.240000009536743, "ratings_count": 1,
      "returned_by_feast": true, "point_in_time_correct": true },
    { "event_timestamp": "2025-01-08T12:00:00+00:00", "average_rating": 2.40625, "ratings_count": 8,
      "returned_by_feast": true, "point_in_time_correct": true },
    { "event_timestamp": "2025-02-13T00:00:00+00:00", "average_rating": 2.780428647994995, "ratings_count": 14,
      "returned_by_feast": true, "point_in_time_correct": true }
  ]
}
맨 앞의 Uninstalled 1 package, Installed 1 package는 uv가 이 extra 조합에 맞춰 패키지 하나를 바꿔 끼운 기록이다. 과거 조회는 각 시점까지 관찰된 값만 돌아온다. 첫 평점 이전에는 값이 비어 있고, 그 뒤로는 그때까지의 평균과 개수만 나온다. point_in_time_correct는 Feast 결과를 직접 계산한 기대값과 맞춰 본 결과다.
4-7. 온라인 조회는 적재 전에 실패하고 적재 후에 성공한다
터미널 A, tools 환경. 정의 등록과 값 적재는 다른 작업이다. 온라인 저장소는 materialize가 채운다.
uv run --locked --extra feast ml-labs tools feast run --repo "$W\feast" --action online --user-id u007
$LASTEXITCODE
uv run --locked --extra feast ml-labs tools feast run --repo "$W\feast" --action materialize
uv run --locked --extra feast ml-labs tools feast run --repo "$W\feast" --action online --user-id u007
실제 출력(경고 줄을 줄임):
ml-labs: error: No online features for 'u007'. Run `ml-labs tools feast run --action apply` and `--action materialize` first (the online store is filled only by materialization).
2
Materializing 1 feature views from 2025-01-01 08:59:59+09:00 to 2025-01-14 09:00:01+09:00 into the sqlite online store.

user_movie_stats:
100%|█████████████████████████████████████████████████████████████| 48/48 [00:00<00:00, 1981.87it/s]
{
  "action": "materialize",
  "status": "materialized",
  "start": "2024-12-31T23:59:59+00:00",
  "end": "2025-01-14T00:00:01+00:00"
}
{
  "action": "online",
  "user_id": "u007",
  "features": {
    "user_id": ["u007"],
    "average_rating": [2.780428647994995],
    "observed_at_unix": [1736812800],
    "ratings_count": [14]
  }
}
적재한 뒤에는 학습 평점으로 계산한 최신 피처가 나온다. 여기서 쓴 Online store는 Feast의 SQLite 구현이다. 책의 Redis 온라인 저장소는 4~5장 실습 기록에서 다룬다.
완료 확인
-
registered_uri가models:/book-movie/1이다. - MLflow 화면에서 run, 지표와 등록 버전이 보인다.
- 거절 평가와
must-not-register등록이 모두 종료 코드 2로 실패한다. - 온라인 조회가 materialize 전에는 실패하고 뒤에는
ratings_count14를 돌려준다.
5장. 컴포넌트를 연결하고 클러스터에서 실행한다
4장에서 하나씩 실행한 준비, 학습, 평가를 KFP 컴포넌트로 묶는다. 로컬에서 컴파일과 컴포넌트 본문을 확인한 뒤, 실습 이미지를 만들어 3장의 클러스터에서 Pod로 돌린다. 막힌 곳은 컴파일이 아니라 제출 단계였다(5-5).
5-1. 파이프라인을 컴파일하고 YAML을 읽는다
터미널 A, ml-platform-engineering-labs, tools 환경. 이미지를 지정하지 않으면 자리표시자 이미지가 들어간다. 구조를 읽어 보는 용도라 이 YAML은 제출하지 않는다.
$W = ".ml-labs\book-01"
$env:UV_PROJECT_ENVIRONMENT = ".ml-labs\book-env-tools"
$revision = git rev-parse HEAD
uv run --locked --extra pipeline ml-labs tools kfp compile --source-revision $revision --output "$W\kfp\movie-pipeline.yaml"
Get-Content "$W\kfp\movie-pipeline.yaml" -TotalCount 12
실제 출력:
{
  "output": ".ml-labs\\book-01\\kfp\\movie-pipeline.yaml",
  "image": "SET-YOUR-REGISTRY/ml-platform-engineering-labs:SET-IMAGE-TAG",
  "source_revision": "ff23b38f88d88268216e2985ff5b6ed0c3defb8c",
  "image_is_placeholder": true,
  "submitted": false,
  "warning": "Image is a placeholder; build/push the repo Dockerfile and recompile with --image <registry>/<name>@sha256:<digest> before submitting."
}
# PIPELINE DEFINITION
# Name: ml-labs-movie-recommender
# Description: Synthetic movie data -> SVD recommender (MLflow) -> gated holdout evaluation
# Inputs:
#    items: int [Default: 32.0]
#    max_rmse: float [Default: 1.5]
#    mlflow_root: str [Default: '/workspace/mlflow']
#    rank: int [Default: 4.0]
#    seed: int [Default: 42.0]
#    source_revision: str [Default: 'ff23b38f88d88268216e2985ff5b6ed0c3defb8c']
#    users: int [Default: 48.0]
components:
YAML 아래쪽 root.dag.tasks에서 작업 사이의 연결을 볼 수 있다. 평가 작업은 준비 작업의 dataset과 학습 작업의 model을 입력 아티팩트로 받는다.
      evaluate-movie-recommender:
        dependentTasks:
        - prepare-movie-data
        - train-movie-recommender
        inputs:
          artifacts:
            dataset:
              taskOutputArtifact:
                outputArtifactKey: dataset
                producerTask: prepare-movie-data
            model:
              taskOutputArtifact:
                outputArtifactKey: model
                producerTask: train-movie-recommender
        taskInfo:
          name: evaluate-holdout
5-2. 컴포넌트 본문을 로컬에서 실행한다
터미널 A, tools 환경. 같은 컴포넌트 함수를 로컬 프로세스에서 호출해 데이터, MLflow 모델 묶음과 평가 파일이 이어지는지 본다. Pod는 아직 띄우지 않는다.
uv run --locked --extra dev --extra pipeline pytest -q -p no:warnings tests\test_optional_integrations.py -k "native_kfp or kfp_component_bodies"실제 출력:
Uninstalled 1 package in 15ms
Installed 1 package in 34ms
..                                                                       [100%]
2 passed, 8 deselected in 6.31s
5-3. 실습 이미지를 만든다
터미널 A, ml-platform-engineering-labs. 저장소의 Dockerfile은 uv.lock의 core와 pipeline 의존성, ml_labs 패키지를 Python 3.12.12 이미지에 설치한다. 커밋을 빌드 인자로 넘겨 이미지 라벨과 실행 환경 변수에 남긴다.
$revision = git rev-parse HEAD
docker build --platform linux/amd64 --build-arg SOURCE_REVISION=$revision -t book-labs:ff23b38 .
docker images book-labs
실제 출력(빌드 로그 마지막 부분):
#14 [stage-0 8/9] RUN uv pip install --system --no-cache --no-deps .     && python -c "import kfp, ml_labs.movies, ml_labs.data; print('ml_labs image ready')"
#14 1.693 ml_labs image ready
#14 DONE 10.1s
#16 naming to docker.io/library/book-labs:ff23b38 0.0s done
#16 unpacking to docker.io/library/book-labs:ff23b38 5.7s done
#16 DONE 26.8s
IMAGE               ID             DISK USAGE   CONTENT SIZE   EXTRA
book-labs:ff23b38   03760880abcd       1.14GB          254MB
의존성 설치 단계에서 약 2분이 걸린다. 베이스 이미지 python:3.12.12-slim-bookworm이나 ghcr.io/astral-sh/uv:0.12.3을 받다가 TLS 시간 초과가 나면 다시 실행한다.
5-4. 이미지를 kind 노드에 넣는다
터미널 A. kind 노드는 로컬 Docker 이미지를 직접 보지 못한다. 레지스트리에 push하지 않고 노드의 containerd에 복사한다.
kind load docker-image book-labs:ff23b38 --name book-env
docker exec book-env-control-plane crictl images | Select-String "book-labs|IMAGE"
실제 출력:
Image: "book-labs:ff23b38" with ID "sha256:03760880abcd5266131afd12415e007bf1274fa0d0914f925060d539fdedc062" not yet present on node "book-env-control-plane", loading...
IMAGE                                                TAG                          IMAGE ID            SIZE
docker.io/library/book-labs                          ff23b38                      20096132a8c97       254MB
content digest ... not found 오류가 나오면 Docker Desktop의 containerd 이미지 저장소와 kind의 가져오기 방식이 맞지 않는 경우다. 이때는 압축 파일을 거쳐 넣는다.
docker save book-labs:ff23b38 -o "$W\book-labs.tar"
kind load image-archive "$W\book-labs.tar" --name book-env
태그가 latest가 아니므로 Pod의 imagePullPolicy는 IfNotPresent가 되고 노드에 넣은 이미지를 그대로 쓴다.
5-5. 실제 이미지로 다시 컴파일하고 KFP 2.4.1에 맞춘다
터미널 A, tools 환경. 같은 파이프라인을 실습 이미지로 컴파일한다.
uv run --locked --extra pipeline ml-labs tools kfp compile --source-revision $revision --image book-labs:ff23b38 --output "$W\kfp\movie-pipeline-cluster.yaml"
Select-String -Path "$W\kfp\movie-pipeline-cluster.yaml" -Pattern "image:"
실제 출력:
{
  "output": ".ml-labs\\book-01\\kfp\\movie-pipeline-cluster.yaml",
  "image": "book-labs:ff23b38",
  "source_revision": "ff23b38f88d88268216e2985ff5b6ed0c3defb8c",
  "image_is_placeholder": false,
  "submitted": false
}
.ml-labs\book-01\kfp\movie-pipeline-cluster.yaml:133:        image: book-labs:ff23b38
.ml-labs\book-01\kfp\movie-pipeline-cluster.yaml:163:        image: book-labs:ff23b38
.ml-labs\book-01\kfp\movie-pipeline-cluster.yaml:204:        image: book-labs:ff23b38
이 YAML을 그대로 3장의 KFP 2.4.1 백엔드에 제출하면 준비와 학습은 성공하는데 평가 작업의 driver가 시작하지 못하고 run이 FAILED로 끝난다. 원인은 이름이었다. 실습 코드는 학습과 평가 작업에 표시 이름(train-svd-recommender, evaluate-holdout)을 붙인다. 그런데 KFP 2.4.1의 driver는 상위 작업의 아티팩트를 표시 이름으로 찾다가 YAML의 작업 키(train-movie-recommender)와 맞지 않아 멈춘다. driver 로그는 다음과 같다.
panic: runtime error: invalid memory address or nil pointer dereference
github.com/kubeflow/pipelines/backend/src/v2/driver.resolveUpstreamArtifacts(...)
	/go/src/github.com/kubeflow/pipelines/backend/src/v2/driver/driver.go:1519 +0x4b9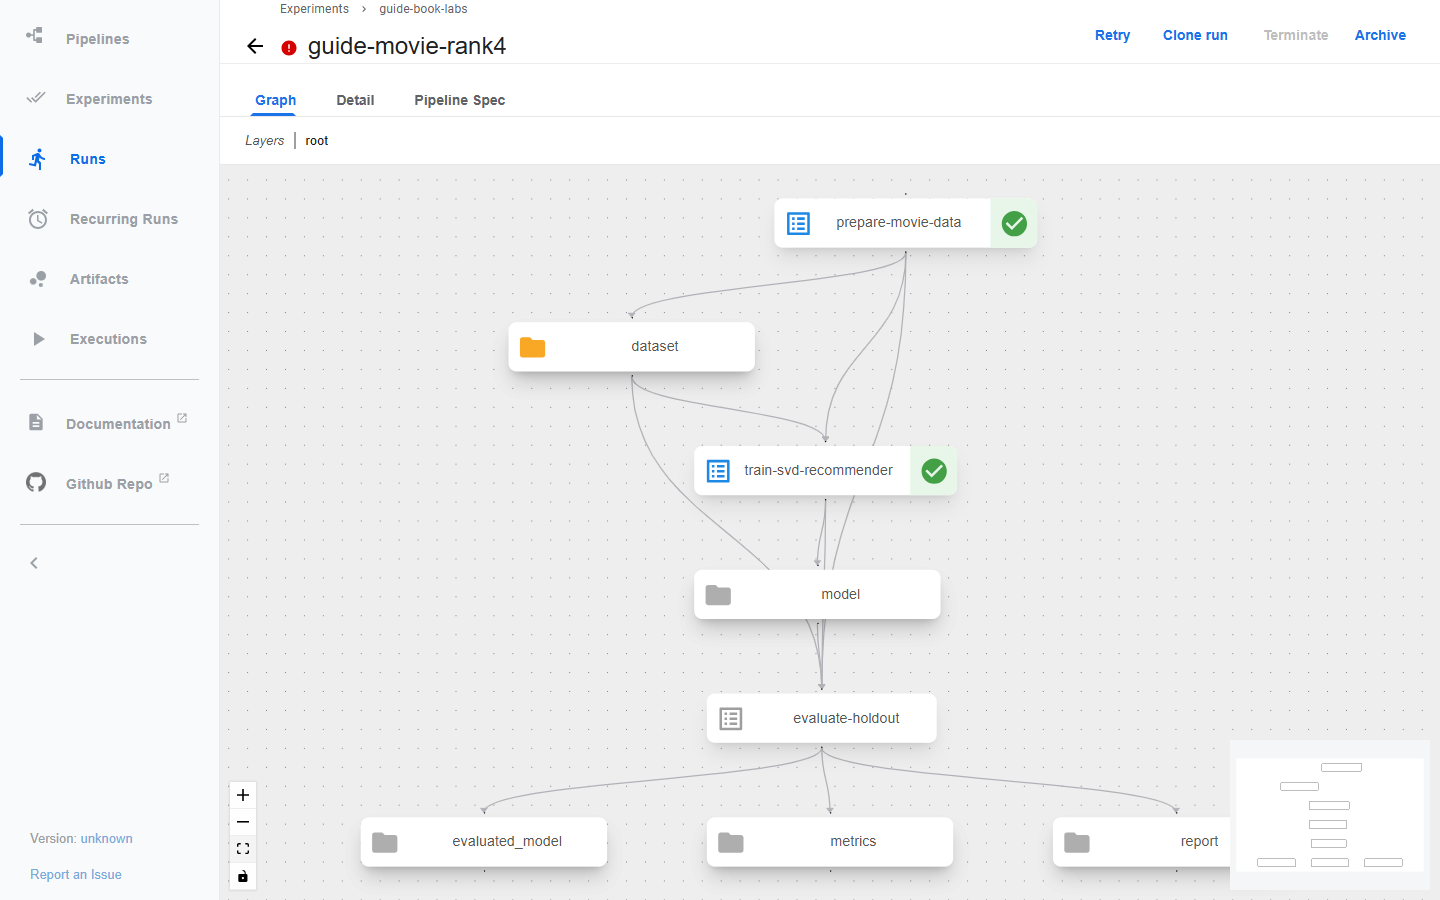
소스는 고치지 않고 제출용 YAML에서만 표시 이름을 작업 키와 같게 바꾼다.
uv run --locked --extra pipeline python -c "import sys,yaml; d=yaml.safe_load(open(sys.argv[1],encoding='utf-8')); [t['taskInfo'].update(name=k) for k,t in d['root']['dag']['tasks'].items()]; yaml.safe_dump(d,open(sys.argv[2],'w',encoding='utf-8'),sort_keys=False); print({k:t['taskInfo']['name'] for k,t in d['root']['dag']['tasks'].items()})" "$W\kfp\movie-pipeline-cluster.yaml" "$W\kfp\movie-pipeline-kfp24.yaml"실제 출력:
{'evaluate-movie-recommender': 'evaluate-movie-recommender', 'prepare-movie-data': 'prepare-movie-data', 'train-movie-recommender': 'train-movie-recommender'}5-6. KFP에 제출하고 완료까지 기다린다
터미널 A, tools 환경, 3장의 포트포워딩이 켜진 상태. 로컬 KFP standalone에는 인증이 없어서 http://127.0.0.1:8080에 바로 제출한다. 인증을 거는 클러스터라면 주소와 방식이 달라진다.
uv run --locked --extra pipeline python -c "import sys,kfp; c=kfp.Client(host='http://127.0.0.1:8080'); run=c.create_run_from_pipeline_package(sys.argv[1],arguments={'rank':4},experiment_name='guide-book-labs',run_name='guide-movie-rank4',enable_caching=False); r=c.wait_for_run_completion(run.run_id,timeout=900); print(run.run_id, r.state); [print(t.display_name, t.state) for t in r.run_details.task_details if t.display_name in ('prepare-movie-data','train-movie-recommender','evaluate-movie-recommender')]" "$W\kfp\movie-pipeline-kfp24.yaml"실제 출력(FutureWarning 줄 생략):
Experiment details: http://127.0.0.1:8080/#/experiments/details/652161b2-4c8f-47b7-a416-cb78409f5f44
Run details: http://127.0.0.1:8080/#/runs/details/917f69c6-a703-4720-a3f6-b8dd6a04c2a9
917f69c6-a703-4720-a3f6-b8dd6a04c2a9 SUCCEEDED
prepare-movie-data SUCCEEDED
train-movie-recommender SUCCEEDED
evaluate-movie-recommender SUCCEEDED
제출부터 완료까지 약 1분 50초가 걸렸다. 컴포넌트마다 Pod 안의 /workspace/mlflow에 임시 SQLite MLflow를 만들고, 그 폴더를 통째로 KFP 아티팩트(클러스터 MinIO)에 실어 다음 작업으로 넘긴다. 그래서 3장의 클러스터 MLflow(5000번)에는 아무것도 남지 않는다. 그쪽에 기록하려면 컴포넌트가 서비스 주소와 S3 자격 증명을 받도록 따로 구성해야 하는데, 이 판에는 그 부분이 없다.
5-7. KFP 화면에서 그래프, 지표와 로그를 확인한다
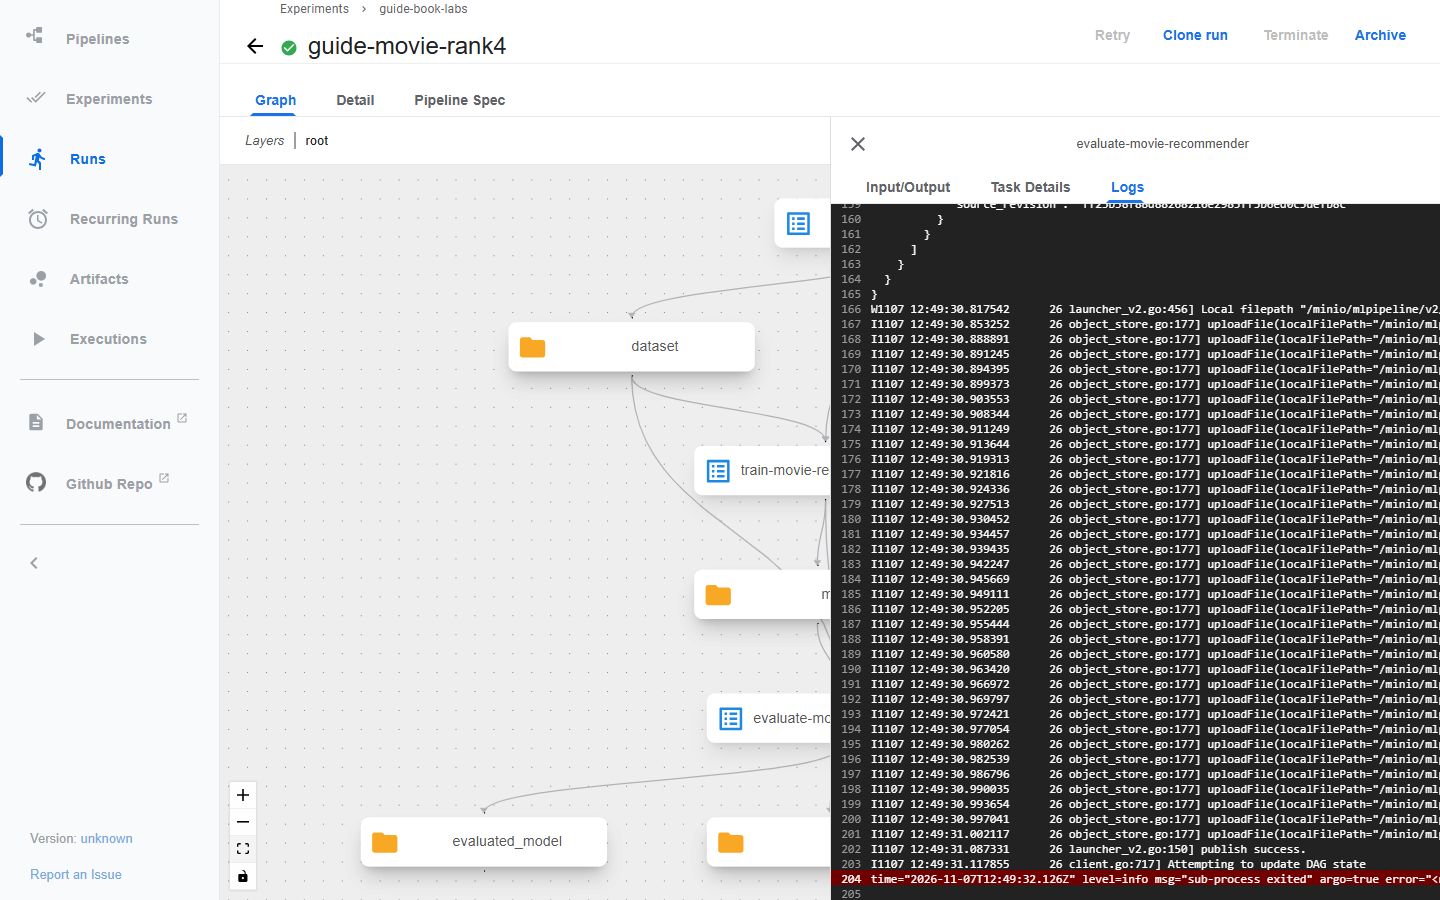
브라우저 C. 출력의 Run details 주소를 연다. 세 작업과 그 사이의 아티팩트가 그래프로 보이고, 세 작업 모두 성공 표시가 붙는다.
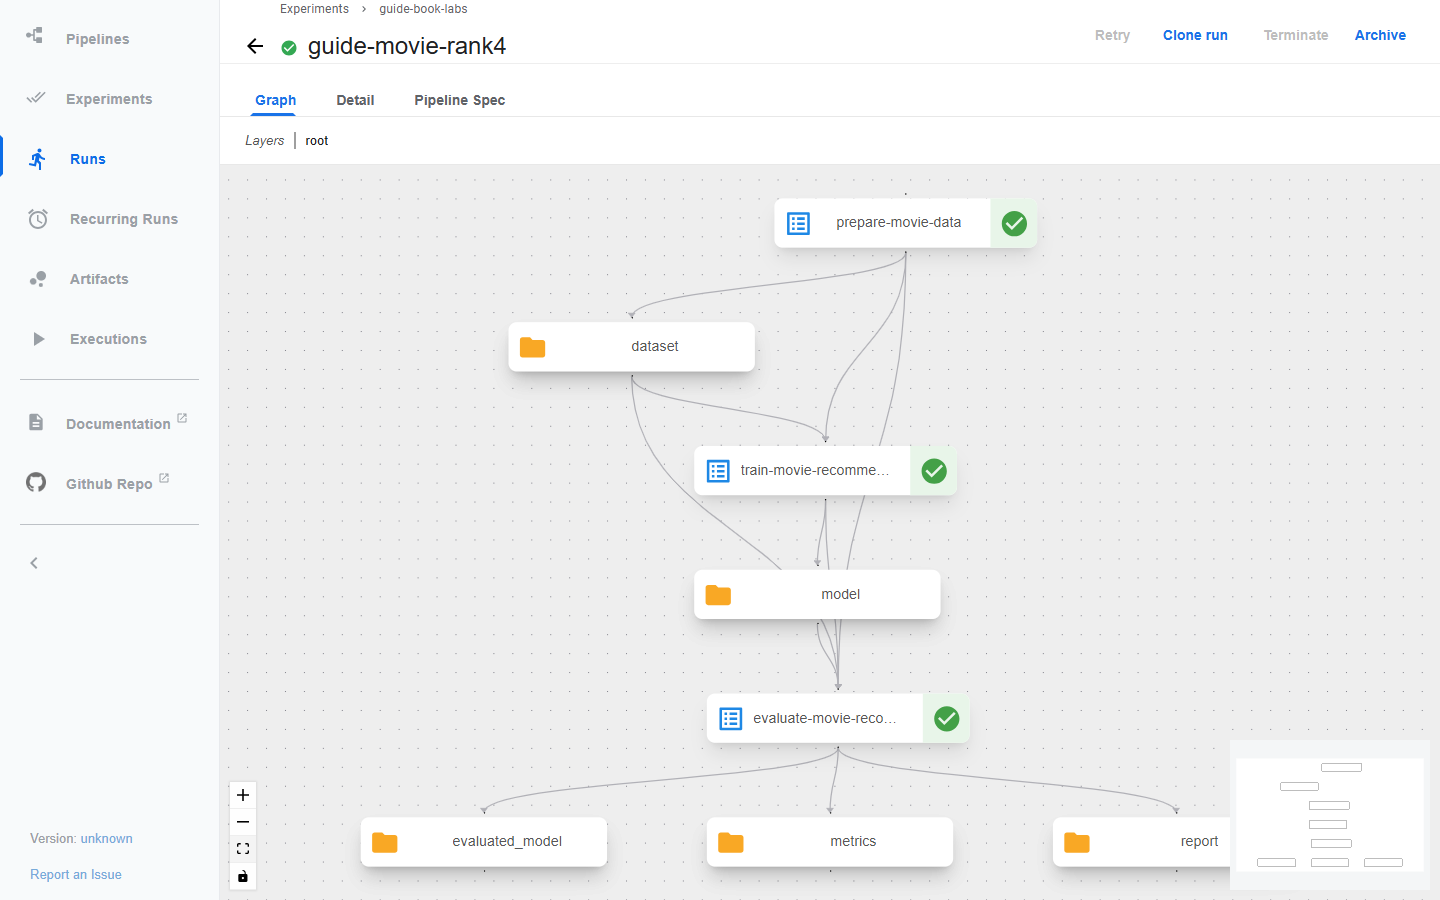
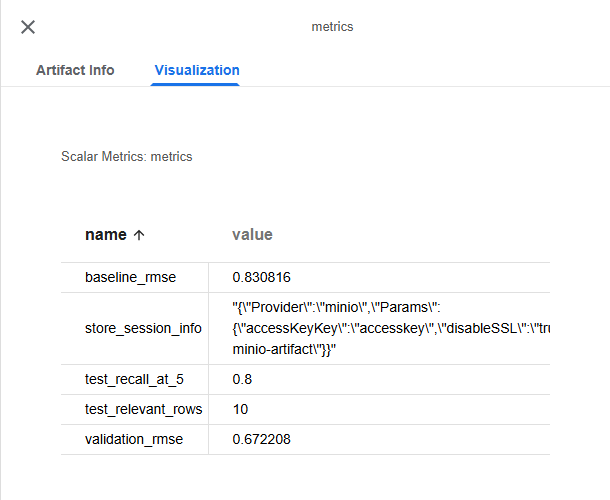
metrics 아티팩트를 누르고 Visualization 탭을 열면 평가 컴포넌트가 남긴 스칼라 지표가 보인다. seed와 rank가 4장과 같아서 validation_rmse 0.672208, test_recall_at_5 0.8까지 로컬 실행과 똑같다.
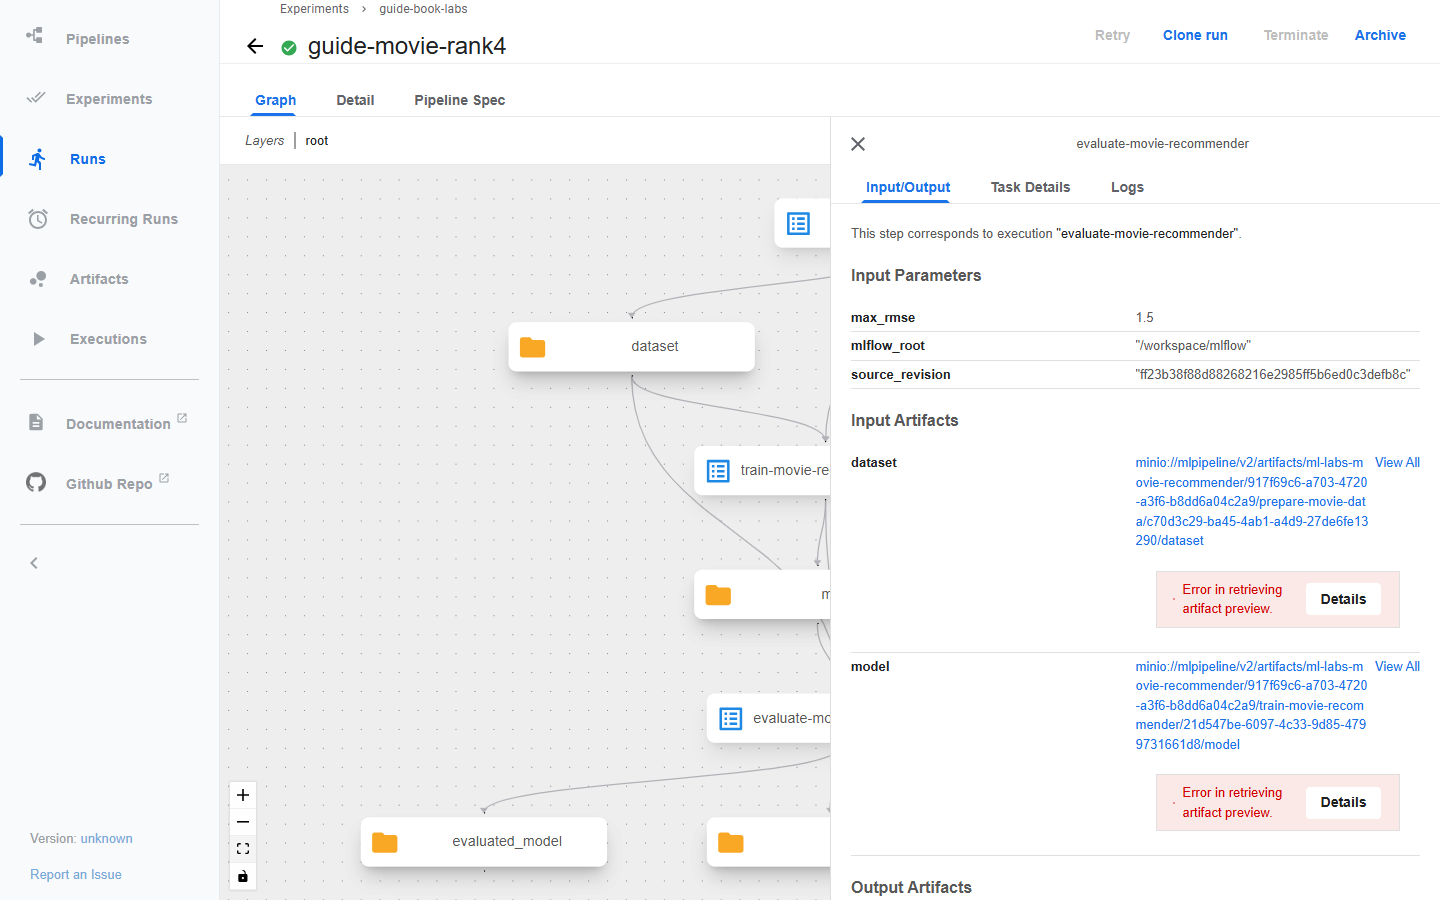
평가 작업을 누르고 Input/Output 탭을 보면 입력 파라미터와 상위 작업의 아티팩트 위치가 보인다. 폴더 형태 아티팩트는 미리보기에 Error in retrieving artifact preview가 뜬다. 파일이 아니라 디렉터리라서 미리보기를 못 할 뿐이고 실행은 성공했다.
Logs 탭의 마지막 줄들은 평가 결과와 MLflow 묶음을 MinIO에 올린 뒤 publish success로 끝난다.
터미널에서는 Pod 목록으로 확인한다.
kubectl --context kind-book-env -n kubeflow get pods | Select-String "ml-labs-movie-recommender"실패했다면 원인을 이미지 빌드 실패, ErrImagePull(노드에 이미지 없음), driver 실패(5-5의 표시 이름), 저장소 연결 오류로 나눠 본다. 컴파일 성공은 YAML이 만들어졌다는 뜻이고, 실행 결과는 KFP 화면에서 따로 확인한다.
완료 확인
- 로컬 컴포넌트 검사 2개가 통과한다.
-
crictl images에book-labs:ff23b38이 보인다. - KFP run이
SUCCEEDED이고 세 작업이 모두 성공했다.
6장. 등록 모델을 HTTP와 BentoML로 사용한다
4장에서 등록한 추천 모델 버전 1을 두 가지 방식으로 서빙한다. FastAPI 서버는 후보 명세를 읽어 등록 버전을 고정한다. BentoML은 같은 MLflow 모델을 자기 모델 저장소로 가져와 서비스로 묶는다.
6-1. 추천 API 서버를 켠다
터미널 B, ml-platform-engineering-labs, 기본 환경. 서버는 켜 둔다.
Set-Location $HOME\ml-labs-book\ml-platform-engineering-labs
$W = ".ml-labs\book-01"
$env:UV_PROJECT_ENVIRONMENT = ".ml-labs\book-env-base"
Remove-Item Env:MLFLOW_TRACKING_URI -ErrorAction SilentlyContinue
uv run --locked --extra dev ml-labs serve --movies "$W\runs\movies\candidate.json" --host 127.0.0.1 --port 8000
Uvicorn running on http://127.0.0.1:8000이 나오면 준비된 것이다.
6-2. 기존 사용자와 처음 보는 사용자를 비교한다
터미널 A. ConvertTo-Json을 붙이면 중첩된 추천 목록까지 그대로 보인다.
Invoke-RestMethod http://127.0.0.1:8000/health | ConvertTo-Json -Depth 6
$body = @{ user_id = "u000" } | ConvertTo-Json
Invoke-RestMethod http://127.0.0.1:8000/recommend -Method Post -ContentType application/json -Body $body | ConvertTo-Json -Depth 6
$body = @{ user_id = "new-user" } | ConvertTo-Json
Invoke-RestMethod http://127.0.0.1:8000/recommend -Method Post -ContentType application/json -Body $body | ConvertTo-Json -Depth 6
실제 출력(추천 목록은 처음 두 개만 남김):
{
  "status": "ok",
  "models": { "cards": false, "movies": true, "rag": false },
  "movie_release_id": null,
  "feast_enabled": false,
  "rag_release_configured": false
}
{
  "user_id": "u000",
  "status": "personalized",
  "recommendations": [
    { "item_id": "m025", "score": 3.972719144406785 },
    { "item_id": "m022", "score": 3.758731167815679 },
    ...
  ],
  "feature_routing": null,
  "model_uri": "models:/book-movie/1",
  "release_id": null
}
{
  "user_id": "new-user",
  "status": "cold_start_popularity",
  "recommendations": [
    { "item_id": "m031", "score": 3.3113125 },
    { "item_id": "m025", "score": 3.2506818181818176 },
    ...
  ],
  "feature_routing": null,
  "model_uri": "models:/book-movie/1",
  "release_id": null
}
학습에 있던 사용자는 personalized, 처음 보는 사용자는 인기 기준선인 cold_start_popularity로 응답한다. 두 응답 모두 model_uri에 구체 버전이 들어 있다.
6-3. Swagger 화면에서 같은 요청을 보낸다
브라우저 C. http://127.0.0.1:8000/docs를 열고 POST /recommend를 펼친 뒤 Try it out을 누른다. 요청 본문에 {"user_id": "u000"}을 넣고 Execute를 누른다.
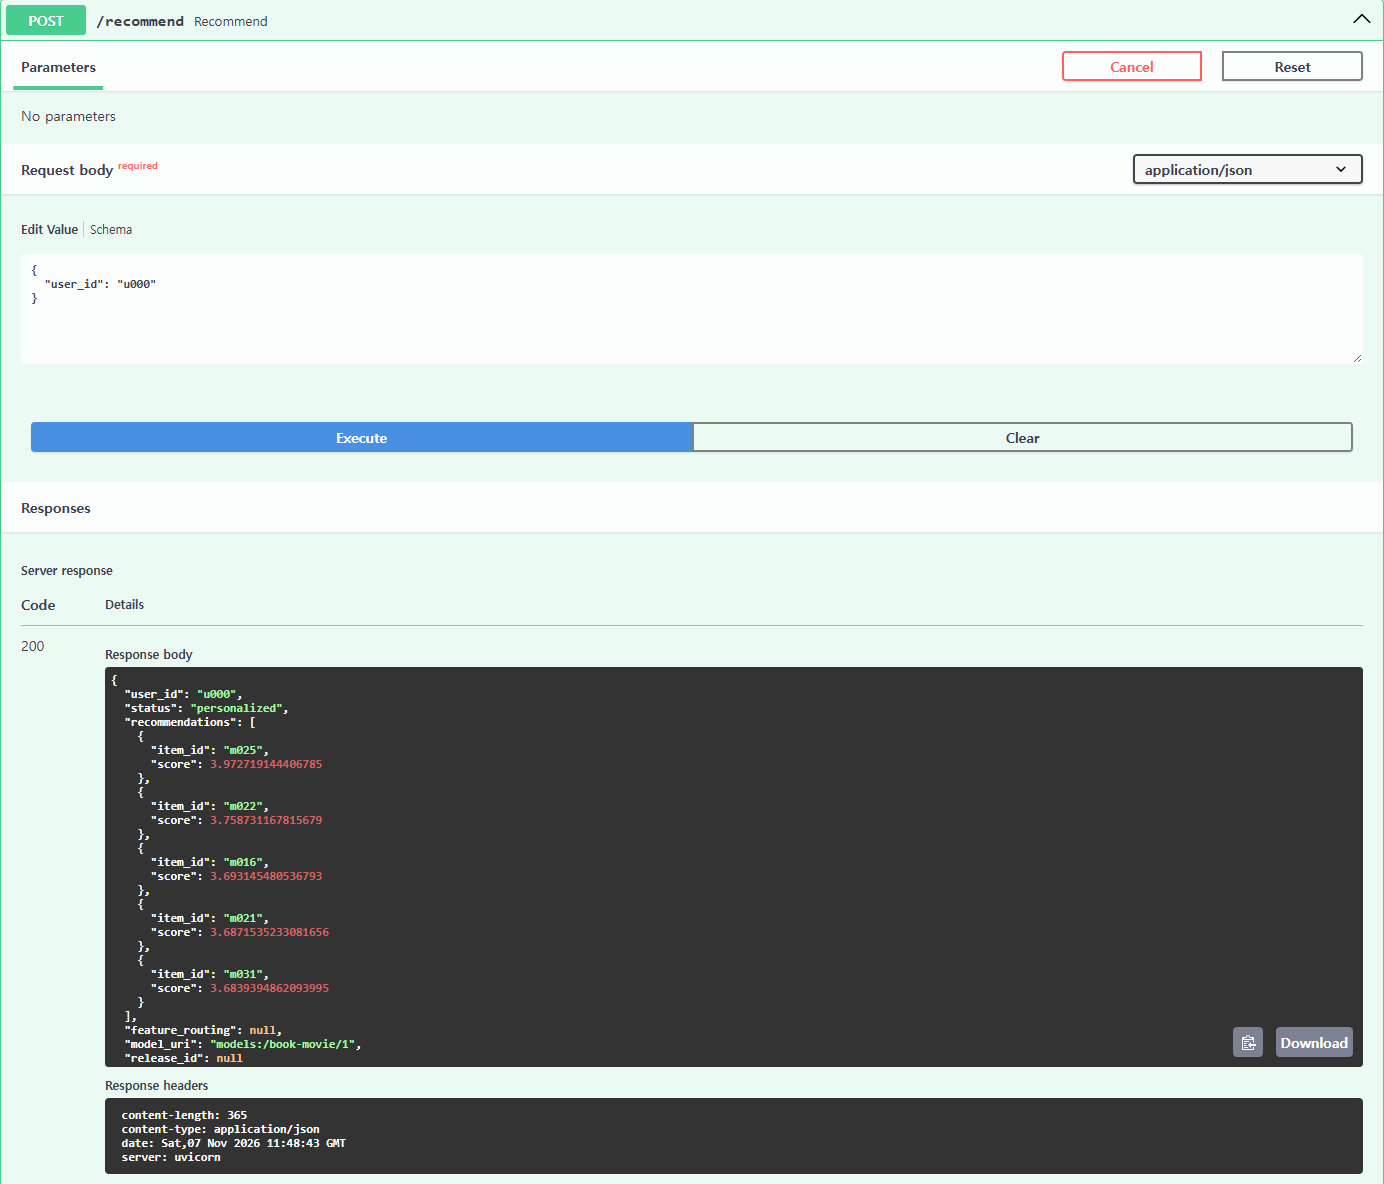
같은 화면에서 {"user_id": "new-user"}로 바꿔 다시 실행한다.
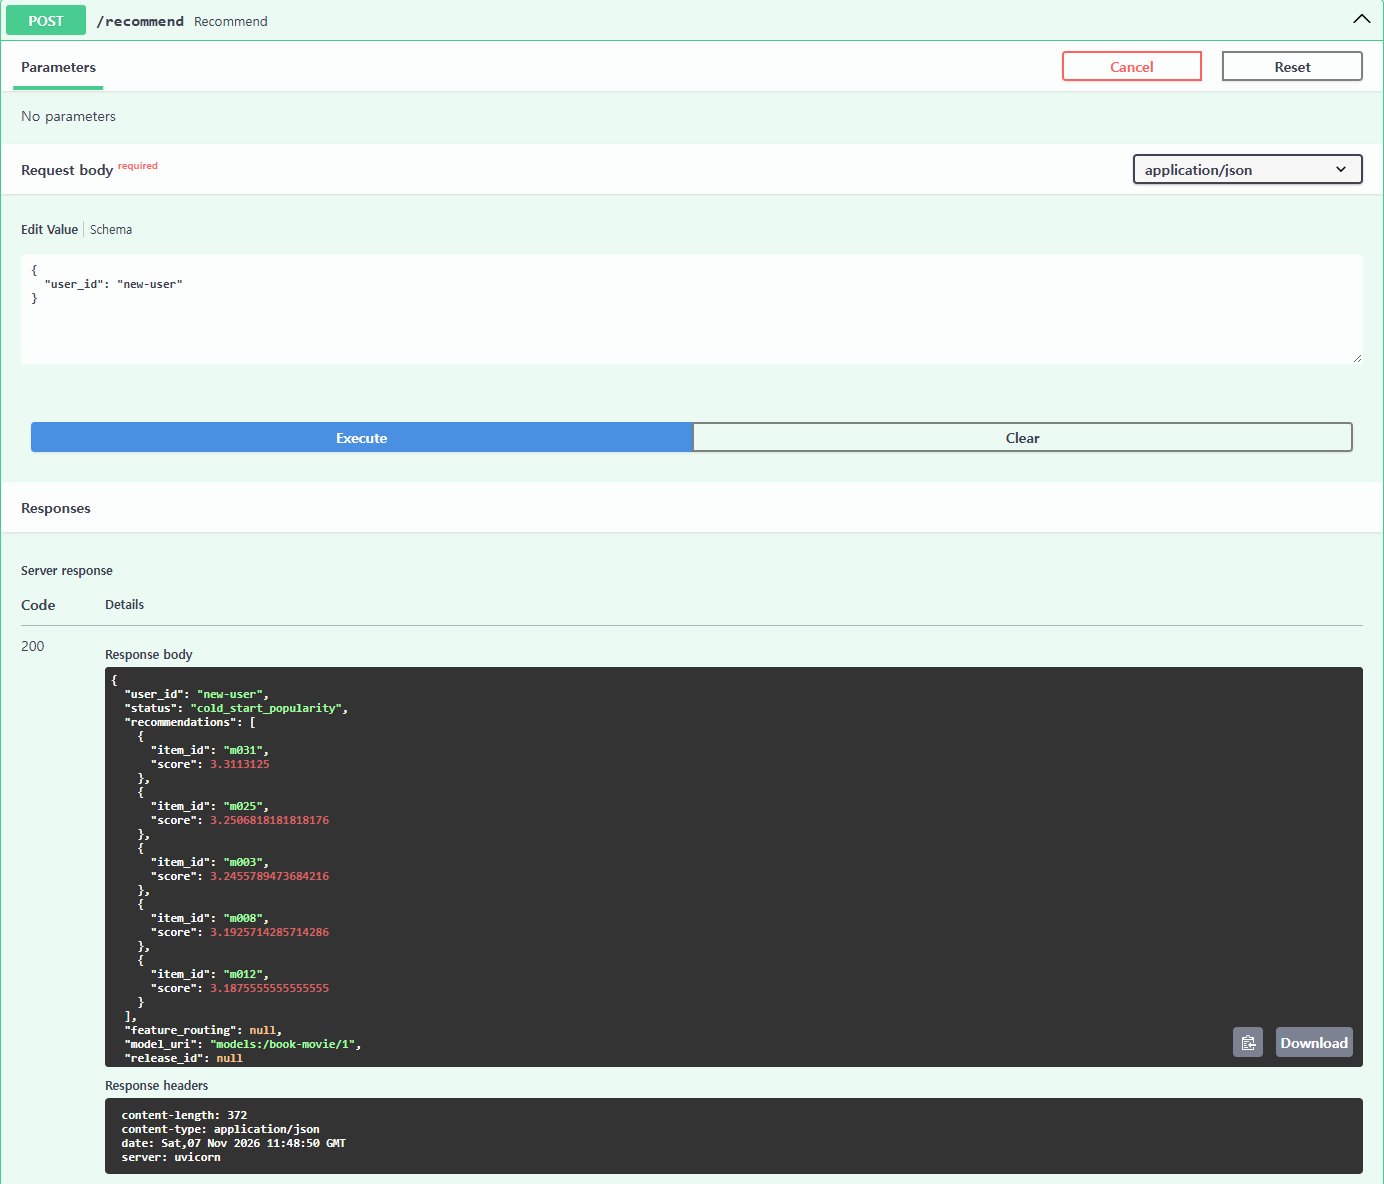
확인했으면 터미널 B에서 Ctrl+C로 서버를 끈다. 같은 포트는 10장에서 다시 쓴다.
6-4. BentoML로 모델을 가져오고 Bento를 만든다
터미널 A, bento 환경. BentoML 모델 저장소는 실습 폴더 안으로 옮긴다. 기본 위치(%USERPROFILE%\bentoml)는 다른 프로젝트와 함께 쓰는 곳이라, 다른 BentoML 서버가 켜져 있으면 task_result.db가 잠겨 6-5에서 서버가 뜨지 않는다.
$env:UV_PROJECT_ENVIRONMENT = ".ml-labs\book-env-bento"
$env:BENTOML_HOME = Join-Path (Resolve-Path $W).Path "bentoml-home"
uv run --locked --extra bento ml-labs tools bento build --candidate "$W\runs\movies\candidate.json" --output "$W\bento"
uv run --locked --extra bento bentoml build "$W\bento"
uv run --locked --extra bento bentoml models list
uv run --locked --extra bento bentoml list
실제 출력(pkg_resources 경고 생략):
{
  "output": ".ml-labs\\book-01\\bento\\bentofile.yaml"
}
INFO: Locking PyPI package versions.
INFO: Locking packages for x86_64-unknown-linux-gnu. Pass `--platform` option to specify the platform.

Successfully built Bento(tag="ml-labs-movies:nql2o762ug3h3laz").
 Tag                           Module          Size        Creation Time
 ml-labs-movies:njdahiw2ugjh…  bentoml.mlflow  219.72 KiB  2026-11-07 20:50:23
 Tag                              Size       Model Size  Creation Time
 ml-labs-movies:nql2o762ug3h3laz  19.24 KiB  219.72 KiB  2026-11-07 20:50:26
tools bento build는 MLflow 모델을 BentoML 저장소로 가져오고 service.py와 bentofile.yaml을 만든다. bentoml build는 그 둘을 Bento 패키지로 묶는데, 이때 패키지 버전을 잠그느라 PyPI에 접속한다. 컨테이너 생성(bentoml containerize)과 Kubernetes 배포는 하지 않는다. 코드는 BentoML 1.3.10 방식이며 책의 1.1.10 Service, Runner 선언을 섞지 않는다.
6-5. Bento 서비스를 켠다
터미널 B, bento 환경. 6-1의 서버를 끈 같은 창을 써도 된다.
$env:UV_PROJECT_ENVIRONMENT = ".ml-labs\book-env-bento"
$env:BENTOML_HOME = Join-Path (Resolve-Path $W).Path "bentoml-home"
uv run --locked --extra bento bentoml serve service:PlatformLabService --working-dir "$W\bento" --host 127.0.0.1 --port 3000
Converting 'PlatformLabService' to lowercase 경고는 무시해도 된다. 3000번을 다른 프로그램이 이미 쓰고 있으면 엉뚱한 서비스가 응답하니, 먼저 Get-NetTCPConnection -LocalPort 3000 -State Listen -ErrorAction SilentlyContinue로 비어 있는지 본다. 검증할 때는 다른 실습 서비스가 3000번을 차지하고 있어서 --port 3010으로 띄웠다. 아래 출력과 화면은 3010번에서 얻은 것이다.
6-6. Bento에 요청한다
터미널 A. 요청 구조가 FastAPI와 다르다. BentoML은 메서드 인자 이름(request)으로 본문을 한 번 더 감싼다.
$body = @{ request = @{ user_id = "u000" } } | ConvertTo-Json -Depth 4
Invoke-RestMethod http://127.0.0.1:3000/predict -Method Post -ContentType application/json -Body $body | ConvertTo-Json -Depth 6
실제 출력(추천 목록 일부):
{
  "user_id": "u000",
  "status": "personalized",
  "recommendations": [
    { "item_id": "m025", "score": 3.972719144406785 },
    { "item_id": "m022", "score": 3.758731167815679 },
    ...
  ]
}
같은 등록 모델이라 추천과 점수가 6-2의 FastAPI와 똑같다. 브라우저 C에서 http://127.0.0.1:3000/을 열면 BentoML의 Swagger 화면이 나온다. POST /predict의 Try it out에 {"request": {"user_id": "u000"}}을 넣고 실행한다.
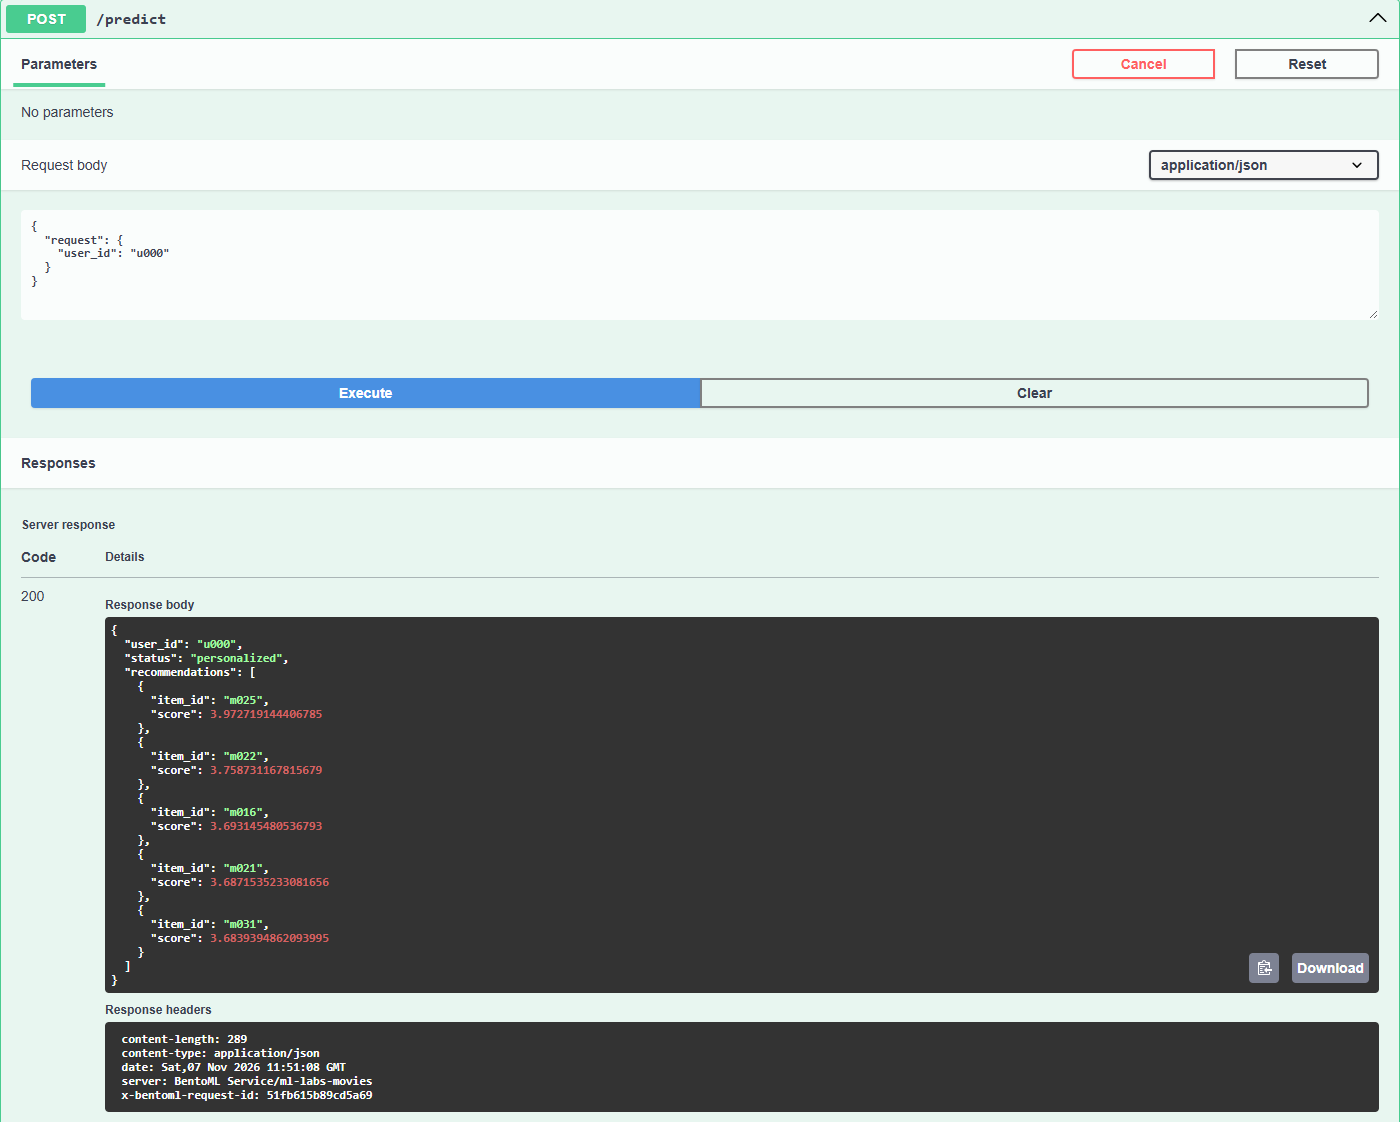
확인했으면 터미널 B에서 Ctrl+C로 끄고 Remove-Item Env:BENTOML_HOME으로 환경 변수를 지운다. 같은 데이터의 드리프트 보고서는 11장에서 만든다.
완료 확인
- FastAPI 응답의
model_uri가models:/book-movie/1이다. - 기존 사용자는
personalized, 새 사용자는cold_start_popularity다. -
bentoml list에 Bento가 하나 있고/predict가 같은 추천을 돌려준다.
7장. 다음 학습이 사용할 데이터를 준비한다
8장과 9장이 쓸 데이터를 만든다. 하나는 탐지 학습용 카드 이미지이고, 다른 하나는 합성 평점 대신 실제 MovieLens를 넣는 경로다. 앞에서 만든 추천 데이터는 건드리지 않는다.
7-1. 합성 카드 이미지와 YOLO 라벨을 만든다
터미널 A, 기본 환경. 학습 80장, 검증 20장, 테스트 20장을 만든다. 실제 신분증이나 개인정보는 들어 있지 않다.
$env:UV_PROJECT_ENVIRONMENT = ".ml-labs\book-env-base"
uv run --locked --extra dev ml-labs cards prepare --output "$W\data\cards" --train 80 --validation 20 --test 20
Get-Content "$W\data\cards\manifest.json"
실제 출력:
{
  "result": "C:\\Users\\<사용자>\\...\\.ml-labs\\book-01\\data\\cards"
}
{
  "dataset": "synthetic-cards",
  "seed": 42,
  "sha256": "3b33e08ea983fa42431bbfc7dc1b07e203afa21fec1c678437c30ac7ed1c19aa",
  "counts": {
    "train": 80,
    "validation": 20,
    "test": 20
  },
  "limitations": "Axis-aligned generated cards, independent images, no identity data; not OCR."
}
7-2. 이미지와 라벨의 짝을 확인한다
터미널 A. 이미지와 같은 이름(stem)의 .txt가 라벨이다. YOLO 라벨 한 줄은 클래스, 정규화한 중심 x, 중심 y, 너비, 높이다.
Get-ChildItem "$W\data\cards\images\train" | Select-Object -First 3 Name, Length
Get-ChildItem "$W\data\cards\labels\train" | Select-Object -First 3 Name, Length
Get-Content "$W\data\cards\labels\train\train-0001.txt"
실제 출력:
Name                 Length
----                 ------
train-0000.png        43666
train-0001.png        37664
train-0002.png        37428
train-0000.txt            0
train-0001.txt           39
train-0002.txt           39
0 0.355469 0.527344 0.507812 0.273438
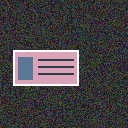
크기가 0인 라벨은 카드가 없는 음성 표본이다. 이런 표본이 있어야 빈 화면에 상자를 그리지 않는지 평가할 수 있다. train-0001.png를 열면 128x128 잡음 배경 위에 카드 모양 사각형이 하나 있다.
7-3. 실제 MovieLens로 바꾸는 경로를 확인한다
터미널 A, 기본 환경. GroupLens의 이용 조건을 먼저 읽는다. 원본 압축 파일과 변환 데이터는 저장소에 커밋하지 않는다.
New-Item -ItemType Directory -Path "$W\downloads" -Force | Out-Null
Invoke-WebRequest https://files.grouplens.org/datasets/movielens/ml-latest-small.zip -OutFile "$W\downloads\ml-latest-small.zip"
uv run --locked --extra dev ml-labs movies import-movielens --archive "$W\downloads\ml-latest-small.zip" --output "$W\data\movielens"
Get-Content "$W\data\movielens\manifest.json"
실제 출력:
{
  "result": ".ml-labs\\book-01\\data\\movielens"
}
{
  "dataset": "movielens-latest-small",
  "rows": 100836,
  "sha256": "040461a97369a50dddec17d460ae4d11be07d5e8a3ebecb665cba20dbdda02a1",
  "archive_sha256": "28cef425f57f870a1b4d8e32d100017b4dd8f3238481430fb9bca8705100d27d",
  "source": "https://grouplens.org/datasets/movielens/latest/",
  "rating_transform": "1 + (original_rating - 0.5) * 4 / 4.5",
  "split": "per-user chronological timestamp groups, 80/10/10 of unique timestamps",
  "license": "MovieLens terms apply; archive and derived data must not be committed."
}
압축 파일은 약 1MB이고 평점 100,836건이 변환된다. manifest에는 원천 지문, 평점 변환식, 사용자별 시간 분할 방식이 남는다. random_state를 고정해도 미래 정보나 인접 프레임 누수는 막지 못한다.
이 명령은 작은 자료용이라 책의 25M 전체 자료에는 쓰지 않는다. 이후 장은 재현성을 위해 합성 평점을 계속 쓴다.
완료 확인
-
counts가 80, 20, 20이다. - 라벨 파일 중 빈 파일(음성 표본)과 한 줄짜리 파일이 함께 있다.
- MovieLens
manifest.json에rows, 변환식과 분할 방식이 기록됐다.
8장. 기준선과 실제 탐지 학습을 구분한다
색상 규칙으로 만든 기준선과 실제 YOLOv8 학습을 같은 데이터, 같은 평가로 비교한다. 결과는 예상과 반대였다. 쉬운 합성 데이터에서는 규칙이 더 잘 맞혔다.
8-1. 색상 기준선을 학습하고 등록한다
터미널 A, 기본 환경. 학습이라 부르지만 색상 임계값을 정하는 규칙 기준선이다. 비교 대상이 있어야 학습 모델의 가치를 판단할 수 있다.
uv run --locked --extra dev ml-labs cards train --data "$W\data\cards" --output "$W\runs\cards" --work "$W\tracking"
uv run --locked --extra dev ml-labs cards evaluate --candidate "$W\runs\cards\candidate.json" --data "$W\data\cards" --report "$W\reports\cards.json"
uv run --locked --extra dev ml-labs register --candidate "$W\runs\cards\candidate.json" --report "$W\reports\cards.json" --name book-card-baseline
실제 출력(평가 결과는 판정 부분만):
{
  "result": ".ml-labs\\book-01\\runs\\cards\\candidate.json"
}
{
  "result": {
    "task": "cards",
    "passed": true,
    "min_mean_iou": 0.75,
    "validation_mean_iou": 0.9999976948801512,
    "metrics": {
      "images": 20,
      "mean_iou": 0.9999983959985037,
      "box_recall_iou_0_5": 1.0,
      "negative_images": 4,
      "false_positives": 0
    },
    "candidate": { "backend": "color_component_baseline", ... },
    "split": "test",
    "test_policy": "Test split opened after passing the validation IoU gate."
  }
}
Successfully registered model 'book-card-baseline'.
Created version '1' of model 'book-card-baseline'.
합성 카드는 배경과 색이 뚜렷하게 달라 규칙만으로 IoU가 1에 가깝다. 이 숫자는 실제 촬영 환경의 성능이 아니라 데이터가 쉽다는 신호로 읽는다.
8-2. vision 환경과 Ultralytics 설정을 격리한다
터미널 A, vision 환경. Ultralytics는 사용자 폴더의 설정 파일을 모든 프로젝트가 함께 쓰고, MLflow가 설치돼 있으면 자동 콜백을 켠다. Windows에서는 이 콜백이 별도 runs\mlflow에 기록하거나, Windows 경로를 URI로 잘못 읽어 학습 시작 전에 실패하기도 한다. 그래서 설정을 실습 폴더로 옮기고 자동 콜백과 동기화를 끈다. 모델 기록은 학습이 끝난 뒤 실습 코드가 같은 Tracking DB에 직접 남긴다.
$env:UV_PROJECT_ENVIRONMENT = ".ml-labs\book-env-vision"
New-Item -ItemType Directory -Path "$W\yolo-config" -Force | Out-Null
$env:YOLO_CONFIG_DIR = (Resolve-Path "$W\yolo-config").Path
uv run --locked --extra vision yolo settings mlflow=False sync=False
실제 출력(일부):
Creating new Ultralytics Settings v0.0.6 file ✅
View Ultralytics Settings with 'yolo settings' or at 'C:\Users\<사용자>\...\.ml-labs\book-01\yolo-config\settings.json'
...
  "sync": false,
  ...
  "mlflow": false,
다른 프로젝트의 Ultralytics 설정은 그대로다. 새 터미널에서 이어 할 때는 YOLO_CONFIG_DIR부터 다시 지정한다.
8-3. YOLOv8n을 CPU로 10 epoch 학습한다
터미널 A, vision 환경. 사전학습 가중치 yolov8n.pt에서 시작해 카드 한 클래스로 미세조정한다. 처음 실행하면 가중치(약 6MB)와 글꼴을 내려받는다.
uv run --locked --extra vision ml-labs cards train --data "$W\data\cards" --output "$W\runs\cards-yolo" --work "$W\tracking" --backend yolov8 --epochs 10실제 출력(일부):
Ultralytics 8.3.40 🚀 Python-3.12.12 torch-2.5.1+cpu CPU (13th Gen Intel Core(TM) i7-1360P)
engine\trainer: task=detect, mode=train, model=yolov8n.pt, ..., epochs=10, ..., imgsz=128, ..., device=cpu, ...
Overriding model.yaml nc=80 with nc=1
Transferred 319/355 items from pretrained weights
...
                 Class     Images  Instances      Box(P          R      mAP50  mAP50-95)
                   all         20         16      0.987          1      0.995      0.976
Results saved to .ml-labs\book-01\runs\cards-yolo\yolo\synthetic-cards
{
  "result": ".ml-labs\\book-01\\runs\\cards-yolo\\candidate.json"
}
학습은 CPU에서 41초 걸렸다. 마지막 표는 검증 20장(카드 16개)에 대한 Ultralytics 자체 검증 결과다.
8-4. 학습 곡선과 검증 예측을 읽는다
터미널 A 또는 탐색기. 결과 폴더에는 가중치와 학습 그림이 남는다.
Get-ChildItem "$W\runs\cards-yolo\yolo\synthetic-cards" -Recurse -Include *.pt, results.png, val_batch0_pred.jpg, results.csv | Select-Object Name, Length
Start-Process "$W\runs\cards-yolo\yolo\synthetic-cards\results.png"
실제 출력:
Name                 Length
----                 ------
best.pt             6190883
last.pt             6190883
results.csv            1332
results.png          282859
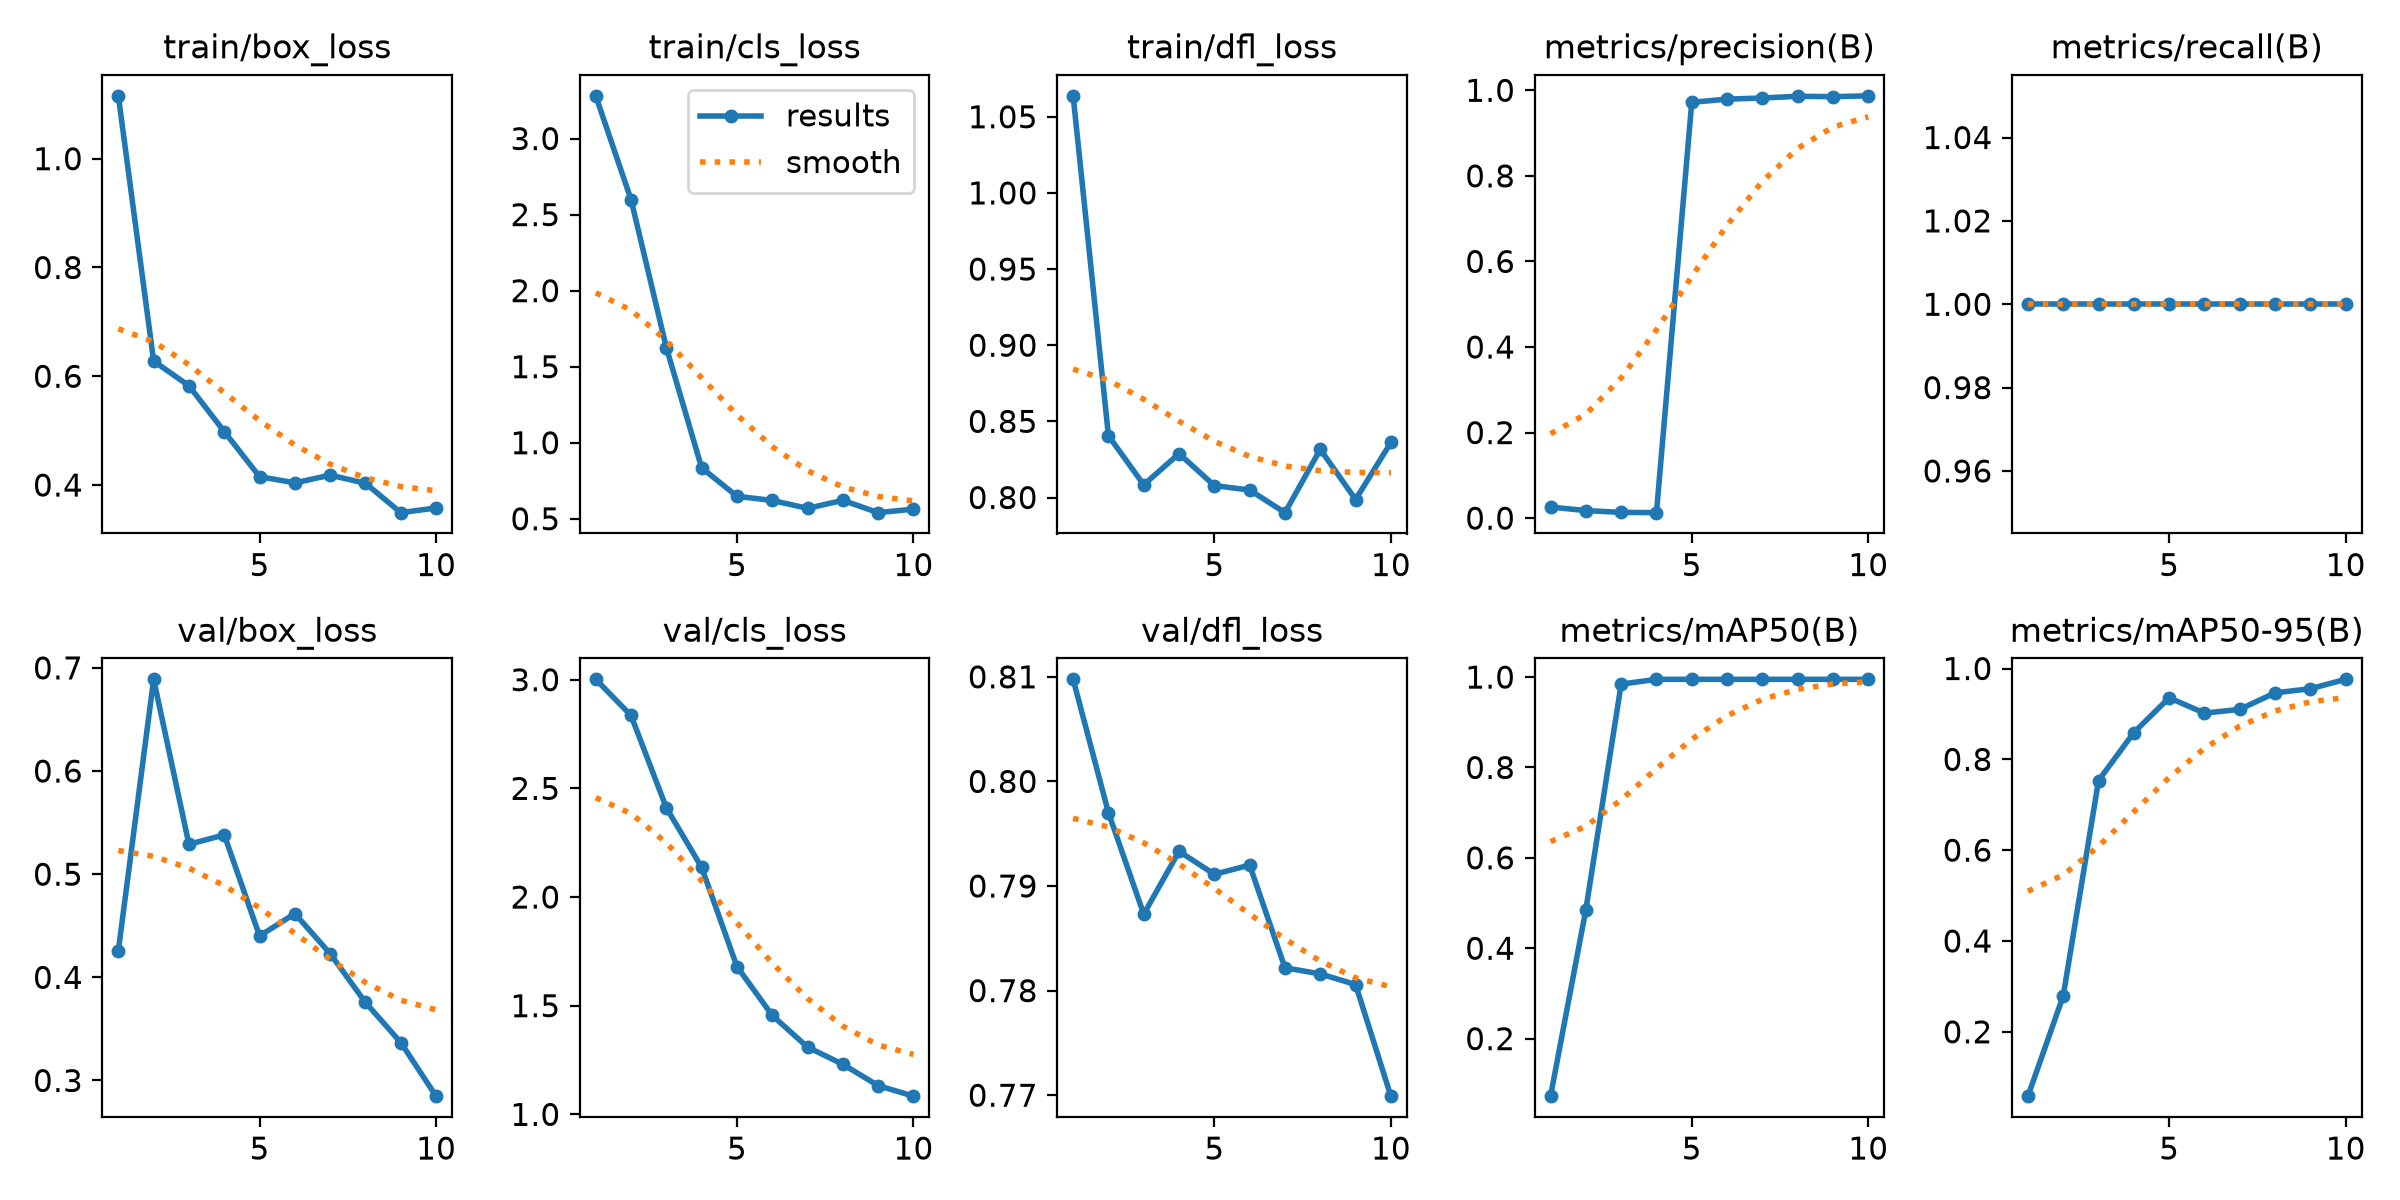
val_batch0_pred.jpg 107486results.png에서 손실은 꾸준히 내려가고 mAP50은 3 epoch부터 0.98 이상이다. 눈에 띄는 것은 precision이다. 4 epoch까지 0.01대에 머물다가 5 epoch에 0.97로 뛴다. 초반에는 신뢰도 낮은 상자를 잔뜩 그리다가 학습이 진행되며 정리된 것이다.
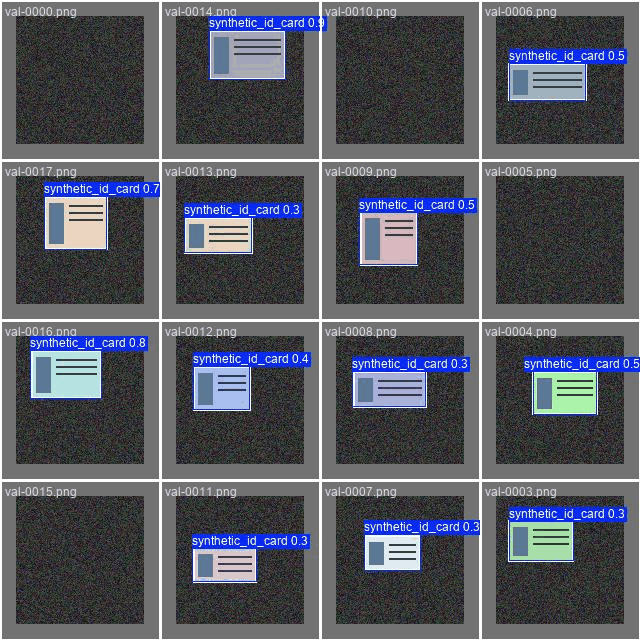
val_batch0_pred.jpg는 검증 이미지 16장에 대한 예측이다. 카드가 있는 칸에는 synthetic_id_card와 신뢰도가 붙고 빈 배경에는 상자가 없다. 다만 신뢰도가 0.3~0.9로 넓게 퍼져 있어, 10 epoch 모델은 아직 확신이 낮다.
8-5. 실습 평가로 판정하고 등록한다
터미널 A, vision 환경. Ultralytics의 mAP와 별개로 기준선과 같은 IoU 평가를 적용한다. 검증 IoU 게이트를 통과해야 테스트를 연다.
uv run --locked --extra vision ml-labs cards evaluate --candidate "$W\runs\cards-yolo\candidate.json" --data "$W\data\cards" --report "$W\reports\cards-yolo.json" --min-iou 0.5
uv run --locked --extra vision ml-labs register --candidate "$W\runs\cards-yolo\candidate.json" --report "$W\reports\cards-yolo.json" --name book-card-yolo
실제 출력(판정 부분):
{
  "result": {
    "task": "cards",
    "passed": true,
    "min_mean_iou": 0.5,
    "validation_mean_iou": 0.8492493319417679,
    "metrics": {
      "images": 20,
      "mean_iou": 0.9675049159141798,
      "box_recall_iou_0_5": 1.0,
      "negative_images": 4,
      "false_positives": 0
    },
    "candidate": {
      "backend": "yolov8",
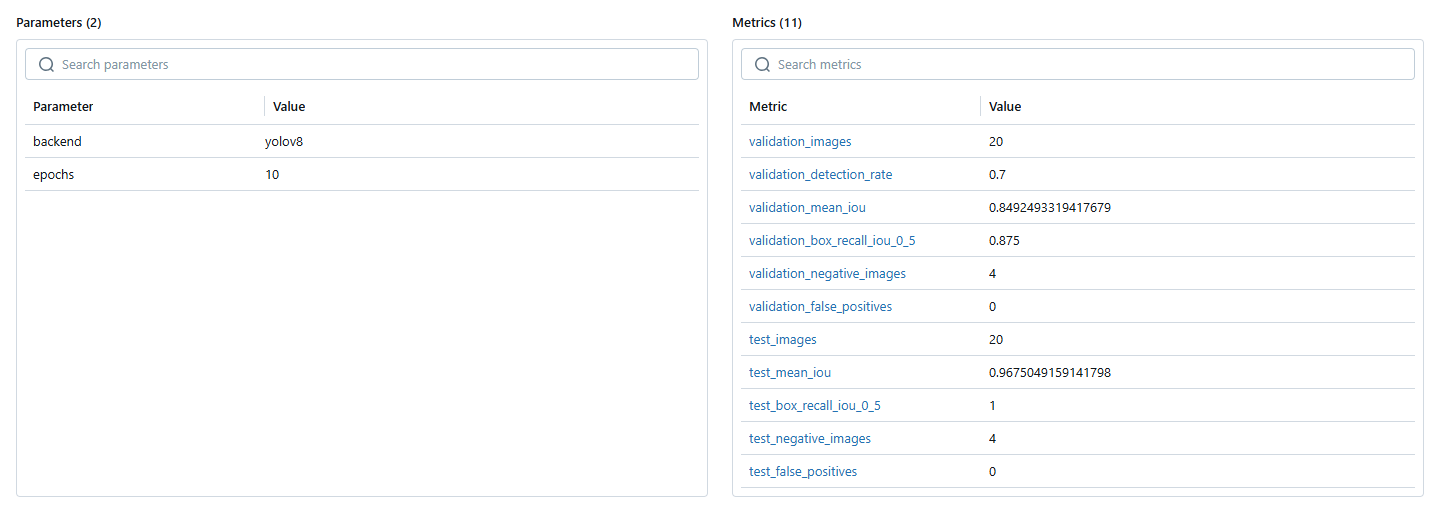
      "validation": { "detection_rate": 0.7, "mean_iou": 0.8492493319417679, "box_recall_iou_0_5": 0.875, ... },
      ...
    }
  }
}
Successfully registered model 'book-card-yolo'.
Created version '1' of model 'book-card-yolo'.
YOLO는 검증에서 카드 16개 중 2개를 놓쳤다(box_recall_iou_0_5 0.875). 기준선보다 낮지만 설정한 IoU 0.5 게이트는 통과한다. 기준선보다 못한 모델을 등록할지는 정책의 문제다. 여기서는 학습한 가중치를 저장하고 다시 읽어 서빙하는 경로를 익히려고 등록하지만, 운영에서는 기준선을 넘지 못한 후보를 출시하지 않는 규칙을 둘 수 있다. 합성 데이터에서 10 epoch로 얻은 IoU를 실제 신분증 환경의 mAP 인증으로 읽어서도 안 된다.
8-6. MLflow에서 YOLO 후보를 확인한다
브라우저 C. 4장의 MLflow UI(5001번)를 새로고침하고 Models 열이 book-card-yolo v1인 run을 연다. 파라미터는 backend=yolov8, epochs=10이고 검증과 테스트 지표가 함께 남는다.
8-7. 작은 실제 학습과 재로딩을 테스트로 점검한다
터미널 A, vision 환경. 이 테스트는 임시 폴더에서 YOLO를 짧게 학습하고 MLflow 모델로 저장한 뒤 다시 읽어 추론한다. ML_LABS_RUN_VISION을 지정하지 않으면 테스트가 실행되지 않고 skipped로만 표시되므로 꼭 지정한다.
$env:ML_LABS_RUN_VISION = "1"
uv run --locked --extra dev --extra vision pytest -q -p no:warnings tests\test_vision.py
Remove-Item Env:ML_LABS_RUN_VISION
실제 출력:
.                                                                        [100%]
1 passed in 12.69sYOLO_CONFIG_DIR은 10장의 탐지 서버에서 다시 쓴다. 다른 프로젝트로 이동할 때 Remove-Item Env:YOLO_CONFIG_DIR -ErrorAction SilentlyContinue로 지운다.
완료 확인
-
book-card-baseline과book-card-yolo가 모두 버전 1로 등록됐다. -
best.pt,results.png,val_batch0_pred.jpg가 생겼다. - 비전 테스트가
1 passed다.
9장. 추천 후보를 검증 데이터로 선택한다
테스트 점수를 보고 모델을 고르면 그 테스트는 더 이상 공정한 시험이 아니다. 그래서 4장의 테스트 결과는 선택에 쓰지 않는다. 새 seed로 만든 데이터에서 rank 2와 4를 학습하고, 검증 지표만으로 하나를 고른 뒤 그 후보만 테스트한다.
9-1. 새 데이터에서 두 후보를 학습한다
터미널 A, 기본 환경.
$env:UV_PROJECT_ENVIRONMENT = ".ml-labs\book-env-base"
uv run --locked --extra dev ml-labs movies prepare --output "$W\data\movies-ch09" --seed 43
uv run --locked --extra dev ml-labs movies train --data "$W\data\movies-ch09" --output "$W\runs\movies-rank2" --work "$W\tracking" --rank 2
uv run --locked --extra dev ml-labs movies train --data "$W\data\movies-ch09" --output "$W\runs\movies-rank4" --work "$W\tracking" --rank 4
실제 출력:
{
  "result": ".ml-labs\\book-01\\data\\movies-ch09"
}
{
  "result": ".ml-labs\\book-01\\runs\\movies-rank2\\candidate.json"
}
{
  "result": ".ml-labs\\book-01\\runs\\movies-rank4\\candidate.json"
}
9-2. 검증 NDCG와 RMSE로 후보를 고른다
터미널 A. 검증 NDCG@5가 높은 후보를 우선하고, 같으면 검증 RMSE가 낮은 후보를 고른다. 고른 경로는 파일로 남겨, 다음 장과 다른 터미널에서도 같은 후보를 쓴다.
$paths = @("$W\runs\movies-rank2\candidate.json", "$W\runs\movies-rank4\candidate.json")
$ranked = $paths | ForEach-Object {
    $candidate = Get-Content $_ -Raw | ConvertFrom-Json
    [pscustomobject]@{
        Path = $_
        NDCG = $candidate.metrics.validation_model_ndcg_at_5
        RMSE = $candidate.metrics.validation_rmse
    }
} | Sort-Object @{Expression = "NDCG"; Descending = $true}, @{Expression = "RMSE"; Ascending = $true}
$ranked | Format-Table -AutoSize
$MovieCandidate = $ranked[0].Path
$MovieCandidate | Set-Content "$W\selected-movie-path.txt" -Encoding utf8
실제 출력:
Path                                              NDCG RMSE
----                                              ---- ----
.ml-labs\book-01\runs\movies-rank2\candidate.json 0.50 0.68
.ml-labs\book-01\runs\movies-rank4\candidate.json 0.40 0.67
검증 NDCG는 rank 2가 0.5036, rank 4가 0.4000이다. RMSE만 보면 rank 4가 0.6699로 rank 2의 0.6786보다 조금 낫다. 두 지표가 서로 다른 후보를 가리키는 셈이다. 순위 품질을 우선한다는 규칙에 따라 rank 2를 고른다. 평점 오차와 추천 순위는 다른 질문이라, 무엇을 우선할지는 학습 전에 정해 두어야 한다.
9-3. 선택한 후보만 평가하고 등록한다
터미널 A. 테스트 분할은 선택 뒤 한 번만 연다. 평가가 실패하면 여기서 멈춘다.
uv run --locked --extra dev ml-labs movies evaluate --candidate $MovieCandidate --data "$W\data\movies-ch09" --report "$W\reports\movie-selected.json"
$LASTEXITCODE
uv run --locked --extra dev ml-labs register --candidate $MovieCandidate --report "$W\reports\movie-selected.json" --name book-movie-selected
실제 출력(판정 부분):
    "passed": true,
      "test_recall_at_5": 0.6666666666666666,
    "observed_validation_rmse": 0.6786069439813943,
      "observed_lift": 0.21742120054652125,
      "passed": true
0
Successfully registered model 'book-movie-selected'.
Created version '1' of model 'book-movie-selected'.
  "registered_uri": "models:/book-movie-selected/1"
9-4. MLflow에서 선택 근거를 확인한다
브라우저 C. MLflow UI를 새로고침하면 지금까지의 run 다섯 개와 등록 모델이 함께 보인다. book-movie-selected가 붙은 run이 rank 2 후보다.
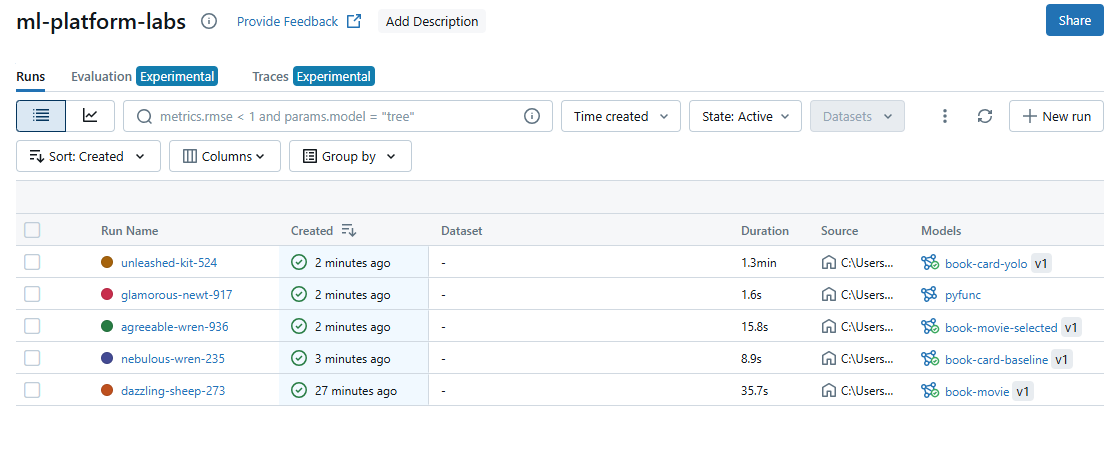
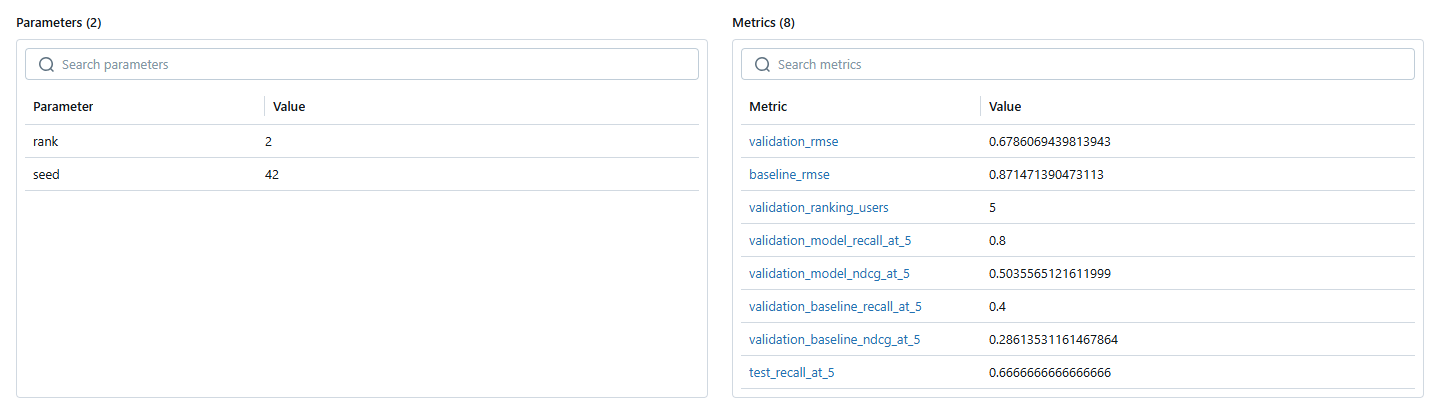
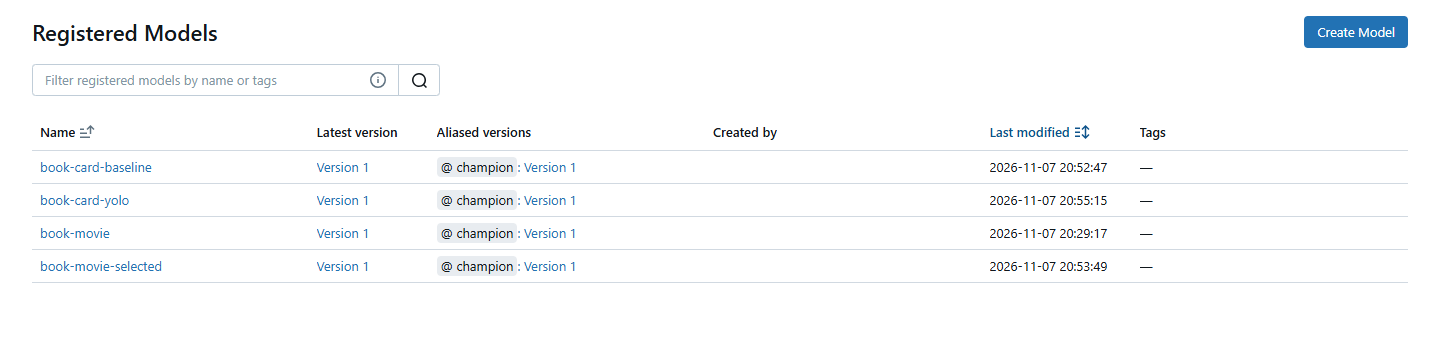
다만 검증 순위를 매긴 사용자가 5명뿐이라 지표가 크게 흔들릴 수 있다. 0.5036과 0.4000의 차이도 그만큼 감안해서 읽는다. 모델 자체는 단순한 SVD 추천이고, 책의 추천 알고리즘과 대규모 학습을 모두 재현하지는 않았다. MLflow UI는 여기서 터미널 B의 Ctrl+C로 꺼도 된다.
완료 확인
- 선택 이유가 테스트가 아닌 검증 지표에 있다.
-
selected-movie-path.txt에 rank 2 후보 경로가 있다. -
models:/book-movie-selected/1이 등록됐다.
10장. 출시, 요청과 배치 재처리를 연결한다
선택한 후보를 출시 기록으로 고정하고, 온라인 요청과 배치 처리가 같은 출시를 쓰는지 본다. 탐지 모델도 같은 방식으로 서버에 올린다.
10-1. 선택 후보를 출시 기록으로 묶는다
터미널 A, 기본 환경. 출시 기록은 후보, 평가 보고서 해시와 데이터 지문을 하나의 release_id로 묶는다.
$MovieCandidate = (Get-Content "$W\selected-movie-path.txt" -Raw).Trim()
uv run --locked --extra dev ml-labs release activate --candidate $MovieCandidate --report "$W\reports\movie-selected.json" --store "$W\movie-releases"
uv run --locked --extra dev ml-labs release show --store "$W\movie-releases"
실제 출력(release show의 끝부분):
{
  "candidate": {
    "task": "movies",
    "run_id": "a260879e6a8a449b955a6cf19ac316d0",
    ...
    "registered_uri": "models:/book-movie-selected/1"
  },
  "report_sha256": "f54cd82f8224ea5ac4932708798020e748ec947c0463d99f18c549e3c284d6b1",
  "dataset_sha256": "8e9118d658ca4acb4d1898662df0a296b958692bc69b2eff1b6815d2fbb6cc7e",
  "release_id": "5a919a1c3045fc007f7148f5a624702cb0c20998a4e23b7856f7b6badf5e08c3"
}activate의 출력도 같고 "changed": true가 더 붙는다.
10-2. 출시 기록으로 서버를 켠다
터미널 B, 기본 환경.
Set-Location $HOME\ml-labs-book\ml-platform-engineering-labs
$W = ".ml-labs\book-01"
$env:UV_PROJECT_ENVIRONMENT = ".ml-labs\book-env-base"
Remove-Item Env:MLFLOW_TRACKING_URI -ErrorAction SilentlyContinue
uv run --locked --extra dev ml-labs serve --movie-release "$W\movie-releases" --host 127.0.0.1 --port 8000
추천 서버는 시작할 때 출시 기록의 모델을 읽어 고정한다. 출시 포인터를 바꿔도 실행 중인 서버는 그대로이고, 바꾸려면 다시 시작해야 한다. 13장의 RAG 서버와 다른 점이다.
10-3. 응답에 출시 ID가 붙는지 확인한다
터미널 A.
Invoke-RestMethod http://127.0.0.1:8000/health | ConvertTo-Json -Depth 6
$body = @{ user_id = "u000" } | ConvertTo-Json
Invoke-RestMethod http://127.0.0.1:8000/recommend -Method Post -ContentType application/json -Body $body | ConvertTo-Json -Depth 6
실제 출력(일부):
{
  "status": "ok",
  "models": { "cards": false, "movies": true, "rag": false },
  "movie_release_id": "5a919a1c3045fc007f7148f5a624702cb0c20998a4e23b7856f7b6badf5e08c3",
  ...
}
{
  "user_id": "u000",
  "status": "personalized",
  "recommendations": [
    { "item_id": "m022", "score": 3.405480632014961 },
    { "item_id": "m005", "score": 3.279502309118273 },
    ...
  ],
  "feature_routing": null,
  "model_uri": "models:/book-movie-selected/1",
  "release_id": "5a919a1c3045fc007f7148f5a624702cb0c20998a4e23b7856f7b6badf5e08c3"
}
6장과 같은 사용자지만 모델이 바뀌어 추천이 다르다. 브라우저 C의 http://127.0.0.1:8000/docs에서 같은 요청을 실행하면 응답 끝에 release_id가 보인다.
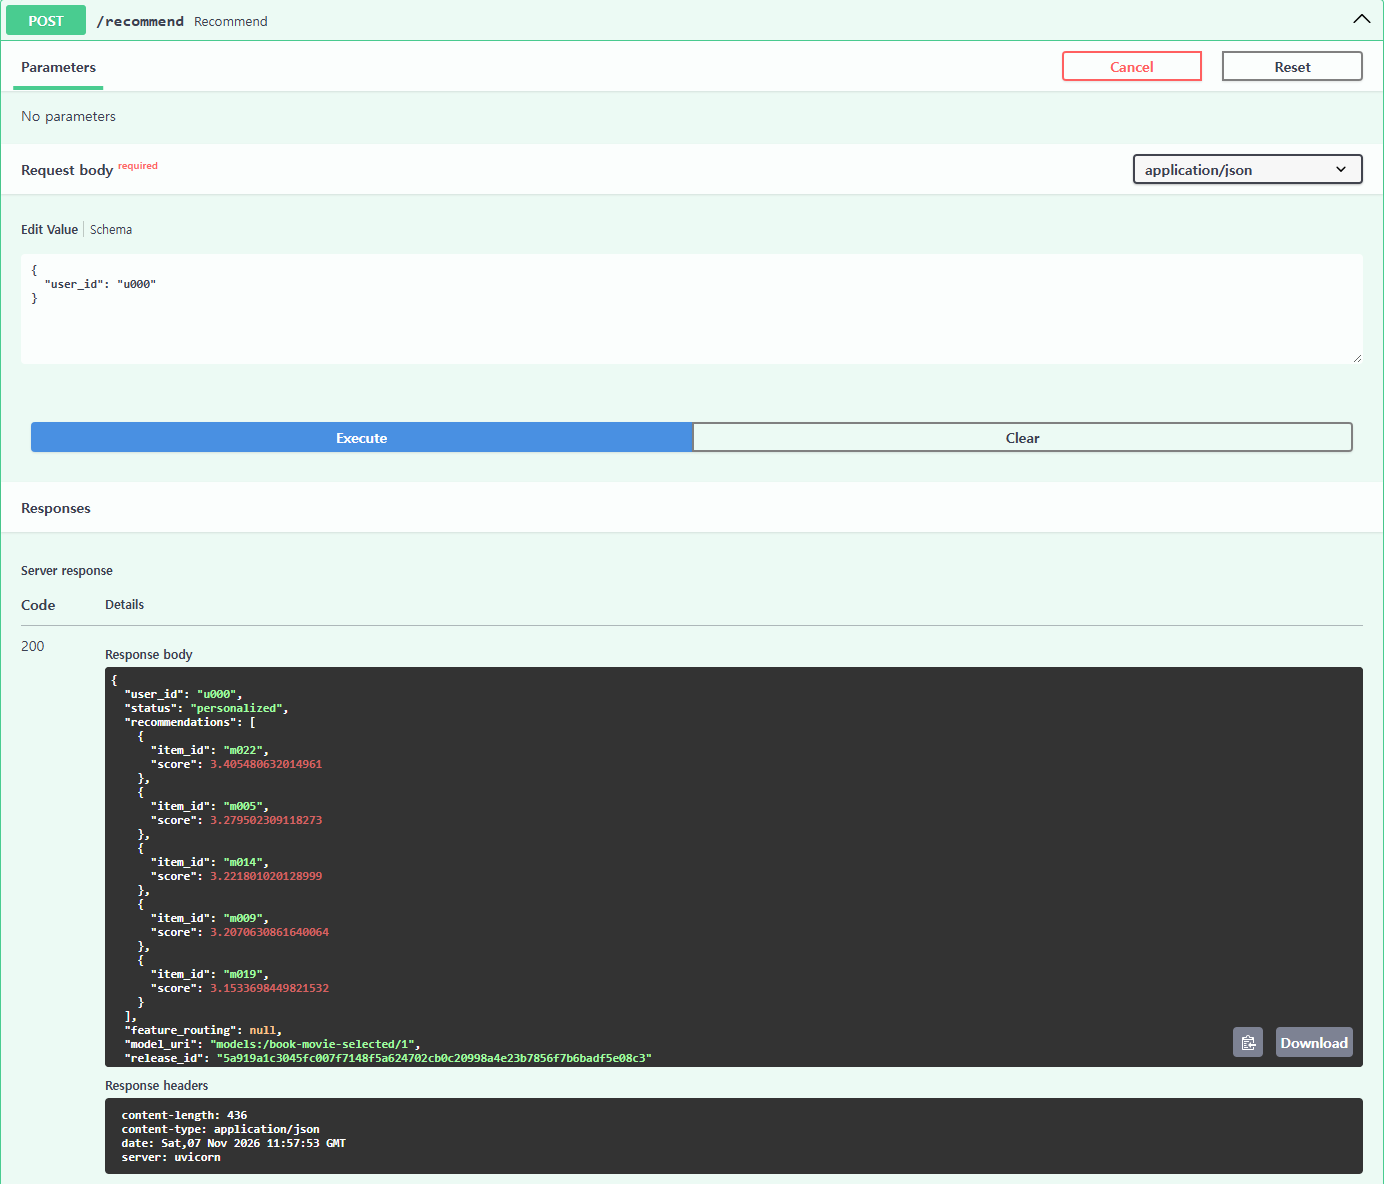
서버는 11장의 /metrics 확인까지 켜 둔다.
10-4. 배치를 실패시키고 같은 업무 키로 다시 실행한다
터미널 A. 사용자 파일과 업무 키(job-key)를 함께 넘긴다. 첫 실행은 추론 뒤 게시 직전에 일부러 실패한다.
@("user_id", "u000", "new-user") | Set-Content "$W\batch-users.csv" -Encoding utf8
uv run --locked --extra dev ml-labs batch --candidate $MovieCandidate --report "$W\reports\movie-selected.json" --users "$W\batch-users.csv" --output "$W\batch-results" --job-key book-day-01 --fail-before-commit
$LASTEXITCODE
Get-ChildItem "$W\batch-results" -Recurse -File
실제 출력:
ml-labs: error: Injected failure after inference, before batch publication.
2
실패한 뒤 batch-results에는 게시된 파일이 하나도 없다. 이번에는 실패 옵션만 빼고 같은 작업을 두 번 실행한다.
uv run --locked --extra dev ml-labs batch --candidate $MovieCandidate --report "$W\reports\movie-selected.json" --users "$W\batch-users.csv" --output "$W\batch-results" --job-key book-day-01
uv run --locked --extra dev ml-labs batch --candidate $MovieCandidate --report "$W\reports\movie-selected.json" --users "$W\batch-users.csv" --output "$W\batch-results" --job-key book-day-01
실제 출력:
{
  "output": ".ml-labs\\book-01\\batch-results\\130bd3280be6ec957d458e7d8bc0dd495362c82053fbc8f4f8a9e5fd8900b892",
  "reused": false,
  "identity": {
    "job_key": "book-day-01",
    "model_uri": "models:/book-movie-selected/1",
    "users_sha256": "753bea19c4ac45477e724eefe22c10621c17d9258ad7774a11d6de6437ac501d",
    "dataset_sha256": "8e9118d658ca4acb4d1898662df0a296b958692bc69b2eff1b6815d2fbb6cc7e",
    ...
  },
  "rows": 2,
  "output_sha256": "fbbe21abf540f1739a4a7c8f766a91f2fb28cd8d76cf7f7191d86a8a89bffd8c"
}
{
  "output": ".ml-labs\\book-01\\batch-results\\130bd3280be6ec957d458e7d8bc0dd495362c82053fbc8f4f8a9e5fd8900b892",
  "reused": true,
  ...
  "output_sha256": "fbbe21abf540f1739a4a7c8f766a91f2fb28cd8d76cf7f7191d86a8a89bffd8c"
}
두 번째 실행은 reused: true이고 출력 해시가 같다. 같은 업무 키에 다른 사용자 파일을 넘기면 거절된다.
@("user_id", "u001") | Set-Content "$W\batch-users-other.csv" -Encoding utf8
uv run --locked --extra dev ml-labs batch --candidate $MovieCandidate --report "$W\reports\movie-selected.json" --users "$W\batch-users-other.csv" --output "$W\batch-results" --job-key book-day-01
실제 출력:
ml-labs: error: Business job key already belongs to different inputs or model.결과 파일 predictions.json에는 모델 입력에서 뺐던 user_id가 응답마다 다시 붙어서 누구의 예측인지 알 수 있다. 어디까지나 한 컴퓨터의 파일시스템 위에서 하는 실험이다. 분산 저장소의 transaction이나 KServe의 무중단 전환은 다루지 않는다.
10-5. 탐지 모델 서버를 켠다
터미널 B2(새 창), vision 환경. 추천 서버와 포트를 나눠 8002번에 띄운다.
Set-Location $HOME\ml-labs-book\ml-platform-engineering-labs
$W = ".ml-labs\book-01"
$env:UV_PROJECT_ENVIRONMENT = ".ml-labs\book-env-vision"
$env:YOLO_CONFIG_DIR = (Resolve-Path "$W\yolo-config").Path
Remove-Item Env:MLFLOW_TRACKING_URI -ErrorAction SilentlyContinue
uv run --locked --extra vision ml-labs serve --cards "$W\runs\cards-yolo\candidate.json" --host 127.0.0.1 --port 8002
10-6. 카드가 있는 이미지와 없는 이미지를 요청한다
터미널 A. 테스트의 첫 이미지 test-0000은 라벨이 빈 음성 표본이고 test-0001에는 카드가 있다.
foreach ($name in "test-0000", "test-0001") {
    $body = @{ image_path = "$W\data\cards\images\test\$name.png" } | ConvertTo-Json
    Invoke-RestMethod http://127.0.0.1:8002/predict/cards -Method Post -ContentType application/json -Body $body | ConvertTo-Json -Depth 6
}
Get-Content "$W\data\cards\labels\test\test-0001.txt"
실제 출력:
{
  "image_path": ".ml-labs\\book-01\\data\\cards\\images\\test\\test-0000.png",
  "detected": false,
  "box_xyxy": null,
  "backend": "yolov8"
}
{
  "image_path": ".ml-labs\\book-01\\data\\cards\\images\\test\\test-0001.png",
  "detected": true,
  "box_xyxy": [
    28.966873168945312,
    14.083757400512695,
    82.9388427734375,
    62.413665771484375
  ],
  "backend": "yolov8"
}
0 0.433594 0.296875 0.429688 0.375000
라벨을 128픽셀 좌표로 바꾸면 x 28.083.0, y 14.062.0으로 예측 상자와 거의 겹친다. 브라우저 C의 http://127.0.0.1:8002/docs에서도 같은 요청을 보낼 수 있다.
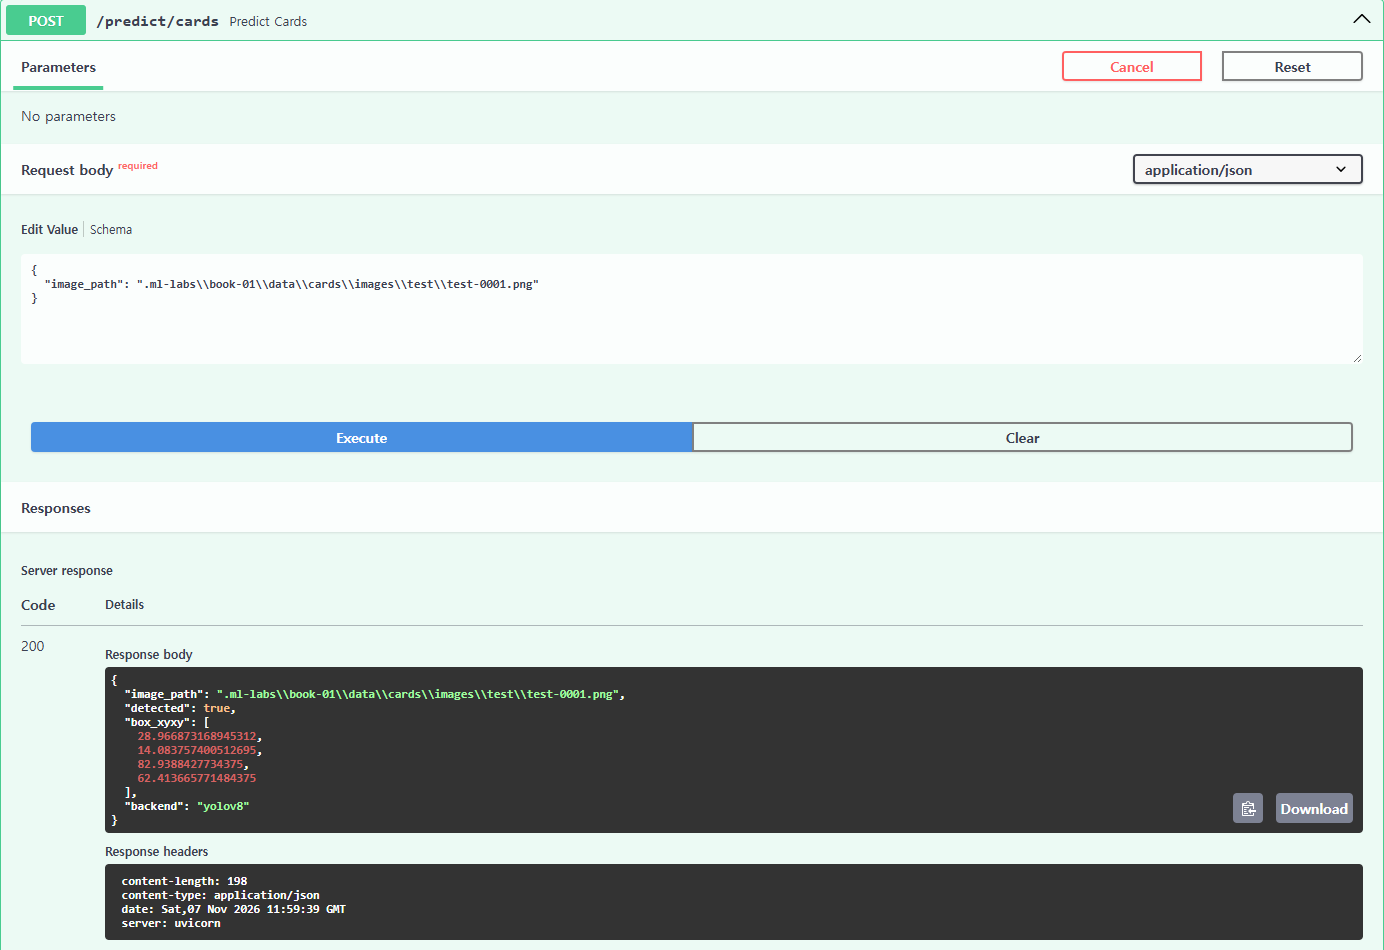
이 엔드포인트는 이미지를 업로드받지 않고, 서버가 도는 컴퓨터의 파일 경로를 읽는다. 로컬 실습용이라 경로 입력을 다른 호스트나 공개 서비스에 그대로 열면 안 된다. 확인했으면 터미널 B2에서 Ctrl+C로 탐지 서버만 끈다.
완료 확인
- 추천 응답의
release_id가release show의 값과 같다. - 실패 주입 뒤 게시 파일이 없고, 재실행 두 번째에
reused: true가 나온다. - 같은 업무 키에 다른 입력을 넘기면 거절된다.
- 탐지 응답의
backend가yolov8이고 음성 표본에서는box_xyxy가null이다.
11장. 서비스 상태와 데이터 변화를 따로 관측한다
서버가 잘 응답하는지, 들어오는 데이터가 변했는지, 장애에서 복구됐는지는 각각 다른 질문이다. 그래서 셋을 따로 확인한다.
11-1. /metrics의 요청 카운터를 확인한다
터미널 A, 10장의 추천 서버(8000번)가 켜진 상태.
(Invoke-WebRequest http://127.0.0.1:8000/metrics).Content -split "`n" | Select-String "ml_labs_inference_requests_total\{|ml_labs_inference_seconds_count"
$body = @{ user_id = "new-user" } | ConvertTo-Json
Invoke-RestMethod http://127.0.0.1:8000/recommend -Method Post -ContentType application/json -Body $body | Out-Null
(Invoke-WebRequest http://127.0.0.1:8000/metrics).Content -split "`n" | Select-String "ml_labs_inference_requests_total\{|ml_labs_inference_seconds_count"
실제 출력:
ml_labs_inference_requests_total{status="success",task="movies"} 2.0
ml_labs_inference_seconds_count{task="movies"} 2.0
ml_labs_inference_requests_total{status="success",task="movies"} 3.0
ml_labs_inference_seconds_count{task="movies"} 3.0
요청 하나를 보내자 두 카운터가 2에서 3으로 올랐다. 전체 응답에는 ml_labs_inference_seconds_bucket 같은 지연 히스토그램도 있다. 이 지표를 실제로 수집해 대시보드와 경보로 잇는 Prometheus, Grafana, Alertmanager 구성은 11장 실습 기록에서 다룬다. 확인했으면 터미널 B의 추천 서버를 Ctrl+C로 끈다.
11-2. 분포가 바뀐 비교 파일로 드리프트를 계산한다
터미널 A, tools 환경. 원본 데이터는 바꾸지 않고 기준(reference)과 현재(current) 파일을 따로 만든다. 현재 파일은 평점을 모두 1.0으로 바꿔 분포를 일부러 무너뜨린다.
$env:UV_PROJECT_ENVIRONMENT = ".ml-labs\book-env-tools"
uv run --locked --extra monitor python -c "import sys,pandas as pd; d=pd.read_csv(sys.argv[1]); d[['rating']].to_csv(sys.argv[2],index=False); d['rating']=1.0; d[['rating']].to_csv(sys.argv[3],index=False)" "$W\data\movies\ratings.csv" "$W\reference.csv" "$W\current.csv"
uv run --locked --extra monitor ml-labs tools drift --reference "$W\reference.csv" --current "$W\current.csv" --output "$W\reports\drift.json" --backend evidently
Get-Content "$W\reports\drift.json" -TotalCount 12
실제 출력(NumPy 경고 생략):
{
  "backend": "evidently",
  "html_report": ".ml-labs\\book-01\\reports\\drift.html",
  "json_report": ".ml-labs\\book-01\\reports\\drift.json",
  "reference_rows": 864,
  "current_rows": 864,
  "monitoring_note": "Drift is a signal, not proof of model failure."
}
{
  "metrics": [
    {
      "metric": "DatasetDriftMetric",
      "result": {
        "drift_share": 0.5,
        "number_of_columns": 1,
        "number_of_drifted_columns": 1,
        "share_of_drifted_columns": 1.0,
        "dataset_drift": true
      }
return c / c 같은 NumPy 경고는 현재 분포의 분산이 0이라 생기며 결과에는 영향이 없다.
11-3. Evidently 보고서를 연다
브라우저 C.
Start-Process "$W\reports\drift.html"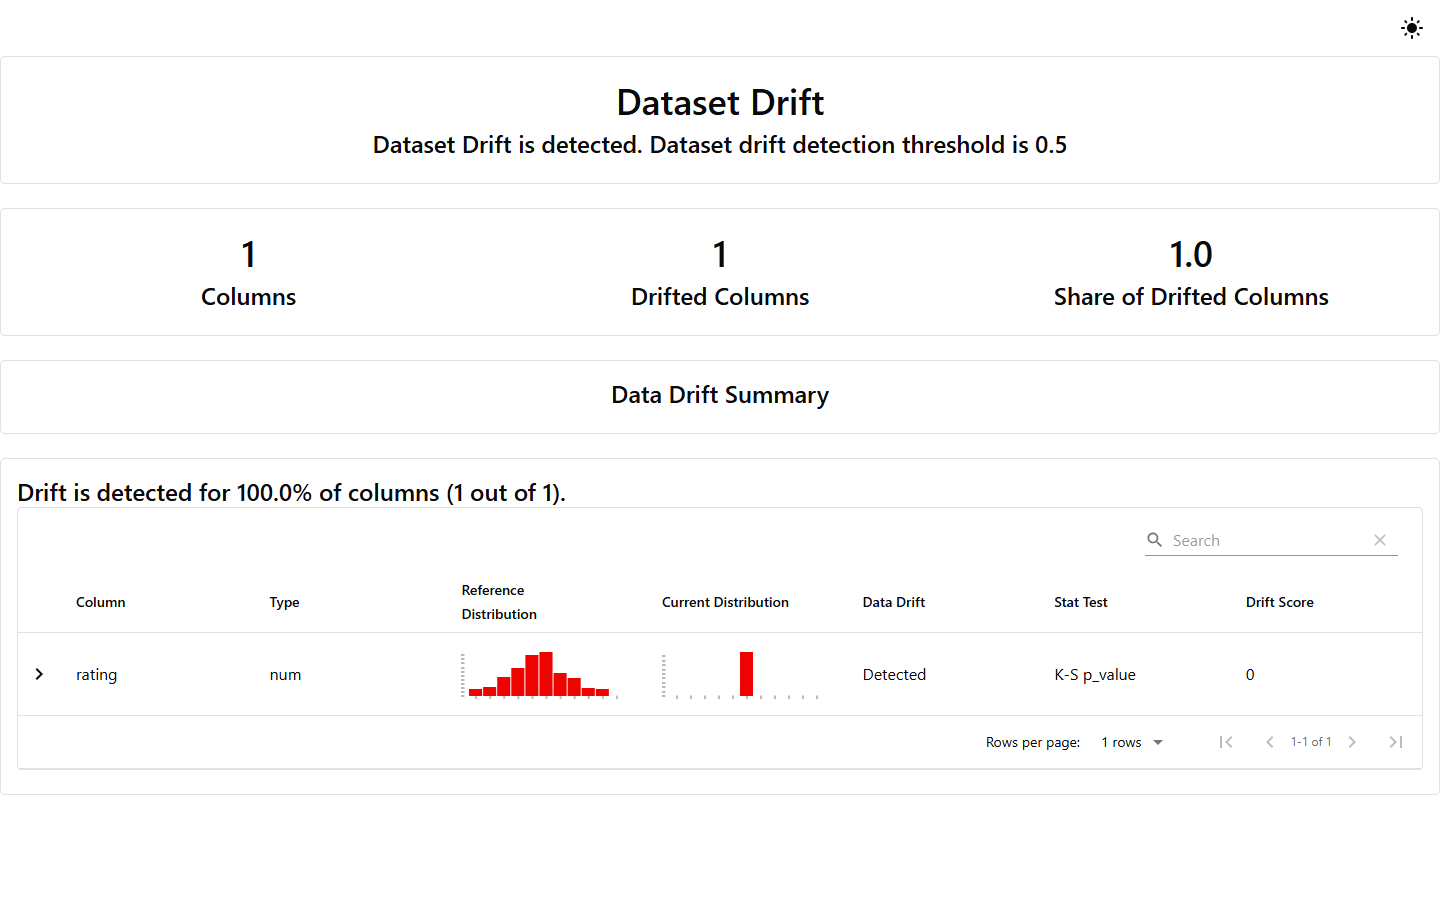
보고서는 Evidently 0.4.40이 실제로 계산한 것이다. 입력 분포가 변했다고 모델 정확도가 떨어졌다는 뜻은 아니므로, 드리프트를 곧바로 자동 재학습에 묶지 않는다. 먼저 정답 레이블, 수집 오류, 업무 영향을 확인한다.
11-4. 피처 장애, 배치 재시도와 출시 복구를 한 번에 재연한다
터미널 A, tools 환경. 통합 실험 하나가 새 폴더에서 네 가지를 이어서 돌린다. Feast 피처 공급 전후의 요청, 배치 재시도, 출시 교체와 복구, 드리프트 보고서다. 증거는 evidence.json에 남는다.
uv run --locked --extra dev --extra feast --extra monitor ml-labs exercise --work "$W\integrated"
$evidence = Get-Content "$W\integrated\evidence.json" -Raw | ConvertFrom-Json
$evidence.feature_failure_http
$evidence.feature_recovery.status
$evidence.batch.retried.reused
$evidence.releases | ConvertTo-Json
실제 출력(마지막 네 명령):
503
personalized
True
{
  "first": "1fb36b3ba8a00771dc1863f3f60dab5f9b77153a5aab309fd44034fe2d1a4f59",
  "next": "198edac9ab7e89958a7bb0a2d4dad6e332280e99aeecd8318d720372eab95b0e",
  "restored": "1fb36b3ba8a00771dc1863f3f60dab5f9b77153a5aab309fd44034fe2d1a4f59"
}
피처를 공급하기 전에는 HTTP 503, 공급한 뒤에는 개인화 응답이 나온다. 배치 재시도는 앞 결과를 재사용하고, 출시는 다음 버전으로 갔다가 최초 release_id로 돌아온다. 전체 실행은 약 11초다. 실패를 하나씩 직접 주입해 보려면 통합 실험의 개별 단계를 따른다.
완료 확인
- 요청 하나에
ml_labs_inference_requests_total이 1 늘어난다. -
drift.json의dataset_drift가true이고 HTML 보고서가 열린다. -
evidence.json에서 503,personalized,True,first와restored가 같은 값이 나온다.
책의 설명가능성과 검사 도구(Eigen-CAM, EMF, Deepchecks)는 이 실행에 들어 있지 않다.
12장. 같은 문서와 설정으로 검색과 응답을 만든다
RAG도 모델처럼 다룬다. 문서, 검색 설정, 프롬프트, 평가 집합을 해시로 묶어 후보 하나로 만들고, 평가를 통과한 후보만 출시 저장소에서 활성화한다.
12-1. 공개 합성 문서와 설정을 만든다
터미널 A, 기본 환경.
$env:UV_PROJECT_ENVIRONMENT = ".ml-labs\book-env-base"
uv run --locked --extra dev ml-labs rag release init-demo --output "$W\rag\inputs"
Get-Content "$W\rag\inputs\config.json"
Get-Content "$W\rag\inputs\evaluation.json"
실제 출력:
{
  "corpus": ".ml-labs\\book-01\\rag\\inputs\\documents.jsonl",
  "config": ".ml-labs\\book-01\\rag\\inputs\\config.json",
  "prompt": ".ml-labs\\book-01\\rag\\inputs\\prompt.json",
  "evaluation": ".ml-labs\\book-01\\rag\\inputs\\evaluation.json"
}
{"min_score":0.15,"ngram_range":[1,2],"provider":"extractive_offline","retriever":"tfidf","stop_words":"english","top_k":2}
[{"answer_contains":["validation"],"expected_ids":["doc-mlflow-registry"],"id":"registry","query":"model registry champion promotion"},{"answer_contains":["historical"],"expected_ids":["doc-feast"],"id":"features","query":"Feast offline online feature store"},{"id":"unknown","query":"quasar teleportation warranty","unanswerable":true}]
평가 집합은 답해야 할 질문 두 개와 답하지 말아야 할 질문 하나로 이루어진다. 답할 수 없는 질문을 넣어야 근거 없이 답을 지어내는 후보를 걸러낼 수 있다.
12-2. 후보를 만들고 평가한 뒤 활성화한다
터미널 A. 평가 출력은 사례별 응답이 길게 나오므로 Out-Null로 숨기고 보고서의 판정만 읽는다. 오류 메시지는 그대로 보인다.
uv run --locked --extra dev ml-labs rag release create --corpus "$W\rag\inputs\documents.jsonl" --config "$W\rag\inputs\config.json" --prompt "$W\rag\inputs\prompt.json" --evaluation "$W\rag\inputs\evaluation.json" --output "$W\rag\v1"
uv run --locked --extra dev ml-labs rag release evaluate --candidate "$W\rag\v1\candidate.json" --report "$W\rag\v1-report.json" | Out-Null
$LASTEXITCODE
(Get-Content "$W\rag\v1-report.json" -Raw | ConvertFrom-Json).summary | ConvertTo-Json
uv run --locked --extra dev ml-labs rag release activate --store "$W\rag\store" --candidate "$W\rag\v1\candidate.json" --report "$W\rag\v1-report.json"
실제 출력:
{
  "candidate": ".ml-labs\\book-01\\rag\\v1\\candidate.json"
}
0
{
  "baseline_pass_rate": null,
  "cost_usd": 0,
  "input_tokens": null,
  "p95_latency_ms": 0.5670300015481189,
  "pass_rate": 1.0,
  "regressions": []
}
{
  "schema": "ml-labs-rag-release-v1",
  "candidate_id": "2ddd1503bb9756432d1b16e5fe3c8d7dc02ad5bdb1c8405f42572012ed354cca",
  "report_id": "0a93924f947130bf929b1471161db04a433f5edfab1d3e3e3d1d030086addf2b",
  "release_id": "bbe0e50fce4a0e8176aae32e641466553121f3398be34174581529af55879017"
}
release_id 앞부분 bbe0e50f를 적어 둔다. 13장에서 이 값으로 되돌아오는지 본다.
12-3. 근거가 있는 질문과 없는 질문을 비교한다
터미널 A.
uv run --locked --extra dev ml-labs rag release query --store "$W\rag\store" --query "model registry champion promotion"
uv run --locked --extra dev ml-labs rag release query --store "$W\rag\store" --query "quasar teleportation warranty"
실제 출력(지표 일부 생략):
{
  "query": "model registry champion promotion",
  "answer": "[doc-mlflow-registry] A model registry versions named models and supports aliases such as champion. A candidate should pass validation before promotion and deployment.",
  "citations": [ "doc-mlflow-registry" ],
  "retrieved": [ { "id": "doc-mlflow-registry", "title": "Model registry and promotion", "score": 0.42757112043785056, ... } ],
  "abstained": false,
  "citations_valid": true,
  "status": "answered",
  "answer_mode": "extractive_offline",
  "metrics": { "llm_calls": 0, "cost_usd": 0.0, "usage_source": "no_model_called", ... },
  "candidate_id": "2ddd1503bb9756432d1b16e5fe3c8d7dc02ad5bdb1c8405f42572012ed354cca",
  "release_id": "bbe0e50fce4a0e8176aae32e641466553121f3398be34174581529af55879017"
}
{
  "query": "quasar teleportation warranty",
  "answer": "No grounded answer is available in the selected corpus.",
  "citations": [],
  "retrieved": [],
  "abstained": true,
  "citations_valid": true,
  "status": "no_grounding",
  ...
  "release_id": "bbe0e50fce4a0e8176aae32e641466553121f3398be34174581529af55879017"
}
근거가 없는 질문에는 답을 지어내지 않고 no_grounding으로 물러선다. 기본 provider인 extractive_offline은 TF-IDF로 찾은 문장을 그대로 인용할 뿐 LLM을 부르지 않는다(llm_calls: 0). 책의 Gemini, FAISS, LangChain, Chainlit 구성은 12장 실습 기록에서 로컬 모델로 실행했다.
12-4. 실제 생성 모델 연결은 선택 경로로 남긴다
Azure OpenAI로 실제 답을 생성하는 독립 경로는 RAG 출시 가이드의 생성 연결에 있다. 기존 endpoint, 배포 이름, 인증과 예산이 필요하고, 책이 쓰는 Gemini와도 다른 도구다. 이 가이드를 검증할 때는 외부 생성 요청을 보내지 않았다.
생성 모드를 켜면 두 가지를 본다. 고정한 검색 결과와 프롬프트가 실제 요청에 들어갔는지, 인용이 검색된 문서 안에 있는지다. 형식 검사는 답변의 주장이 사실인지까지 확인하지 않는다.
완료 확인
- v1 평가의
pass_rate가 1.0이다. - 첫 질문은
answered와 인용 하나, 두 번째는no_grounding과 빈 인용이다. - 두 응답의
release_id가 활성화 출력과 같다.
13장. 변경을 평가하고 출시를 거절하거나 되돌린다
12장에서 출시한 v1을 HTTP 서버에 연결해 두고 세 가지 변경을 차례로 겪어 본다. 나쁜 변경은 거절되고, 좋은 변경은 활성화되고, 필요하면 이전 출시로 돌아간다. 매번 확인하는 곳은 보고서가 아니라 실제 HTTP 응답이다.
13-1. RAG 서버를 켜고 현재 출시를 확인한다
터미널 B, 기본 환경. 이 서버는 요청마다 활성 스냅샷을 다시 읽는다. 시작할 때 모델을 고정하는 10장의 추천 서버와 다르다.
Set-Location $HOME\ml-labs-book\ml-platform-engineering-labs
$W = ".ml-labs\book-01"
$env:UV_PROJECT_ENVIRONMENT = ".ml-labs\book-env-base"
Remove-Item Env:MLFLOW_TRACKING_URI -ErrorAction SilentlyContinue
uv run --locked --extra dev ml-labs serve --rag-release "$W\rag\store" --host 127.0.0.1 --port 8003
터미널 A. 뒤에서 계속 쓸 확인 함수를 만든다.
function Show-RagRelease {
    $body = @{ query = "model registry champion promotion" } | ConvertTo-Json
    Invoke-RestMethod http://127.0.0.1:8003/rag/query -Method Post -ContentType application/json -Body $body |
        Select-Object status, release_id, candidate_id, @{ n = "citations"; e = { $_.citations -join "," } } |
        Format-List
}
Show-RagRelease
실제 출력:
status       : answered
release_id   : bbe0e50fce4a0e8176aae32e641466553121f3398be34174581529af55879017
candidate_id : 2ddd1503bb9756432d1b16e5fe3c8d7dc02ad5bdb1c8405f42572012ed354cca
citations    : doc-mlflow-registry
브라우저 C의 http://127.0.0.1:8003/docs에서 POST /rag/query에 같은 질문을 보내면 전체 응답과 끝의 release_id를 볼 수 있다.
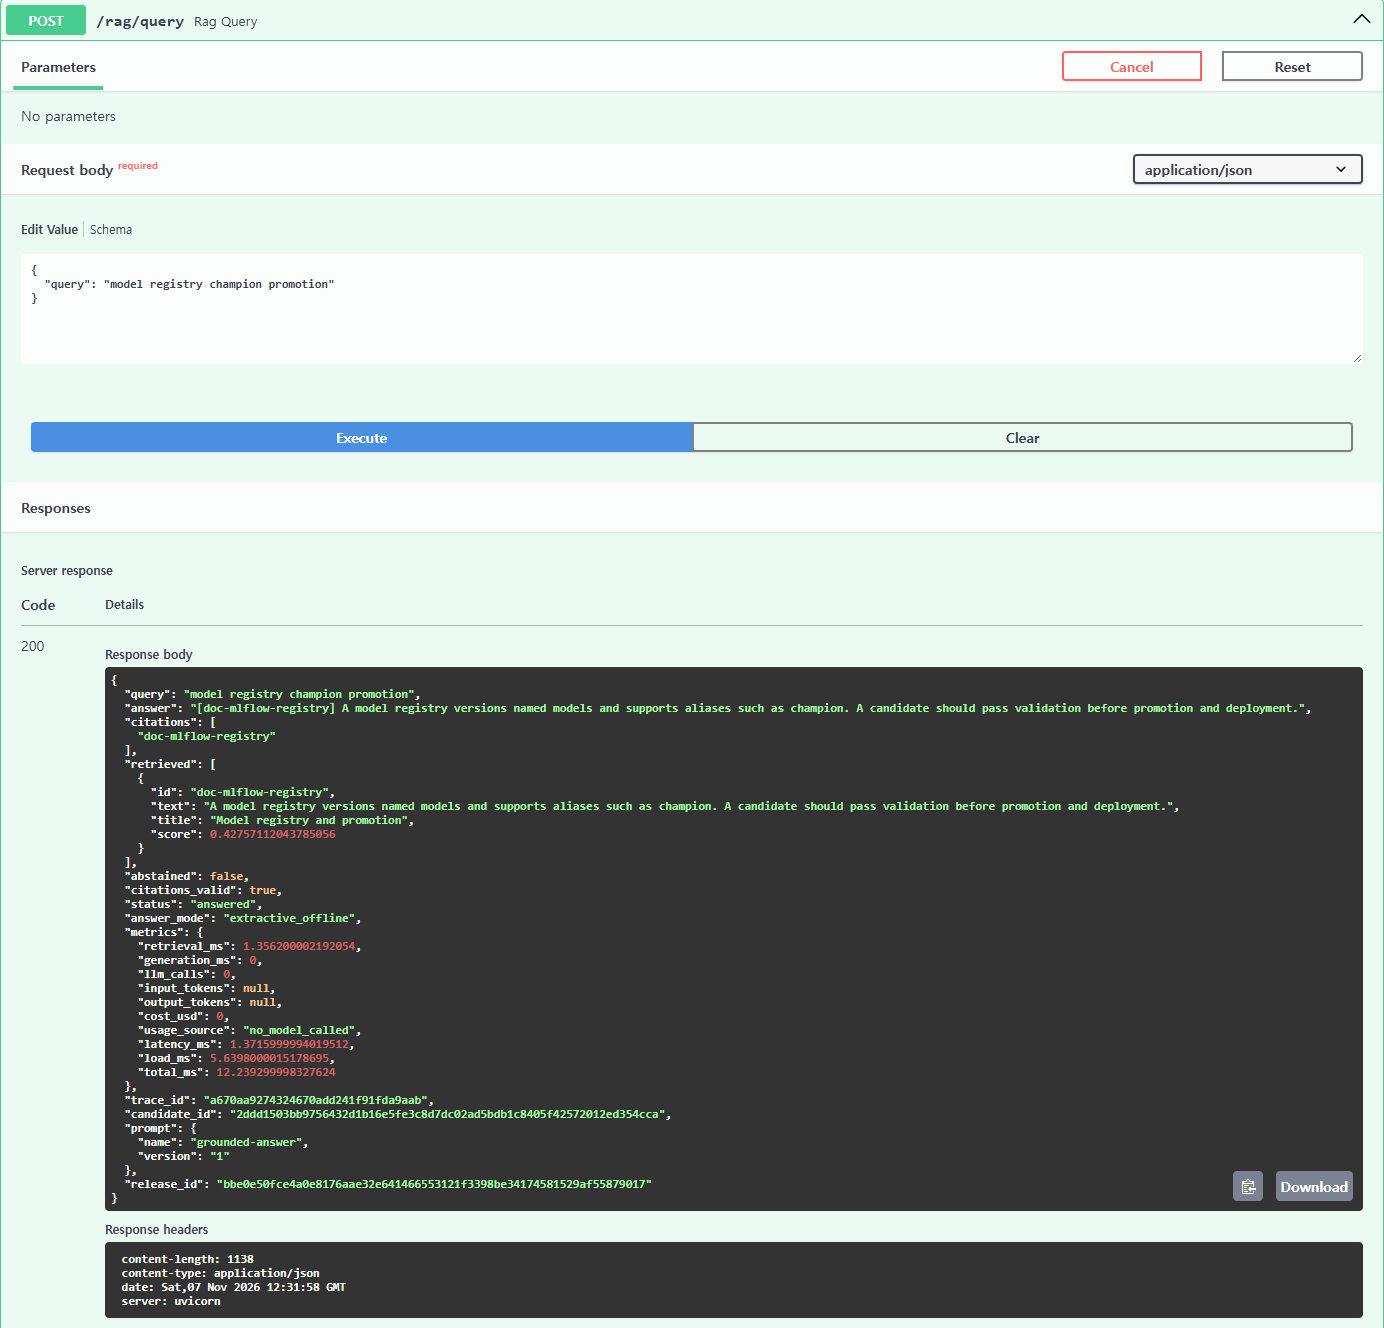
13-2. 검색 임계치를 잘못 올린 후보는 거절된다
터미널 A, 기본 환경. 원본 v1은 그대로 두고 min_score를 1.0으로 올린 후보를 만든다. 통과율 기준을 0.3으로 느슨하게 잡아도, v1이 답하던 사례를 잃으면 회귀 게이트(--max-regression 0)가 막는다.
$badConfig = Get-Content "$W\rag\inputs\config.json" -Raw | ConvertFrom-Json
$badConfig.min_score = 1.0
$badConfig | ConvertTo-Json -Depth 10 | Set-Content "$W\rag\bad-config.json" -Encoding utf8
uv run --locked --extra dev ml-labs rag release create --corpus "$W\rag\inputs\documents.jsonl" --config "$W\rag\bad-config.json" --prompt "$W\rag\inputs\prompt.json" --evaluation "$W\rag\inputs\evaluation.json" --output "$W\rag\bad"
uv run --locked --extra dev ml-labs rag release evaluate --candidate "$W\rag\bad\candidate.json" --baseline "$W\rag\v1\candidate.json" --min-pass-rate 0.3 --max-regression 0 --report "$W\rag\bad-report.json" | Out-Null
$LASTEXITCODE
(Get-Content "$W\rag\bad-report.json" -Raw | ConvertFrom-Json).summary | ConvertTo-Json
uv run --locked --extra dev ml-labs rag release activate --store "$W\rag\store" --candidate "$W\rag\bad\candidate.json" --report "$W\rag\bad-report.json"
$LASTEXITCODE
Show-RagRelease
실제 출력:
{
  "candidate": ".ml-labs\\book-01\\rag\\bad\\candidate.json"
}
ml-labs: error: RAG release gate failed; report: .ml-labs\book-01\rag\bad-report.json
2
{
  "baseline_pass_rate": 1.0,
  "cost_usd": 0,
  "input_tokens": null,
  "p95_latency_ms": 0.6132099995738827,
  "pass_rate": 0.3333333333333333,
  "regressions": [
    "registry",
    "features"
  ]
}
ml-labs: error: RAG release gate failed; activation refused.
2

status       : answered
release_id   : bbe0e50fce4a0e8176aae32e641466553121f3398be34174581529af55879017
candidate_id : 2ddd1503bb9756432d1b16e5fe3c8d7dc02ad5bdb1c8405f42572012ed354cca
citations    : doc-mlflow-registry
통과율 0.33은 기준 0.3을 넘는다. 그런데 v1이 답하던 registry, features 두 사례를 잃어 회귀 게이트에 걸렸다. 평균만 봤다면 통과했을 후보다. 활성화도 거절되고 HTTP 응답은 그대로 v1(bbe0e50f)이다.
13-3. 정상 변경을 평가하고 활성화한다
터미널 A. top_k를 3으로 늘린 v2를 만들고 v1을 기준으로 평가한다.
$v2Config = Get-Content "$W\rag\inputs\config.json" -Raw | ConvertFrom-Json
$v2Config.top_k = 3
$v2Config | ConvertTo-Json -Depth 10 | Set-Content "$W\rag\v2-config.json" -Encoding utf8
uv run --locked --extra dev ml-labs rag release create --corpus "$W\rag\inputs\documents.jsonl" --config "$W\rag\v2-config.json" --prompt "$W\rag\inputs\prompt.json" --evaluation "$W\rag\inputs\evaluation.json" --output "$W\rag\v2"
uv run --locked --extra dev ml-labs rag release evaluate --candidate "$W\rag\v2\candidate.json" --baseline "$W\rag\v1\candidate.json" --report "$W\rag\v2-report.json" | Out-Null
$LASTEXITCODE
uv run --locked --extra dev ml-labs rag release activate --store "$W\rag\store" --candidate "$W\rag\v2\candidate.json" --report "$W\rag\v2-report.json"
Show-RagRelease
실제 출력:
{
  "candidate": ".ml-labs\\book-01\\rag\\v2\\candidate.json"
}
0
{
  "schema": "ml-labs-rag-release-v1",
  "candidate_id": "6c6f8ff9ba9ab661af59a6a11fbf8619b0ed244c885245675fe034820b35f82d",
  "report_id": "761e2bff9c666bc49fda865c6884afa8dc0346c76a59be270334f6efdf5929d3",
  "release_id": "4dd49e008aa1847487f340a458a89bace725d6a8290b223e8fc6374f06c56c01"
}

status       : answered
release_id   : 4dd49e008aa1847487f340a458a89bace725d6a8290b223e8fc6374f06c56c01
candidate_id : 6c6f8ff9ba9ab661af59a6a11fbf8619b0ed244c885245675fe034820b35f82d
citations    : doc-mlflow-registry
서버를 다시 시작하지 않았는데도 HTTP 응답의 release_id가 4dd49e00으로 바뀌었다.
13-4. 이전 출시로 되돌린다
터미널 A.
uv run --locked --extra dev ml-labs rag release rollback --store "$W\rag\store"
Show-RagRelease
실제 출력:
{
  "candidate_id": "2ddd1503bb9756432d1b16e5fe3c8d7dc02ad5bdb1c8405f42572012ed354cca",
  "release_id": "bbe0e50fce4a0e8176aae32e641466553121f3398be34174581529af55879017",
  "report_id": "0a93924f947130bf929b1471161db04a433f5edfab1d3e3e3d1d030086addf2b",
  "schema": "ml-labs-rag-release-v1"
}

status       : answered
release_id   : bbe0e50fce4a0e8176aae32e641466553121f3398be34174581529af55879017
candidate_id : 2ddd1503bb9756432d1b16e5fe3c8d7dc02ad5bdb1c8405f42572012ed354cca
citations    : doc-mlflow-registry
응답이 v1의 bbe0e50f로 돌아왔다. 후보의 점수가 좋다는 것과 서버가 실제로 그 후보로 응답한다는 것은 별개의 증거다. 확인했으면 터미널 B에서 Ctrl+C로 서버를 끈다.
13-5. Promptfoo로 활성 후보를 직접 호출해 검사한다
터미널 A, 기본 환경. Promptfoo 설정은 v1 후보를 실제로 호출하는 Python provider를 가리킨다. 따로 만든 예제 프롬프트가 아니라 출시 후보 자체를 검사하는 셈이다. PROMPTFOO_CONFIG_DIR을 실습 폴더로 두면 결과 DB가 다른 프로젝트와 섞이지 않는다.
uv run --locked --extra dev ml-labs tools promptfoo release-config --candidate "$W\rag\v1\candidate.json" --output "$W\rag\promptfoo.yaml"
$env:PROMPTFOO_PYTHON = (Resolve-Path "$env:UV_PROJECT_ENVIRONMENT\Scripts\python.exe").Path
$env:PROMPTFOO_DISABLE_TELEMETRY = "1"
$env:PROMPTFOO_CONFIG_DIR = Join-Path (Resolve-Path $W).Path "promptfoo-home"
npm exec --yes --package=promptfoo@0.125.0 -- promptfoo eval --config "$W\rag\promptfoo.yaml" --no-cache --output "$W\rag\promptfoo-results.json"
실제 출력(버전 안내 상자 생략):
{
  "config": ".ml-labs\\book-01\\rag\\promptfoo.yaml"
}
Cache is disabled.
Starting evaluation eval-JnZ-2026-11-07T12:33:01
Running 3 test cases (up to 4 at a time)...

┌────────────────────────────────────────────────────────────┬────────────────────────────────────────────────────────────┐
│ query                                                      │ [file://C:\Users\<사용자>\...\ml-platform-engineering-labs… │
│                                                            │ {{query}}                                                  │
├────────────────────────────────────────────────────────────┼────────────────────────────────────────────────────────────┤
│ model registry champion promotion                          │ [PASS] {"query": "model registry champion promotion",      │
│                                                            │ "answer": "[doc-mlflow-registry] A model registry versions │
│                                                            │ named models and supports aliases such as champion. A      │
│                                                            │ candidate should pass validation before promotion and      │
│                                                            │ deployment.", "citations": ["doc-...                       │
├────────────────────────────────────────────────────────────┼────────────────────────────────────────────────────────────┤
│ Feast offline online feature store                         │ [PASS] {"query": "Feast offline online feature store",     │
│                                                            │ "answer": "[doc-feast] Feast separates feature definitions │
│                                                            │ from materialized feature values. An offline store         │
│                                                            │ supports historical training retrieval and an online store │
│                                                            │ serves low-latency latest valu...                          │
├────────────────────────────────────────────────────────────┼────────────────────────────────────────────────────────────┤
│ quasar teleportation warranty                              │ [PASS] {"query": "quasar teleportation warranty",          │
│                                                            │ "answer": "No grounded answer is available in the selected │
│                                                            │ corpus.", "citations": [], "retrieved": [], "abstained":   │
│                                                            │ true, "citations_valid": true, "status": "no_grounding",   │
│                                                            │ "answer_mode": "extractive_offl...                         │
└────────────────────────────────────────────────────────────┴────────────────────────────────────────────────────────────┘
✓ Eval complete (ID: eval-JnZ-2026-11-07T12:33:01)

Results:
  ✓ 3 passed (100%)
  0 failed (0%)
  0 errors (0%)
Duration: 2s (concurrency: 4)

Writing output to .ml-labs\book-01\rag\promptfoo-results.json
처음 실행하면 npm이 promptfoo 패키지를 내려받는다. 로컬 인용 후보이므로 유료 생성 API는 호출하지 않는다.
13-6. Promptfoo 화면에서 사례별 결과를 본다
터미널 B, 같은 환경 변수. 결과 화면 서버를 켠다. --no는 브라우저를 자동으로 열지 않는다는 뜻이다.
$env:PROMPTFOO_DISABLE_TELEMETRY = "1"
$env:PROMPTFOO_CONFIG_DIR = Join-Path (Resolve-Path $W).Path "promptfoo-home"
npm exec --yes --package=promptfoo@0.125.0 -- promptfoo view --port 15500 --no
브라우저 C. http://127.0.0.1:15500을 연다. 세 사례가 모두 PASS이고 각 출력에 인용과 상태가 보인다.
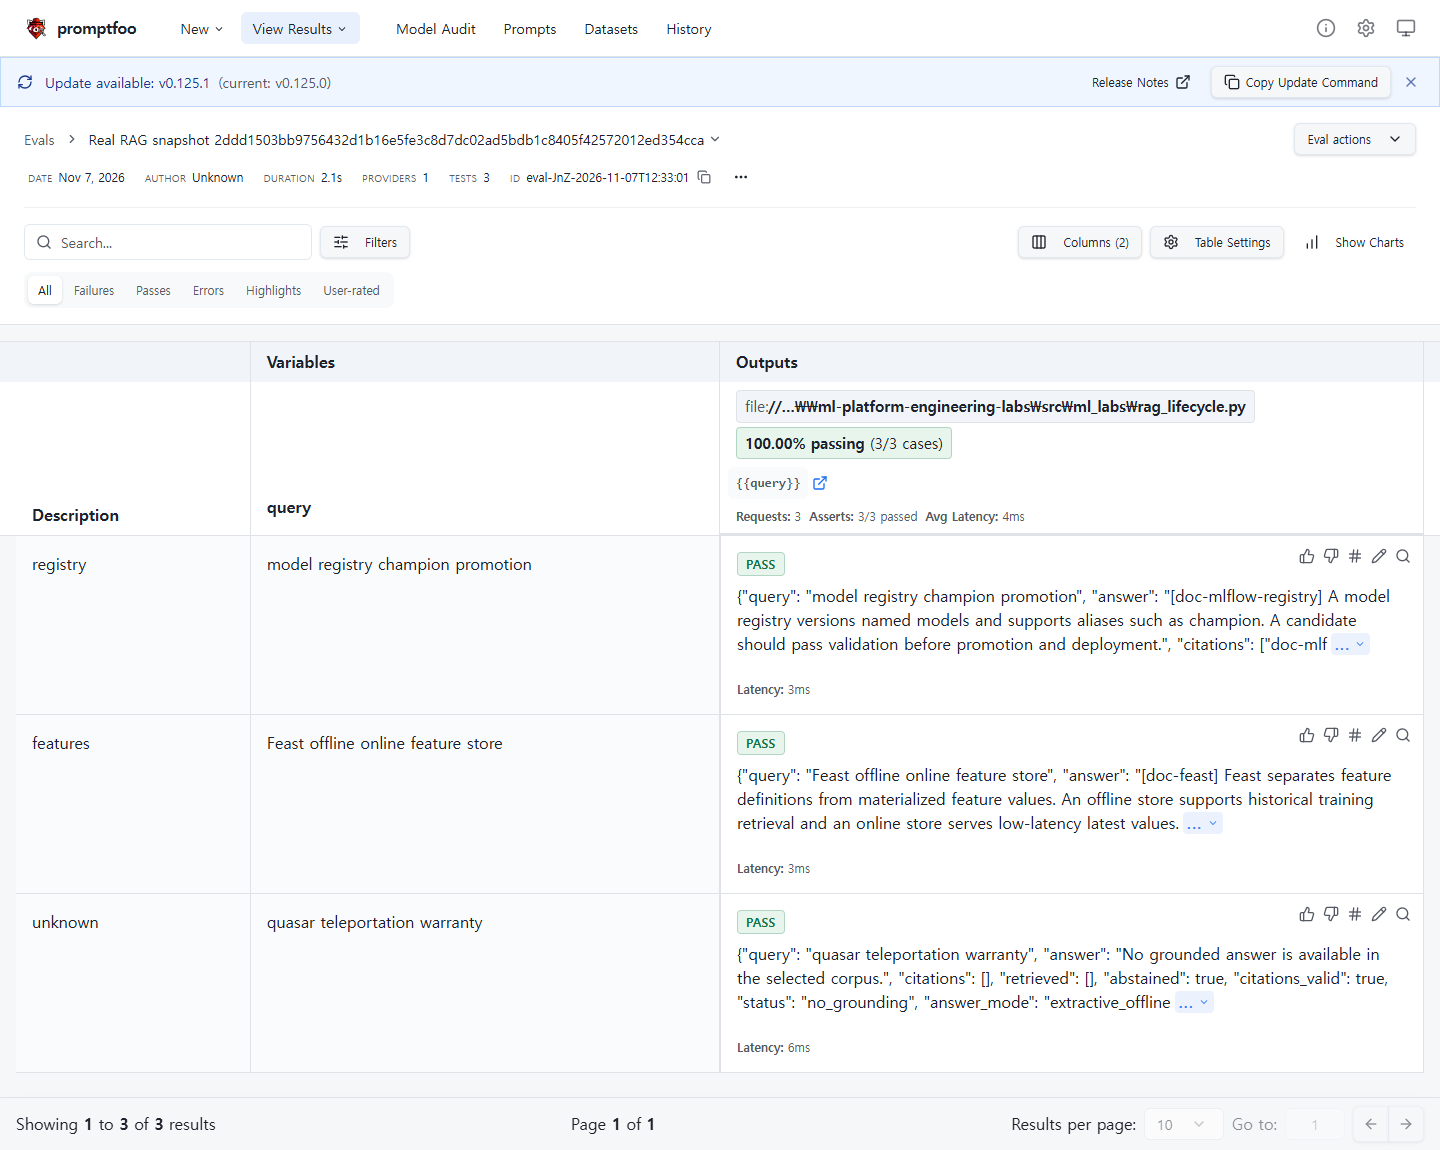
확인했으면 Ctrl+C로 끈다. Promptfoo 결과는 보조 자료이고, 출시 판정은 프로젝트의 평가 보고서로 한다.
13-7. DeepEval과 Langfuse는 선택 경로로 남긴다
DeepEval의 의미 평가와 Langfuse 외부 추적은 별도 연결 절차를 따른다. 판정 모델 키와 외부 서비스 계정이 필요해서 이 가이드에서는 돌리지 않았다. 연결한다면 공개 합성 문서와 질문만 보내고, 실제 요청이 성공한 것을 본 뒤에야 연결됐다고 적는다. 의미 캐시, 문서별 권한, 비용 강제 제한은 이 로컬 실행판에 아직 없다. 한 컴퓨터에서 하는 이 실험이 조직 승인, 다중 사용자 권한, 종합적인 LLM 안전성 평가를 대신하지도 못한다.
완료 확인
- 나쁜 후보는 평가와 활성화가 모두 종료 코드 2로 실패하고 HTTP 응답이 v1에 머문다.
- v2 활성화 직후 HTTP
release_id가 바뀌고, rollback 뒤 v1 값으로 돌아온다. - Promptfoo가
3 passed (100%)다.
구현과 검증 범위
기준은 공개 코드의 고정 커밋과 클러스터 저장소다. 책의 명령 순서를 그대로 옮기지 않고, 독립 구현과 책의 실행 참조를 이어 붙였다. 표의 가운데 열은 2026년 11월 7일 새 작업 폴더 .ml-labs\book-01에서 이 문서의 명령으로 직접 확인한 결과다.
| 구간 | 이 판에서 실행으로 확인한 것 | 실행하지 않았거나 책 전체 실습 완료에 남은 것 |
|---|---|---|
| 준비, 1장 | 도구 버전 확인, uv 환경 4개 uv sync --locked, CLI 실행 | winget 설치 명령과 git clone은 이미 설치된 도구와 같은 커밋의 기존 사본으로 대신했다 |
| 2장 | smoke의 세 프로젝트 학습, 평가, 등록 | 조직별 책임과 운영 승인 체계 |
| 3장 | Docker 엔진, kind, kubectl, bookenv.py check, status, 포트포워딩된 KFP 접속 | bookenv.py up은 같은 스크립트로 미리 만든 클러스터를 재사용해 다시 실행하지 않았다. 전체 Kubeflow, Notebooks |
| 4장 | 추천 학습, 평가, 거절, 등록, MLflow 화면, 실제 Feast 정의 등록, 과거 조회, 적재 전후 온라인 조회 | 책의 소득 분류 노트북(별도 실행 참조), Redis 온라인 저장소 |
| 5장 | KFP 컴파일, 컴포넌트 본문 검사, 이미지 빌드, kind load, KFP 2.4.1 클러스터 run 성공과 그래프, 지표, 로그 | 컴포넌트에서 클러스터 MLflow와 S3로 기록하는 구성, GitLab CI와 Argo CD 전체 경로 |
| 6장 | FastAPI 개인화와 콜드스타트 응답, BentoML 가져오기, Bento 생성, HTTP 응답(포트 3010) | bentoml containerize, Yatai 또는 선택 배포 관리자의 클러스터 출시 |
| 7~9장 | 합성 카드와 MovieLens 가져오기, 색상 기준선, CPU YOLO 10 epoch 학습과 평가, 등록, 비전 재로딩 테스트, 검증 기반 추천 후보 선택과 등록 | 원본 데이터 전체, 책의 학습 알고리즘과 대규모 처리, 표준 mAP 기반 정책 |
| 10~11장 | 출시 기록 기반 추천 서버, 배치 실패 주입과 멱등 재시도, 업무 키 충돌 거절, YOLO 탐지 HTTP, /metrics, Evidently 보고서, 통합 실험 증거 | KServe, Prometheus와 Grafana 운영 스택, Deepchecks, Eigen-CAM과 EMF |
| 12~13장 | RAG 후보 생성, 평가, 활성화, 근거 없음 응답, 회귀 후보 거절, HTTP에서 재시작 없는 활성화와 복구, Promptfoo eval과 view | 외부 LLM 생성(Azure OpenAI, Gemini), DeepEval, Langfuse, FAISS, LangChain, Chainlit 원본 경로, 권한과 캐시, 비용 제한 |
같은 날 기본 환경에서 돌린 실습 저장소 전체 테스트(pytest -q)는 54개 통과, 8개 건너뜀이었다. 건너뛴 8개는 선택 도구가 필요한 테스트라 검증 결과에 넣지 않았다. 카드 탐지와 RAG 결과는 합성 카드와 공개 합성 문서에서 얻은 것이라, 실제 촬영 이미지나 업무 문서에서는 다시 평가해야 한다.
다시 돌려 보며 막힌 다섯 곳은 본문에 해결책을 반영했다. KFP 2.4.1 백엔드에서는 평가 작업 driver가 표시 이름 때문에 실패해서 5-5의 YAML 정규화 단계를 넣었다. BentoML 기본 저장소는 다른 프로세스가 잠그고 있어서 BENTOML_HOME을 실습 폴더로 분리했다. Invoke-RestMethod 출력은 중첩 응답이 그대로 보이도록 ConvertTo-Json을 붙인다. 첫 테스트 이미지가 음성 표본이라 탐지 요청은 카드가 있는 이미지와 함께 보낸다. MovieLens는 저장소 최상위가 아니라 $W\downloads에 받는다.
다음 날 다시 시작하고 정리하기
기존 $W에서 이어 갈 때는 이미 만든 데이터와 후보를 덮어쓰지 않는다. 지금 단계의 입력 파일, 등록 버전, 보고서가 있는지 본 뒤 다음 명령부터 이어 간다. 새 실험이라면 작업 경로를 새로 잡는다.
Set-Location $HOME\ml-labs-book\ml-platform-engineering-labs
$W = ".ml-labs\book-01"
Get-ChildItem $W | Select-Object Name
git rev-parse HEAD
$env:UV_PROJECT_ENVIRONMENT = ".ml-labs\book-env-base"
uv run --locked --extra dev pytest -q -p no:warnings
실제 출력(마지막 줄):
54 passed, 8 skipped in 19.99sAPI와 UI는 각 터미널에서 Ctrl+C로 끈다. 포트포워딩을 끈다고 클러스터가 사라지지는 않는다. 클러스터까지 지우려면 ml-platform-book-env에서 uv run --no-project --python 3.12 python bookenv.py down을 실행한다. kind 클러스터 안의 실행 기록과 저장소 데이터가 모두 지워지므로, 다른 사람과 함께 쓰는 클러스터에서는 실행하지 않는다. Tracking DB나 아티팩트 한쪽만 지우면 실습 결과와 모델의 연결이 끊기니, 연결을 확인하기 전에는 따로 지우지 않는다.