03. 문서 요약
긴 문서의 요약은 문장을 줄이는 문제이면서 정보를 어떻게 나누고 다시 합칠지 정하는 문제다. 모델에 한 번에 넣을 수 없는 자료라면 분할이 필요하고, 분할하는 순간 조각 사이의 관계가 약해질 수 있다.
3.1 문맥 창보다 긴 문서
문맥 창에는 문서뿐 아니라 지침과 생성할 응답도 들어간다. 문서가 모델의 최대 입력 길이보다 짧아도 대화나 출력 예산을 포함하면 넘칠 수 있다. 모든 문서를 프롬프트에 넣는 방식은 단순하지만 길이와 비용, 모델의 정보 활용 능력을 함께 확인해야 한다.
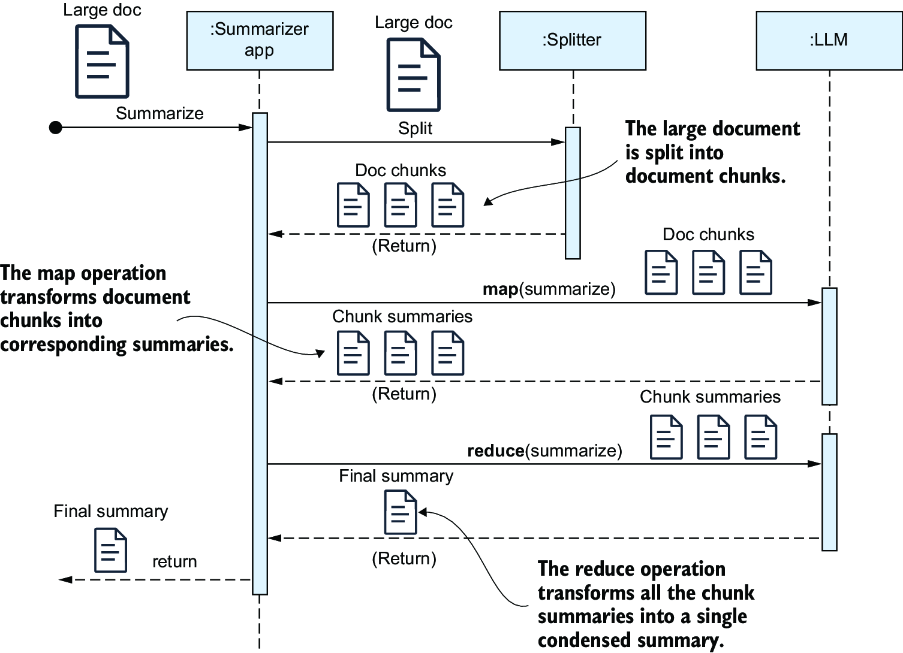
그림의 Split은 텍스트를 나누는 작업이다. Map에서 실제 모델 호출이 청크마다 발생하고, Reduce에서도 모델을 호출해 여러 요약을 통합한다. 파일 하나를 처리한다고 모델 호출도 한 번인 것은 아니다.
3.1.1 Document와 청크
Document는 본문과 메타데이터를 가진다. 문서를 나눈 뒤에도 출처와 원래 위치를 알 수 있어야 요약문이 어떤 부분에서 나온 것인지 확인할 수 있다.
청크는 요약 모델이 처리할 입력 단위다. 문자 수로 나누는 것과 토큰 수로 나누는 것은 다르다. 언어와 인코더에 따라 같은 길이의 문장도 토큰 수가 달라지므로, 모델의 문맥 예산을 관리하려면 실제 토큰 기준이 필요하다.
너무 작은 청크는 정의와 예시, 주장과 조건을 다른 조각으로 나눌 수 있다. 너무 큰 청크는 호출당 비용이 커지고 중요한 세부 내용을 놓치기 쉽다. 분할 크기는 단순한 성능 파라미터가 아니라 보존할 의미의 단위를 결정한다.
3.1.2 Split
책은 텍스트를 나누는 함수를 RunnableLambda로 감싸 체인의 실행 단위로 만든다. 앞 단계에서 받은 문자열을 청크 목록으로 바꾸는 구조다.
이 단계는 보통 모델 생성이 아니라 결정적인 텍스트 처리다. 문서 길이와 청크 수, 중첩 구간을 확인할 수 있어야 한다. 경계에 걸친 내용을 보존하려고 overlap을 두면 중복 처리량도 늘어난다.
문서 제목이나 페이지, 절 정보가 분할 과정에서 사라지면 이후 요약의 출처도 약해진다. 본문 조각만 남길지 위치를 포함한 객체로 전달할지 정해야 한다.
3.1.3 Map
Map은 각 청크에 같은 작업을 적용한다. 청크마다 주요 주장과 세부 내용을 뽑아 부분 요약을 만든다.
독립 처리라서 병렬화하기 쉽지만, 한 청크는 다른 청크를 모른다. 앞부분의 정의를 뒤에서 수정하거나 예외를 제시하는 문서에서는 각각의 요약이 서로 충돌할 수 있다.
부분 요약의 형식도 중요하다. 원문 위치, 핵심 사실, 수치와 조건을 분리해 남기면 최종 통합에서 비교하기 쉽다. 짧은 문장 하나로 압축하면 그 단계에서 버린 정보를 Reduce가 되살릴 수 없다.
3.1.4 Reduce
Reduce는 부분 요약을 모아 최종 요약을 만든다. 단순 연결과 달리 반복을 제거하고 공통 내용과 차이를 정리한다.
부분 요약을 모은 결과도 문맥 창을 넘을 수 있다. 예를 들어 청크 요약이 100개이고 각 500토큰이면 그것만으로 50,000토큰이다. 한 번에 처리하기 어렵다면 그룹별 중간 요약을 만든 뒤 다시 합치는 계층적 처리가 필요하다.
압축 단계를 늘릴수록 앞 단계의 누락과 오류가 누적될 수 있다. 최종 요약이 자연스럽다는 사실보다 원문의 핵심 사실과 적용 조건이 유지됐는지를 확인해야 한다.
3.1.5 MapReduce 체인
체인은 대체로 다음 형태다.
원문 문자열
  → 청크 목록
  → 각 청크의 부분 요약
  → 부분 요약 결합
  → 최종 요약
LCEL의 .map()은 목록의 각 항목에 같은 Runnable을 적용한다. 동시 실행을 활용할 수 있지만, 실제 병렬성은 실행 설정과 모델 API의 요청 제한에 영향을 받는다. 단순히 .map()을 붙였다고 무제한 호출을 허용하는 것은 아니다.
최종 결과를 해석하는 파서가 어느 단계에 있는지도 확인해야 한다. 부분 요약이 메시지 객체인데 문자열 목록처럼 합치면 모델 본문 외의 객체 표현이 섞일 수 있다.
3.1.6 실행과 비용
원문이 60,000토큰이고 청크를 5,000토큰으로 나누면 중첩을 제외하고 12개가 된다. 청크당 400토큰의 요약을 만들면 Reduce 입력은 약 4,800토큰에 지침 등이 추가된다.
모델 호출은 Map 12회와 Reduce 1회로 최소 13회다. 재시도나 계층적 Reduce가 생기면 더 늘어난다. 원문 길이뿐 아니라 중간 결과의 크기도 비용에 들어간다.
병렬 실행에서 요청 제한 오류가 발생했다면 한 번에 처리하는 개수와 재시도 정책을 조정해야 한다. 실패한 청크를 빈 요약으로 바꾸면 전체 결과는 성공처럼 보여도 일부 원문이 사라진다.
3.2 여러 문서의 요약
여러 문서를 요약할 때는 문서들이 같은 주제의 근거인지, 서로 다른 주제의 독립 자료인지부터 구분해야 한다. 관련 없는 문서를 억지로 하나의 결론으로 묶으면 존재하지 않는 관계를 만들 수 있다.
MapReduce는 문서마다 요약한 뒤 합치는 방식이다. Refine은 앞에서 만든 요약을 다음 문서와 함께 모델에 전달해 조금씩 수정하는 방식이다.
3.2.1 Document 목록 만들기
파일 하나가 반드시 Document 하나가 되는 것은 아니다. 페이지마다 객체를 반환하는 Loader도 있고 한 웹 자료에서 여러 문서를 가져오는 Loader도 있다.
그 결과를 합칠 때 객체 수와 실제 원문 수를 구분해야 한다. 출처가 같은 자료를 여러 번 읽거나 같은 본문이 중복되면 특정 내용의 중요성을 과대평가할 수 있다.
3.2.2 Wikipedia 자료
전용 Loader는 본문 추출과 메타데이터 구성 과정을 줄여 준다. 다만 반환하는 문서 수와 범위가 요청한 제목 하나에만 제한되는지는 설정과 구현을 확인해야 한다.
검색 결과의 관련 문서까지 가져올 수 있다면 자료 범위와 비용이 함께 늘어난다. 모델에 넣기 전에 각 문서의 제목과 출처, 길이를 확인하는 것이 필요하다.
3.2.3 파일 기반 자료
TXT, Word, PDF는 원문을 얻는 과정이 다르다. 줄바꿈, 표, 머리말과 꼬리말, 여러 단의 읽기 순서가 텍스트 추출 결과에 영향을 준다.
모델이 요약에 실패한 것처럼 보여도 실제로는 표의 열 순서가 뒤섞이거나 본문 일부가 누락됐을 수 있다. 추출 단계에서 의미가 깨진 입력을 후속 요약이 완전히 복구해 주리라 기대하면 안 된다.
3.2.4 목록 합치기
다양한 Loader의 결과를 공통 Document 목록으로 합치면 같은 요약 체인에 넣을 수 있다. 공통 자료형을 사용한다는 것과 자료의 품질이 같다는 것은 별개다.
문서 식별자와 원문 위치, 날짜를 유지하면 같은 사실의 중복과 서로 다른 시점의 주장을 구분할 수 있다. 자료의 순서를 정하는 일도 다음 Refine 단계의 동작에 영향을 준다.
3.2.5 Refine
Refine은 첫 문서로 초안을 만들고, 다음 문서와 현재 초안을 함께 보내 수정한다. 이후 문서도 같은 방식으로 처리한다.
문서 1 → 요약 1
요약 1 + 문서 2 → 요약 2
요약 2 + 문서 3 → 최종 요약
각 단계가 직전 요약을 필요로 하므로 순차 의존성이 생긴다. Map처럼 모든 문서를 독립적으로 처리하기는 어렵다.
장점은 이전 내용을 보며 새 내용을 반영할 수 있다는 점이다. 하지만 모든 내용을 반드시 보존한다는 보장은 없다. 뒤의 문서가 초기 결론을 덮어쓰거나 요약이 점점 길어질 수 있고, 초기에 생긴 오류가 남을 수도 있다. 자료 순서와 갱신 지침, 요약 길이를 함께 관리해야 한다.
3.3 요약 방법의 선택
| 방식 | 처리 흐름 | 장점 | 주요 한계 |
|---|---|---|---|
| Stuff | 자료를 한 프롬프트에 넣음 | 단순하고 자료 사이를 함께 볼 수 있음 | 문맥 예산과 긴 입력의 활용 한계 |
| MapReduce | 부분 요약 후 통합 | 독립 처리와 병렬화가 쉬움 | 청크 간 관계와 세부 정보 손실 |
| Refine | 현재 요약을 자료마다 갱신 | 앞선 내용을 보며 새 자료 반영 | 순서 의존성과 누적 오류, 순차 지연 |
문맥 창이 크더라도 요약 목적은 남는다. 전체를 다 넣는 비용과 필요한 정보의 위치, 문서 구조를 함께 봐야 한다.
법률 조건이나 실험의 예외처럼 빠뜨리면 의미가 바뀌는 내용은 짧은 최종 요약만으로 검증하기 어렵다. 원문의 핵심 사실 목록과 요약 결과를 비교하거나 중요한 문장을 출처와 연결해 남길 필요가 있다.
질문
Reduce에서 원문의 누락을 보완할 수 있을까?
부분 요약에 해당 내용이 없다면 보통 어렵다. Reduce가 받은 정보 안에서만 통합할 수 있기 때문에 Map 단계의 정보 보존이 중요하다.
Refine이 MapReduce보다 항상 정확할까?
다른 정보를 보며 갱신한다는 장점은 있지만 순서와 길이, 모델의 요약 품질에 영향을 받는다. 목적에 맞는 사실이 유지되는지 직접 비교해야 한다.